DeepSeek网页端加入额度限制,谷歌Gemini 4 Hydrogen发布
DeepSeek网页版测试额度提示,谷歌开放Gemini 4 Hydrogen,英伟达CEO黄仁勋辞职。
本期AI晚报汇总了多项产品与行业动态。DeepSeek网页版代码中已加入模型额度状态查询与超额处理逻辑,但尚未对所有账号限额;谷歌正式开放Gemini 4 Hydrogen,定位日常编程与智能体任务,速度据称为Gemini 3.8 Flash的2.5倍,支持100万tokens上下文。英伟达宣布黄仁勋辞去总裁、CEO和董事职务,CFO克莱特·克雷斯任临时CEO。其余更新涵盖DeepSeek Harness候选版、Thinking Machines开放模型权重、OpenAI企业安全产品、Cloud Code与Meetings、Anthropic自托管智能体、SpaceX算力园区计划、多笔融资与硬件发布,以及多家公司的新模型和工具。
11月13日的AI晚报带来了多项重要更新:DeepSeek网页版开始加入模型额度状态查询,谷歌正式开放Gemini 4 Hydrogen,英伟达CEO黄仁勋宣布辞职,以及多款AI工具和模型的新进展。
DeepSeek网页端加入额度限制,但尚未全面实施
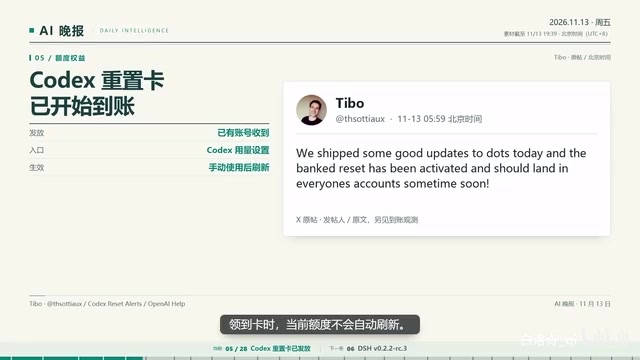
据B站UP主报道,DeepSeek广告网页版新版本代码中已经加入了模型额度状态查询功能。当用户触及使用上限时,页面会提示等待额度恢复后再尝试发送消息,同时上传文件也有了对应的超额处理逻辑。这表明网页端已经做好了额度提示的技术准备,但并不意味着所有账号已经开始被限额。具体的额度规则和恢复机制尚未确认。
这一变化可能预示着DeepSeek正在为更精细化的资源管理做准备,尤其是在用户量快速增长的情况下,通过额度限制来平衡服务负载是常见的做法。不过,目前尚不清楚这是否会影响到免费用户的日常使用。
谷歌Gemini 4 Hydrogen正式开放,定位日常编程与智能体
谷歌此前预告的Gemini for Hydrogen现已正式开放。谷歌将其定位为面向日常编程和智能体任务的快速模型。根据谷歌的测试,Gemini 4 Hydrogen完成任务的速度是Gemini 3.8 Flash的2.5倍。开发者现在可以通过AI Studio和Gemini API使用该模型,上下文长度为100万tokens,定价为每百万输入tokens 1.5美元,输出7.5美元。
这一发布进一步丰富了谷歌的模型矩阵,为开发者提供了在速度和成本之间取得平衡的新选择。尤其是智能体应用场景,对响应速度要求较高,Gemini 4 Hydrogen的快速特性可能使其成为理想选择。
上下文窗口与token定价:大语言模型的“上下文长度”(context length)指模型单次推理可容纳的输入加输出token总量,100万tokens大致相当于数十万汉字或数百页文档,使模型能一次性吞下整个中型代码仓库或多份长报告。API按token计费是业界通行做法,输入tokens指送入模型的提示与上下文,输出tokens指模型生成的回复,二者通常单价不同且输出更贵,因为解码阶段逐token生成更消耗算力。按文中定价换算,处理100万tokens输入约1.5美元、生成100万tokens输出约7.5美元,输出价格是输入的5倍,这一比例在主流厂商中较为常见,反映了推理成本结构。开发者评估模型性价比时,需结合任务中输入与输出的比例估算实际开销,长上下文检索类任务成本更多落在输入侧。
英伟达高层变动:黄仁勋辞去CEO职务
英伟达宣布,黄仁勋已辞去总裁、首席执行官和董事职务,即时生效。现任首席财务官克莱特·克雷斯出任临时首席执行官,并继续担任财务负责人。董事会已开始从公司内外寻找正式接班人。这一突然变动引发了业界广泛关注,英伟达作为AI芯片领域的领头羊,其领导层更迭可能对公司的战略方向产生影响。
智谱新模型传闻:KingBench 4榜单引发猜测
一张KingBench 4榜单图片引发了对智谱新模型的猜测。原图中只能识别出Pro、Mad和Small几个后缀,而网传的GLM Nano名称和分数来自另一张推测图。智谱官方尚未确认这些信息。此类传闻在AI社区中常见,但需谨慎对待,等待官方消息。
其他重要更新
DeepSeek Harness 0.2.2 rc3发布
DeepSeek Harness发布了0.2.2的第三个候选版本(rc3)。新版本加入了一个实验性插件,可以将DeepSeek App或网页版的历史绘画导入工作区,方便用户继续之前的对话。此外,该版本还修复了Windows桌面版有时更新失败或更新后未能自动重新打开的问题。
Thinking Machines开放Inkling 2 Small权重
Thinking Machines开放了Inkling 2 Small的权重,采用Apache 2.0许可。此前该模型主要通过Tinker平台使用,现在开发者可以下载权重自行部署。这降低了使用门槛,促进了模型的可及性和二次开发。
开放权重与Apache 2.0许可:“开放权重”(open weights)指厂商公开发布训练好的模型参数,开发者可下载后自行部署、微调或蒸馏,这与仅提供API调用的闭源模式不同,也不等同于公开训练数据和代码的完全开源。Apache 2.0是宽松型开源许可,允许商业使用、修改与再分发,只要求保留版权与许可声明,且不强制衍生作品采用相同许可,对企业二次开发较为友好。相比之下,部分模型采用的自定义许可会附加用户规模或用途限制。开放权重降低了推理成本与数据出境顾虑,使模型可在本地或私有云运行,但也意味着厂商失去对模型使用的直接管控。
OpenAI发布企业安全产品
OpenAI发布了两款面向企业的安全产品:Daybreak Defense Factory和Daybreak Red Team。前者可以将发现的安全问题转化为供团队审查的补丁,后者则面向企业的授权安全评估。这显示了OpenAI在企业安全领域的进一步布局。
Cloud Code更新至2.1.323
Cloud Code更新到2.1.323版本,加入了默认关闭的Code Mode。开启后,Cloud可以编写JavaScript来调用工具。新版还会根据Cloud Code的版本筛选兼容插件,避免加载不兼容的版本。
Cloud Meetings开始测试
Cloud Meetings开始向Team和Enterprise套餐推出测试,首批支持Google Meet。将Cloud邀进会议后,团队可以当场请它写文档、做白板,结束后纪要、待办和产物会留在会议页面。
Anthropic开放Cloud Manage Agents自托管
Anthropic开放了Cloud Manage Agents的自托管私册,符合条件的企业可以将运行服务、沙箱和绘画记录放到自家云或本地机房,模型请求仍发给团队选择的服务方。这满足了企业对数据隐私和合规性的需求。
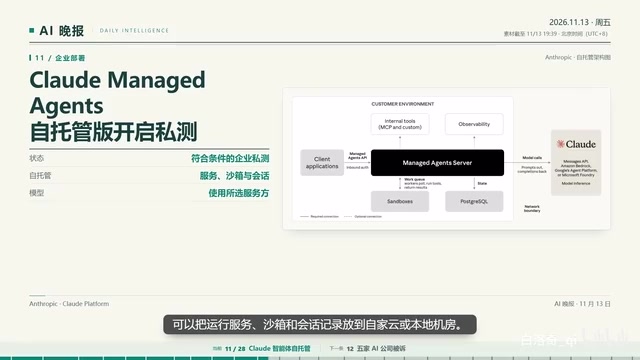
智能体(Agent)与沙箱:智能体指由大模型驱动、能自主规划步骤并调用工具(写文件、执行代码、检索网页等)来完成多步任务的系统,与单轮问答不同,它往往需要持续运行较长时间并保留执行轨迹。“沙箱”(sandbox)是为这类执行提供的隔离环境,使模型生成的代码和工具调用在受限容器内运行,避免影响宿主系统或泄露数据。自托管意味着企业把运行服务、沙箱和会话记录部署在自有云或本地机房,只有模型推理请求仍发往模型服务方,从而在满足合规与数据驻留要求的同时保留模型能力。这种“控制面自持、推理面外发”的混合架构,是当前企业采用闭源前沿模型时常见的折中方案。
非营利组织起诉多家AI公司
四家非营利组织起诉Anthropic、谷歌、Meta、OpenAI和SpaceXAI,请求法院限制部分先进人工智能系统的开发。这是速方提出的请求,法院尚未下令叫停。
SpaceX公布AI算力园区计划
SpaceX公布了两座AI算力园区计划,拟投资超过740亿美元。德克萨斯州项目超过240亿美元,亚利桑那州项目约500亿美元,后者仍需当地审批。
中国AI模型权重初始化痕迹报告
Unemployment Labs的报告称,六款中国AI模型的公开权重带有与英伟达Blackwell芯片相符的初始化痕迹。这可以提示权重可能在哪类硬件上生成,但还不足以证明完整训练过程、训练地点或是否违规。
Sarabras财报披露与微软云推理协议
Sarabras在财报中披露了与微软的云推理协议执行人寿协议条件约束,公司第三季度营收创下新高,达到2亿1080万美元,同比增长55%。
Mirindio完成10亿美元A轮融资
面向科学研发的智能体公司Mirindio宣布完成10亿美元A轮融资。公司现在把研发流程做成了产品Lore,可协助写代码和跑实验,目前还在四测。
谷歌和三星合作Gemini智能眼镜接受预购
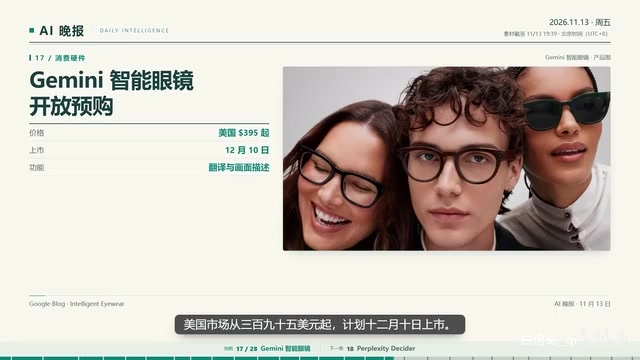
谷歌和三星合作的Gemini智能眼镜开始接受预购,美国市场从395美元起,计划12月10日上市。戴着眼镜可以让Gemini翻译、对话或描述摄像头看到的东西。
Perplexity推出Decider V13和Flash V1.3
Perplexity推出Decider V13和更轻量的Flash V1.3两款模型,都开放权重。新增的Locate功能能按指令从输入里定位并提取一段内容,现在也可以通过Decisions API调用。Replay Agent新增采购和广告投放功能,美国的Core和Pro用户可用Link和Visa采购,全球Pro用户可以通过它创建Google广告,付款和正式投放前都要用户批准。
World Labs开放Atlas工具站Viewfinder
World Labs开放Atlas工具站Viewfinder,可以从图片重建场景再生成新视角。Chazel用于搭建和编辑三维几何,也能把画面渲染出来。开发者可以通过接口接入相同的能力。
字节Cdream 5上线
字节的Cdream 5以上线,File提供生图和编辑接口,可以连续几轮修改同一张图,直接改图里的文字也能用Layerize把图片拆成独立图层。
Runway支持Triple H 3.1生成三维模型
Runway现在支持用Triple H 3.1按文字或图片生成三维模型,也能上传自己的GLB文件,选好角度后可以作为生成下一张图片或视频的参考,还能把模型导出去。
Expo推出云端模拟器
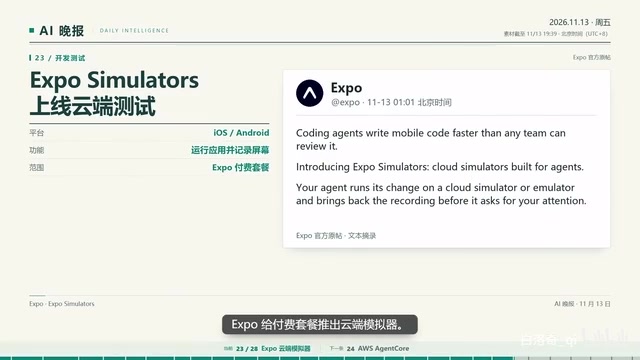
Expo给付费套餐推出云端模拟器,编码助手可以在云端安装并测试iOS或Android应用,把录屏留给开发者。
AWS将新版Amazon Bedrock Agent Core Runtime设为默认
AWS把新版Amazon Bedrock Agent Core Runtime设成新建环境的默认运行时,AWS称新运行时的绘画启动最高可快15倍,已有环境不在这次默认值变更的范围内。
Salesforce开放语音转录模型SOV Transcribe 1
Salesforce开放了语音转录模型SOV Transcribe 1的权重,按Artificial Analysis的非流式评测,它的词错误率是2.3%,排在该榜开放权重模型第一。
Lama Index发布文档解析评测Parse Bench 2
Lama Index发布文档解析评测Parse Bench 2,细分330多种错误,还加入了表单。同日推出OCRER 1.5用于在Lama Parse里解析文档的评测以及复杂表格和表单。
Arena.ai提出让评审模型实际操作网页应用
Arena.ai提出让评审模型实际操作网页应用再给应用打分,团队开放两套数据:一套有6390组带人类偏好的应用配对,另一套记录人类核实过的功能要求。
DeepSeek V4OnePro传闻
最后是DeepSeek V4OnePro的传闻,网传线索来自Verso Labs的一次公开提交,代码里只出现了一个代号用来测试模型列表的排序。DeepSeek尚未正式发布这款模型。
以上就是今日AI资讯的全部内容,感谢收看。
基准测试与评测可信度:文中多处出现榜单与评测,如KingBench 4、Artificial Analysis、Parse Bench 2,理解其性质有助于判断信息价值。基准测试(benchmark)是用固定题目集衡量模型能力的标准化评测,不同榜单的题目构成、评分方式和更新频率差异很大,分数高不一定代表在真实任务中更强。此外,模型名称与分数在官方发布前常通过截图、代码提交或社区推测流出,此类传闻可能来自误读或拼接,应视为待证实信息。阅读评测结论时,宜关注评测是否公开方法、是否区分开放权重与闭源模型、以及是否报告错误类型细分。
相关推荐

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。