DeepSeek新版本实测:价格不变成本暴降60%

DeepSeek v4.1 Flash 1017架构价格不变,靠缩短输出Token把任务成本降约2.5倍。
DeepSeek v4.1 Flash 1017是一次“minor update”:架构、权重体积、价格均与9月版本一致,但完成同一DeepSWE任务的成本降低约2.5倍,low档以约11美分击败旧版high档的29美分。降本核心不在输入而在输出——输出Token仅占总Token量约2%却占账单约47%,缓存读取占输入93%但只占成本约11%,因此模型“少说话”成为最大杠杆。机制上,DeepSeek在强化学习中引入1到100的effort等级与指数衰减的长度惩罚,奖励只在同等级内比较,API将low/high/max映射到50/75/100。11项基准全胜,但存在测试框架不一致、基线偏差、竞品非最新型号等折扣。对本地部署者而言,Token效率比API省钱更重要,可省数小时;但MoE专家必须驻留高速内存,DGX Spark四台约27800美元。
DeepSeek v4.1 Flash 1017 发布后,海外技术博主拆解了这份"minor update",发现了一个被多数报道忽略的细节:架构没变、价格没变,但完成同一个DeepSWE任务的成本降了约2.5倍。省下来的钱从哪来?答案藏在后训练策略和Token经济学里。
版本命名与产品定位:日期即版本号
1017只是一个日期——10月17日。DeepSeek广告的迭代节奏相当清晰:先发布新架构,随后几个月用新的后训练持续打磨同一架构。4月发布v4 Flash预览,7月底推出v4 Flash 0731(同架构同尺寸,训练更充分),9月v4.1 Flash带来因果编码器-解码器和NGRAD记忆机制,五周后1017作为同一模型的"更锐利、更高效"版本出现。
DeepSeek称其为"minor update that delivers substantial improvements"。听着像公关话术,但博主认为这是对该版本最准确的描述。权重仍在Hugging Face以MIT许可发布,48个文件共约510GB,与之前一致。API侧如果一直在调用DeepSeek Flash,已经自动切到1017,旧模型名被退休并静默路由到1017。上下文窗口100万Token,最大输出384,000 Token,视觉实验模型已并入,图片和代码走同一个模型。
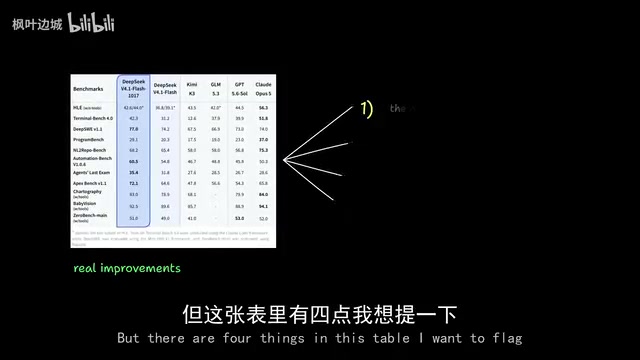
11项基准全胜,但4个细节需要打折扣
DeepSeek公布了11项基准,1017全部超越前代:Tools从36.8升至42.6,DeepSWE从74.2升至77.0,ProgramBench从20.3跃至29.1,最大单项涨幅是TerminalBench 4.0的31.2到42.3,整整11个点。
不过博主提醒有四个细节值得注意。第一,测试框架不同:1017的TerminalBench在ClaudeCode框架内运行,9月基线却在DeepSeek框架内,而同一模型在不同框架下DeepSWE曾出现65.5与74.2的近9分差距,所以最大涨幅也带着最大的星号。第二,Artificial Analysis自行测试旧版Flash的TerminalBench只得到26.8%,而非31.2%,基线可能更低。第三,竞品对比用的是Opus 5和GPT 5.6 Sol,而非最新型号;Opus 5.5在TerminalBench上得分66.4%,高出新模型24分,GPT 6.1 Sol在DeepSWE上以75.2%略微领先。第四,旧模型NL2 repo分数在9月卡片上是64.0,新表里却是65.4,说明并非所有列都在相同条件下重跑。
DeepSeek在技术报告中承认基准对齐不等于模型在 hardest edge cases 上匹配闭源前沿,博主对此表示respect。
成本暴降的真正来源:输出Token变短了
多数视频说DeepSeek没给输出缩短的具体数字,但博主指出数据就藏在发布帖的一张图里。这张图展示DeepSWE通过率与单任务平均成本的对数关系:新模型在max档得分77%、成本约20美分,比旧模型便宜2.5倍且分数更高。更关键的是low档——得分约72.6%、成本约11美分,直接击败旧模型high档的70.2%和29美分。新模型最便宜的模式以不到一半的价格打赢了旧模型的中档。
输入Token呢?OpenRouter过去30天数据显示,旧版Flash处理了约122万亿Prompt Token,但只有2.2万亿Completion Token,比例约55:1,且大部分Prompt是缓存命中。但一旦给每类Token定价,画面完全变了:缓存命中每百万Token 0.3美分,输出Token每百万60美分,相差200倍。按DeepSeek标价计算10月16日单日流量,输出Token只占总量约2%,却占账单约47%;未缓存输入占约42%;占输入Token 93%的缓存读取只占成本约11%。
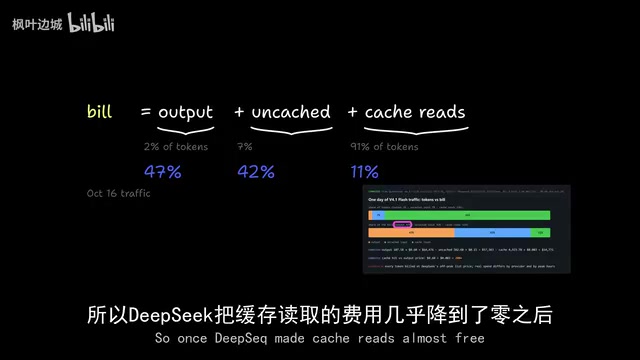
所以当缓存读取几乎免费后,账单上最大的杠杆就是模型说多久。还有一个二阶效应:输出越短通常意味着Agent循环轮次越少,而每一轮都要从缓存重读整个上下文,短输出进一步压缩输入循环。
缓存命中与未缓存输入的定价差异是理解Token经济学的关键。大模型API通常对输入Token区分“缓存命中”与“未缓存”:前者指与之前请求重复的前缀(如系统提示、长上下文、工具定义),服务商可复用KV Cache,无需重新计算,因此定价极低;后者需完整前向计算,价格较高。DeepSeek的定价中缓存命中仅为输出Token的1/200,这使得Agent场景下反复重读同一上下文的成本几乎可忽略。但缓存有生命周期(通常几分钟到几小时),且只有严格前缀匹配才命中,因此多轮Agent循环中保持上下文稳定、避免频繁改动系统提示,是压低账单的实用技巧。
可控推理强度:用长度惩罚让模型少说话
架构一个参数没动,模型怎么学会少说话?答案在技术报告的"Controllable Reasoning Effort"一节。强化学习期间,DeepSeek在系统提示中写入1到100的effort等级,奖励中包含长度惩罚——生成的推理Token越多扣分越多,但惩罚随effort等级指数级缩小。低effort下每个额外Token都会被扣分,高effort下则宽容得多。类比一下:短答题超字数扣分,论文则允许长。
更巧妙的是奖励只在同一effort等级内比较,短而低effort的回答永远不会被拿去和思考十倍的max effort回答比。API直接映射这套刻度:low对应50,high对应75,max对应100。针对1017,DeepSeek只说用了带自我反馈的强化学习,没细说奖励改了什么。博主的推测是加大了长度压力,也许奖励模型"检查一次而非五次",正好针对9月被诟病的过度思考习惯。
强化学习中的长度惩罚是一种奖励塑形手段:在策略梯度或偏好优化目标里,对生成序列的Token数施加负向项,引导模型在保持正确率的前提下压缩推理链。常见形式包括对总长度线性扣分、对超出预算部分截断式惩罚,或如DeepSeek这样让惩罚系数随effort等级指数衰减,从而在低档位强力抑制啰嗦、在高档位保留长思维链空间。难点在于惩罚过强会导致模型跳过必要步骤、正确率骤降,因此通常需要与正确性奖励做多目标平衡,并在同一effort桶内做相对比较(类似分组归一化),避免短答案与长答案直接竞争造成奖励尺度错配。
实测反馈与本地部署启示
早期反馈是混合的。每天首发测试DeepSeek模型的Teotaxes表示1017在任务前90%大幅提速,但临近终点容易钻牛角尖打磨细节,需要人盯着收尾。长度惩罚起了作用,但没完全治愈。
更大的图景是:这个版本针对的其实不是API成本,而是时间问题。Bartz Lodiczka用同一批构建对比旧版Flash和GPT-6 Astra,DeepSeek便宜得多,但耗时4小时14分钟对47项测试。World of AI认为最大问题是过度思考和跑不必要的测试。Token/秒没变,因为架构和投机解码都没变,想更快只能少花Token。
本地部署时Token效率更重要。架构与9月v4.1 Flash完全相同,51B激活、552B骨干参数、40层、384个专家,配置文件一字未改,能跑旧版的硬件就能跑新版。专家已是FP4(每参数4bit),常规4bit量化帮助不大;Engram记忆表可放SSD(每Token只读约12KB),但专家不行——路由器每层从384个专家中选6个,且每个Token选的不同,必须驻留高速内存。DGX Spark单台128GB统一内存、273GB/s带宽装不下专家,社区通常4台组512GB,售价已从3999美元涨到约6950美元,四台约27800美元不含网络。
API上Artificial Analysis测旧版Flash约176 Token/秒,Intelligence Index任务用掉的88,000输出Token约8分钟;家用40 Token/秒则要37分钟。若1017真用一半输出,每任务能省约18分钟——API上只省几分钱,家里一天Agent跑下来省的是几个小时,经济学完全不同。
MoE模型的本地部署瓶颈主要不在算力而在内存带宽与容量。以40层、每层384专家、每Token激活6个的稀疏结构为例,路由是逐Token逐层动态的,不同Token命中的专家集合几乎不重叠,因此无法像稠密模型那样只加载部分层;所有可能被选中的专家权重都必须常驻高速内存(HBM或统一内存),否则每次换出换入都会拖垮吞吐。FP4量化已把每参数压到4bit,进一步4bit量化的边际收益很小,真正的约束是容量。Engram类记忆表可按Token流式从SSD读取,因为访问模式可预测、每Token数据量小;专家则相反,随机性强、单次读取量大,SSD延迟无法掩盖。这就是多台大内存设备组集群成为消费级方案的原因。
模型+框架协同设计的新信号
1017针对DeepSeek Harness 0.1+和腾讯CodeBuddy优化。同一天DeepSeek开放搜索与抓取API,每千次0.75美元,10月31日前通过DeepSeek Harness、Cloud Code和Codex免费。技术报告直言模型与框架将协同演进——能力单元不再只是模型,而是模型加框架。怀疑者会指出只在自家框架里表现好的模型让人不敢依赖,9月模型跨框架已有9分摆动,若新版针对自家脚手架调得更狠,摆动可能更大,这也是TerminalBench换框架值得关注的原因。
Artificial Analysis Intelligence Index上旧版Flash为39.5,GPT 6.1 Sol为51.8,Opus 5.5为57.6,新版暂无独立数据。DeepSeek并未声称追平,而是给出更窄更诚实的承诺:1017用更少Token做同样的活。
还有一个地缘时间点:发布前一天,中国商务部和科技部拟将23项AI技术列入出口限制清单,包括大模型、Agent和计算集群,已开源技术除外且开源可快速获许可,所以1017已经出门,但下一个大版本能否同样顺利是开放问题。
博主最后写道:上个月说仅靠成本效率站不住脚,1017是DeepSeek第一次在不碰架构不碰价格的前提下把Token效率垫到那条腿下面,机制也漂亮。但智能仍是缺失的那条腿。历史经验是更便宜的任务不会让我们少花钱,而是会跑更多任务。真正值得等的是能把这种效率带到一个真正更会思考的V4.1 Pro,以及整个乐于为长思维链收费的行业是否会被迫让模型少说话。
**模型与框架协同设计(co-design)**指模型训练与推理脚手架联合优化:框架决定工具调用格式、上下文组织、重试与校验逻辑,模型则针对这些模式做后训练,从而在自家框架内取得最佳成绩。好处是端到端效率高、Agent任务完成率提升;风险是评测迁移性下降——同一模型换到ClaudeCode、Codex等第三方框架,提示格式与工具schema不匹配,分数可能明显波动。业界因此越来越强调在多个中立框架下报告基准,并区分“模型能力”与“模型+框架系统能力”。对使用者而言,选型时应优先看目标框架内的实测数据,而非厂商单一框架下的榜单。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。