DeepSeek新模型实测对比:日式都市集群生成谁更强?

UP主横评多模型生成日式都市集群,DeepSeek Flash新检查点仅次于Opus 5.5。
B站UP主用同一提示词让多个主流大模型生成超大规模日式现代都市集群,横向对比成图质量。新版DeepSeek Flash(1017检查点)思考近一小时,成品被评「非常惊艳」,仅路面立交桥布局有小bug,是除Opus 5.5外表现最好的模型;Opus 4.5接近满分。竞品则普遍翻车:GLM 5.3屏闪并出现列车穿模,Kimi K3被疑降质,千问3.8 Flash与旧版DeepSeek Flash均为半成品,谷歌Gemini 4生成的是复制粘贴式小场景、规模不达标。作者指出单一提示词测试样本有限,结论需自行复测验证。
DeepSeek 推出新检查点(内部称 1017 版 Flash)后,B站一位 UP 主第一时间做了横向对比测试:用同一个提示词让多个主流大模型生成「超大规模的日式现代都市集群」,再逐一比对成图质量与细节。结论很直接——新版 DeepSeek Flash 是这次测试里除 Opus 5.5 之外表现最好的模型,而多个竞品则出现了不同程度的翻车。
测试设计:一道复杂场景的「照妖镜」
测试提示词要求生成一个超大规模的日式现代都市集群,属于对空间布局、建筑密度、道路结构和行人车辆细节综合考验的任务。UP 主提到,DeepSeek广告 Flash 在这一项上思考时间很长,整体耗时接近一小时,最后是催促它尽早交付才拿到结果。
这种「慢」本身值得注意:长思考意味着模型在生成前做了更多的结构规划,而这类复杂场景恰恰最怕模型「想得少、画得快」。对比之下,部分竞品出图快但成品完成度低,正好形成反差。
文中所说的「检查点」(checkpoint)是模型训练过程中的一个中间快照。大模型在训练时会定期保存权重状态,每个检查点代表模型在某一时刻的能力水平。厂商有时会在两次正式版本发布之间,用新检查点做小范围或灰度更新,因此同一个模型名称下的实际表现可能随检查点变化而波动。这也解释了为什么文中强调「1017 版」——它是区分新旧 DeepSeek Flash 的关键标识,而非一次完整的版本号升级。
「屏闪」通常指视频或逐帧生成类模型在连续帧之间出现亮度、纹理或结构的不稳定跳动,导致画面闪烁。它往往源于帧间一致性建模不足,在生成动态场景时尤为明显,是衡量视频生成质量的一个直观指标。
DeepSeek Flash 新检查点:惊艳但有瑕疵
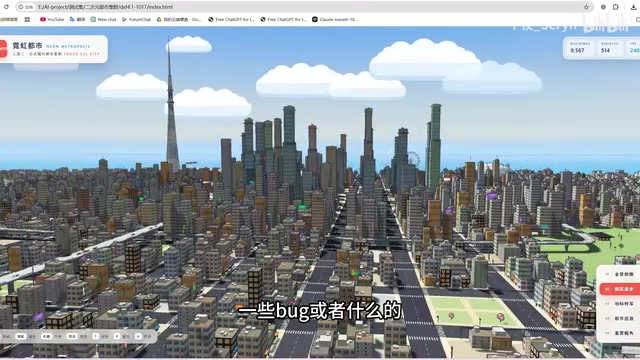
新版 DeepSeek Flash 的成品被 UP 主评价为「非常惊艳」,画风效果没有明显毛病,街道和行人的处理都到位。唯一的疑点是路面上叠了一座立交桥,属于布局上的小 bug。
但 UP 主强调,这个瑕疵要放在对比语境里看——它是本次测试中除 Opus 5.5 外最强的结果。换句话说,小 bug 存在,但整体完成度和审美水准明显领先同场其他模型。
竞品横评:谁翻车了,谁稳住了
中游梯队:能看但不出彩
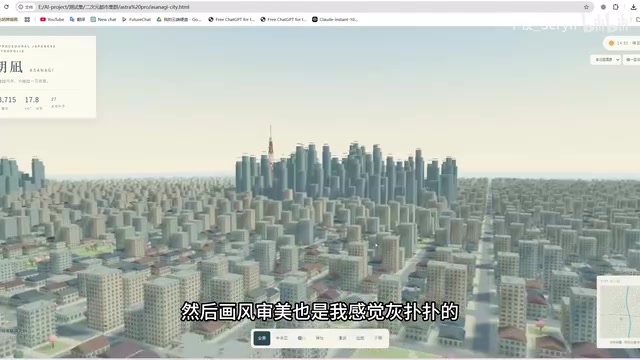
6.1 版模型生成的场景里几乎看不到行人和车辆,建筑之间差异很小,审美也不如新版 DeepSeek Flash 的 1017 检查点。Astra Pro 则出现屏闪问题,画风偏灰、观感不佳。
明显翻车:半成品与穿模
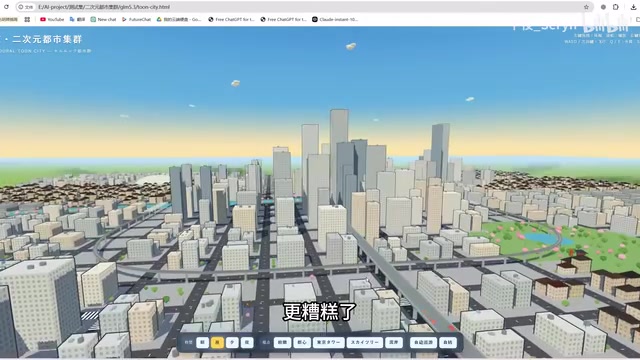
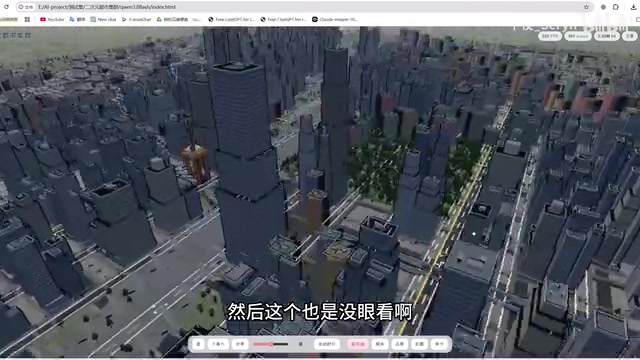
旧版 DeepSeek Flash(1017 之前)被直接判定为「去了」:车辆移动方式不对,整体布局不行,属于没做完的半成品。GLM 5.3 的问题更严重,不仅屏闪,列车还出现横移穿模,表现非常糟糕。
Kimi K3 的表现让 UP 主怀疑是近期降质,成品「完全去了」,直接跳过。千问 3.8 Flash 同样是半成品级别,没法看。谷歌 Gemini 4 的问题则是规模不对——生成的是复制粘贴式的小场景,根本算不上「独自集群」。
「穿模」是三维图形与生成式视觉中的常见术语,指两个本应分离的物体在空间上相互穿透、重叠,例如列车横向移动时直接穿过建筑或轨道。它暴露的是模型对物体空间位置和物理约束的理解不足——模型只学到了局部像素的合理外观,却没有建立起全局一致的三维结构关系。在复杂城市场景中,物体数量多、遮挡关系复杂,穿模和布局错位最容易集中出现。
稳住的选手
Opus 4.5 基本是满分答卷,UP 主评价「确实强大」。这也解释了为什么新版 DeepSeek Flash 的定位是「除 Opus 5.5 外最强」——它挤进了第一梯队,但没有完全追平最强的那一档。
这份测试说明了什么
单一提示词的测试当然不能代表模型全能,但复杂场景生成确实能暴露模型在空间推理和细节一致性上的差距。这次对比透露出两个信号:
一是 DeepSeek Flash 的新检查点在复杂布局任务上有实质提升,审美和完成度都上了一档;二是部分模型的「降质」疑云值得关注,Kimi K3 的表现被 UP 主直接归因于近期质量下滑,这类波动对依赖稳定输出的开发者影响不小。
需要提醒的是,以上结论来自单一 UP 主的单次测试,样本有限,且提示词、参数设置等细节未完全公开。想验证的话,最好自己用相同提示词跑一遍。UP 主也表示后续会做其他方面的测试。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。