DeepSeek养鱼必装5个活人插件:解决烧token、信息过时、废话多
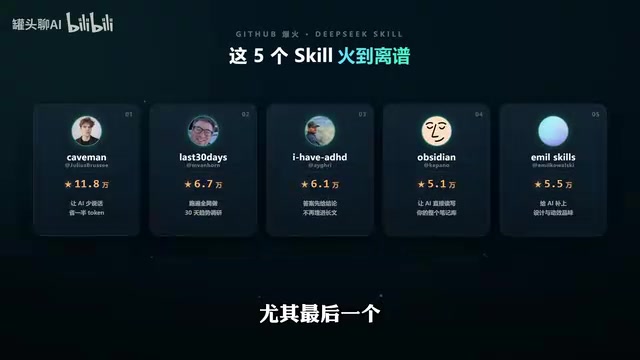
B站UP主分享五个skill插件,分别解决大模型烧token、信息过时、废话多、毁笔记结构和审美差五大痛点。
文章介绍了B站UP主「大肥鱼」分享的五个DeepSeek skill插件,分别针对大模型使用中的高频痛点:凯曼插件自动压缩重复日志内容、只保留关键报错以降低token消耗;last3odays同时检索GitHub、Reddit和YouTube近期讨论,解决信息过时问题;I have adhd强制模型按「改哪、怎么改、怎么验证」的简洁结构输出;obsidian skill按原格式保留双链、属性和画布结构,支持批量处理笔记;emilkawaski设计skills统一排版配色与移动端适配规范。文章指出五个插件的共同逻辑是:当前大模型的能力短板多在工作习惯层面而非智力层面,skill机制将领域最佳实践固化为可复用规则,装一次长期生效。
用DeepSeek这类大模型干活,最让人血压升高的时刻往往不是它答不上来,而是它用极其认真的态度做了一件让你想摔键盘的事:查个bug没找到问题token先烧掉一大截、搜个新工具给你翻出三年前的教程、改一行代码先写八百字思想汇报。B站UP主「大肥鱼」分享的五个skill插件,恰好对准了这些高频痛点。
这五个插件分别覆盖token消耗、信息时效、回答风格、笔记结构、前端审美五个方向,思路不是让模型更聪明,而是让它更像一个懂规矩的干活搭子。
一、凯曼:专治无脑烧token
几千行日志扔进去,问题没定位到,钱包先被掏空——这是很多人用大模型排查故障时的真实体验。大量日志里真正有用的往往只是那几行关键报错,其余都是重复和噪音。
UP主提到的「凯曼」插件做的是自动压缩重复内容,只保留关键报错信息。据其描述,装上之后模型会少说废话,不再把上下文窗口当成无限自助餐。这个思路的价值在于:token消耗和回答质量并不总是正相关,喂进去的冗余信息越多,模型越容易被带偏,反而错过真正的错误线索。先做信息提纯再让模型推理,既省钱也更准。
Token 与上下文窗口是理解「烧 token」问题的前提。Token 是模型处理文本的基本单位,一个汉字通常对应 1~2 个 token,英文单词约 1.3 个 token。模型的上下文窗口有硬性上限(如 128K token),超出部分会被截断或需要分段处理。更重要的是,计费按 token 数量计算,输入输出都算钱。把几千行日志全塞进去,不仅费用高,还会稀释关键信息在注意力机制中的权重——模型对长上下文中间部分的召回率天然偏低(即「lost in the middle」现象)。因此,先压缩冗余、只保留关键报错,本质上是在做信息提纯,让有限的上下文窗口承载更高密度的有效信号。
二、last3odays:专治信息考古
让AI推荐一个新工具,结果给你翻出三年前的教程——这种「考古式回答」在追热点场景下几乎是致命的。模型的知识截止时间决定了它天然不擅长回答「最近有什么新东西」。
「last3odays」插件的做法是同时搜索GitHub、Reddit和YouTube的近期讨论,把多个平台的最新动态汇总后再交给模型整理。据B站UP主的说法,别人还在满世界找选题,用上这个skill的人已经开始剪视频了。多源检索的意义不只是快,更在于交叉验证:单一平台的热度可能失真,GitHub上的代码活跃度、Reddit上的真实讨论、YouTube上的实操演示放在一起看,才能判断一个工具是真火还是虚火。
知识截止时间(knowledge cutoff) 是大模型无法回避的局限:训练数据有固定截止日期,模型对之后发生的事情一无所知,且不会主动声明「我不知道最新情况」。检索增强生成(RAG)是常见的补救手段,但普通联网搜索往往只返回单一来源的摘要。last3odays 的做法更接近多源实时检索:同时查询 GitHub(代码活跃度)、Reddit(社区讨论热度)、YouTube(实操演示)三个平台,再将结果交给模型整合。这种交叉验证能有效过滤单一平台的刷量或过时信息——GitHub 的 commit 频率反映项目是否仍在维护,Reddit 的讨论质量反映真实用户反馈,YouTube 的演示则验证工具是否可落地。
三、I have adhd:专治废话连篇
让模型改一行代码,它先写八百字思想汇报,前因后果讲完,bug还在原地躺着。这段吐槽大概戳中了不少人。模型倾向于展示「我理解得很全面」,但对使用者来说,有用的信息只有三件事:改哪里、怎么改、怎么验证。
「I have adhd」插件直接加入简洁回复规则,强制模型按「先说改哪、再说怎么改、最后告诉你怎么检查」的结构输出。花钱请它干活,不是请它来竞选部门经理的。这类风格约束看似简单,实际收益很高——在反复迭代的开发流程里,每次省下的阅读时间会累积成可观的效率差。
系统提示词(system prompt)与风格约束是这类插件的技术基础。大模型默认倾向于「全面展示理解过程」,因为训练数据中高质量回答往往附带推理步骤。但在工程场景下,这种默认行为会造成信息过载。通过系统提示词强制模型遵循「改哪里→怎么改→怎么验证」的三段式结构,本质上是把输出格式契约前置到对话开始前,而非事后逐句纠正。相比每次手动写一大段提示词,skill 机制将这类约束固化为可复用配置,在反复迭代的开发流程中显著降低沟通成本。
四、obsidian skill:专治笔记库崩坏
辛辛苦苦攒起来的Obsidian知识库,让模型整理一下,双链断了、属性飞了、画布结构乱了,现场跟台风过境一样。原因是模型并不天然理解Obsidian的格式约定,它会用自己认为合理的方式重写内容,结果破坏了原有的链接和元数据。
这个skill让模型按照Obsidian原来的格式处理内容,双向链接、笔记属性、画布结构都照原样整理。据UP主描述,以前整理一份笔记库得折腾半天,现在可以让模型按规矩批量处理几百篇笔记。对重度笔记用户来说,「不破坏原有结构」比「整理得多漂亮」重要得多,因为知识库的价值恰恰建立在链接关系之上。
Obsidian 的格式约定包括双向链接([[笔记名]])、前置属性(YAML frontmatter)、画布(Canvas)的 JSON 结构等。这些格式对模型来说并非天然可理解——模型倾向于用通用 Markdown 重写内容,容易破坏 [[ ]] 链接语法、丢失 frontmatter 字段、或把画布结构改写成普通文本。obsidian skill 的核心价值在于格式保持(format preservation):让模型在整理内容时严格遵循原有语法规范,只做内容层面的优化,不触碰结构层。对于依赖链接关系构建知识图谱的重度用户,这比「整理得漂亮」重要得多。
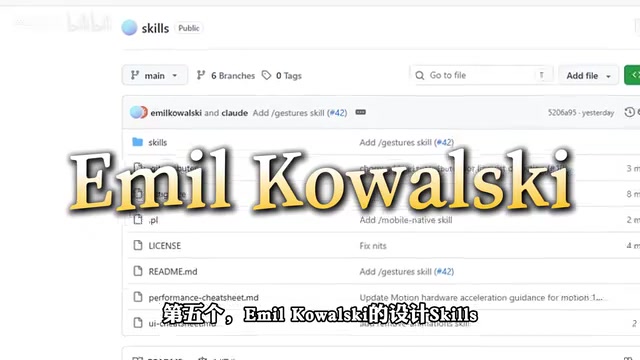
五、emilkawaski设计skills:专治审美掉线
让模型做个网站,它确实能三分钟交差,但成品怎么看都像十年前的山寨网页:字体乱、配色土、按钮一个比一个难看。代码能跑和产品能用之间,隔着一条审美鸿沟。
这套设计skills相当于给模型配了个专业设计师,从页面排版、配色、交互动效到手机端适配统一规范。UP主特别提到移动端体验——这是很多AI生成前端最容易忽略的部分,桌面端看着还行,一到手机上布局就散架。把设计规范前置成skill,比事后一句句纠正要高效得多。
这五个插件的共同逻辑
拆开看是五个工具,合起来其实是同一个判断:当前大模型的能力短板,很多不在智力层面,而在工作习惯层面。烧token、考古、废话、拆结构、审美差,都是模型缺少约束和规范时的默认行为。
skill这类机制的价值就在于此——它不改变模型本身,而是把领域内的最佳实践固化成可复用的规则。对普通用户来说,不必每次都写一大段提示词去纠正同一个毛病,装一次就长期生效。
UP主在视频结尾的建议比较务实:别光顾着收藏,挑一个最需要的今天就装上试试。毕竟养大模型是让它替人干活的,不是花钱养个祖宗最后还得自己伺候。从投入产出比看,先解决烧token和废话连篇这两个问题,体感提升最直接。
相关推荐
比格犬缉毒队:从水果到GHB的国境防线
比格犬缉毒队如何守护美国边境?本文基于《To Catch A Smuggler》实录,展现农业检测犬查获水果肉类,以及执法部门追踪GHB、可卡因走私的全过程,揭示从东南亚到圣路易斯的毒品供应链与多部门协作。
番茄高产秘诀:稳定供水如何让盆栽番茄远超地栽
一段来自YouTube的种植记录显示,容器中的番茄产量远超主菜园地栽植株。种植者认为关键在于稳定供应适量的水,而非施肥。本文分析稳定供水对番茄结果期和产量的影响,并讨论容器种植的可控性优势。
反向角色扮演:当你在游戏里成为LLM的子代理
Hacker News上出现一款反向角色扮演游戏,玩家扮演LLM的子代理执行任务。本文分析其游戏机制、AI代理热潮下的哲学意味,以及独立开发者如何用轻量交互探讨人机权力关系。