deer-flow 向量记忆持久化实战:长时程 Agent 的混合检索与性能调优

长时程Agent接入deer-flow时,pgvector混合记忆的调优经验与遗忘难题。
文章分享了将字节跳动开源框架 deer-flow 的记忆架构接入 PostgreSQL + pgvector 的生产实践。作者指出长时程 Agent 的核心挑战在于高并发下的语义记忆持久化,因此必须采用融合语义相似度、时间新近度和任务血缘的混合搜索。文中给出了经过实战检验的表结构与 HNSW 索引配置(m=16、ef_construction=64),并论证 TTF 在向量分数聚集时优于加权求和。生产集成中暴露的三个陷阱分别是嵌入未归一化导致召回率下降 22%、HNSW 批量写入锁表以及嵌入生成成为写入瓶颈。最后作者指出记忆压缩、缓存失效与遗忘策略仍是开放难题。
长时程 Agent 的记忆困境
当我们将字节跳动的开源框架 deer-flow 接入多小时的自主研究流水线时,核心挑战并非任务编排,而是高并发下的语义记忆持久化。运行超过 90 分钟的 Agent 需要回忆先前决策、避免重复 API 调用,并在沙箱重启后保持上下文连贯。
大多数 Agent 框架将记忆视为附属功能,而 deer-flow 通过可插拔的记忆后端认真对待了这一问题。但将其集成到现有的 PostgreSQL + pgvector 技术栈时,我们遭遇了真实的架构摩擦点。
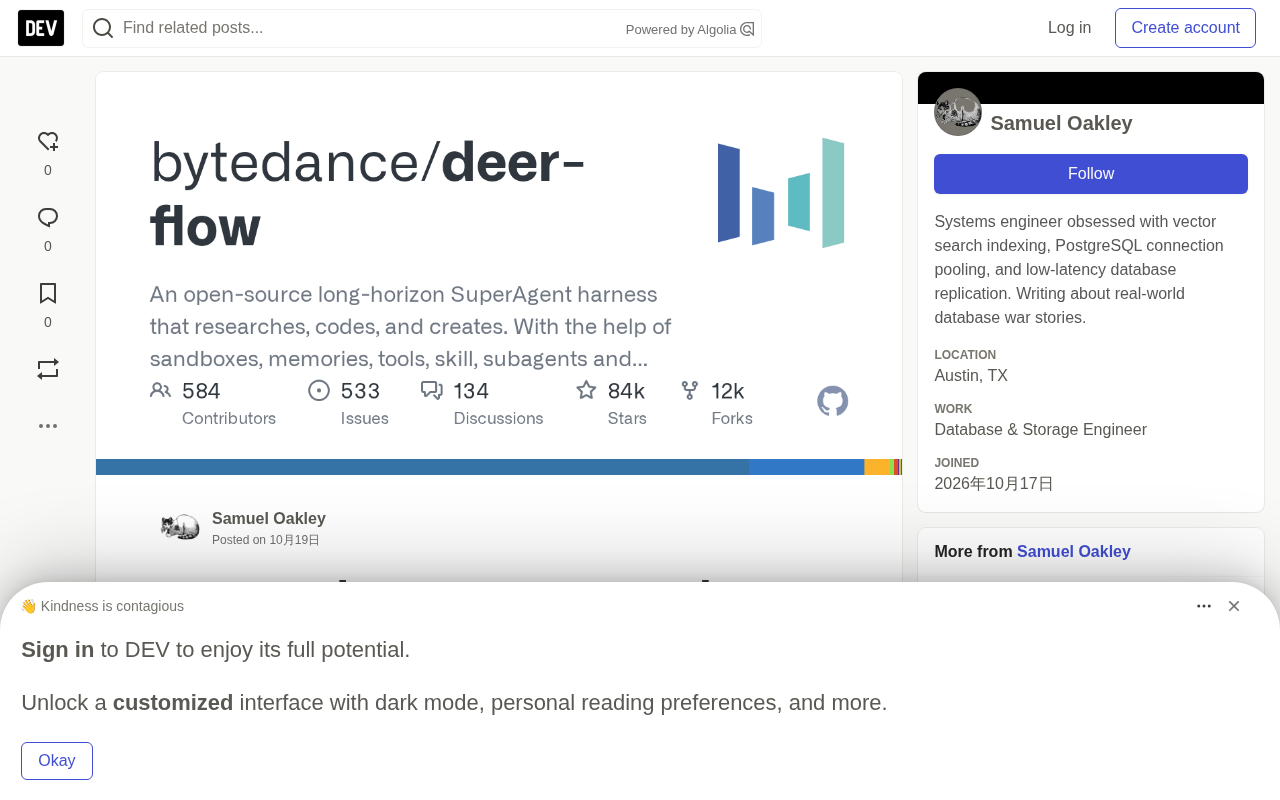
deer-flow 的记忆链架构
deer-flow 将记忆拆分为三层:
- 会话缓冲区(临时,进程内)
- 向量存储(通过嵌入进行语义检索)
- 关系型元数据(时间戳、任务 ID、血缘关系)
关键洞察在于:混合搜索必须融合向量相似度、时间新近度和任务祖先过滤器。纯余弦相似度会检索到语义相关的记忆,却忽略了因果顺序——这恰恰是长时程任务中最致命的缺陷。
交付物一:PostgreSQL Schema 与 HNSW 索引
以下是我们经过实战检验的 Schema,将 deer-flow 的记忆接口与 pgvector 对接:
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE agent_memories (
  id BIGSERIAL PRIMARY KEY,
  agent_id TEXT NOT NULL,
  task_id TEXT NOT NULL,
  content TEXT NOT NULL,
  embedding vector(1536) NOT NULL,
  created_at TIMESTAMPTZ DEFAULT NOW(),
  parent_task_id TEXT
);

-- HNSW 索引:在 10 万+ 行时实现亚 100ms 向量搜索
CREATE INDEX ON agent_memories
  USING hnsw (embedding vector_cosine_ops)
  WITH (m = 16, ef_construction = 64);

-- 复合索引用于过滤式向量搜索
CREATE INDEX ON agent_memories (agent_id, task_id, created_at DESC);
关键的调优经验:将 m 设为 16、ef_construction 设为 64 后,在 500 个并发插入下我们获得了 12ms 的 p99 延迟。pgvector 的默认设置在批量记忆写入时会导致超过 2 秒的插入停顿——这个坑我们踩得很深。
HNSW(Hierarchical Navigable Small World)是一种基于多层图结构的近似最近邻搜索算法,被广泛用于向量数据库。其核心思想是将向量按距离组织成多层可导航图:上层稀疏、用于快速跨区域跳转,下层稠密、用于精细定位,查询时从顶层入口点逐层贪心下沉,以对数复杂度逼近目标向量。pgvector 的 HNSW 索引通过 m 和 ef_construction 两个参数控制构建质量:m 是每个节点在图中保留的邻居边数,越大则图连通性越好、召回率越高,同时索引体积与内存开销也越大;ef_construction 是构建时候选队列的大小,越大则构建越慢但索引质量更优。二者共同决定查询时的召回-延迟权衡,因此生产环境需要基于数据规模和并发写入模式反复实测调优,而非沿用默认值。
交付物二:基于倒数排名融合的混合搜索
纯向量搜索在复杂的多步任务中失效——Agent 会检索到 3 小时前语义相关的记忆,却忽略了 10 分钟前的关键决策。
我们选择 RRF 而非简单加权求和,原因在于后者在向量分数聚集于 0.85-0.90 区间时会灾难性失效,时间新近信号被完全淹没。RRF 的基于排名的评分机制则稳定得多。
deer-flow 的记忆接口与我们的 HybridMemoryRetriever 对接,核心逻辑是分别获取向量相似度排名和时间新近度排名,再用 1 / (k + rank) 融合(k=60)。每个子查询各取前 20 条,融合后返回前 5 条。
这种双通道设计确保了:语义相关的记忆不会因为时间久远而被丢弃,关键的新近决策也不会因为向量分数略低而被忽略。
RRF(Reciprocal Rank Fusion)是一种无参数的多路检索结果融合方法,最早由 Cormack 等人在信息检索领域提出。其公式为对每个候选文档在所有检索通道上的 1 / (k + rank_i) 求和,其中 rank_i 是文档在第 i 个通道中的排名,k 是平滑常数(常用 60)。RRF 的关键优势在于只依赖排名而非原始分数,因此天然免疫不同通道分数尺度不一致的问题,例如向量余弦相似度与时间新近度通常分布在不同区间。相比加权求和,RRF 不需要为每个通道调参,也不会因为某一通道分数集中而让其他信号失效。代价是丢失了分数的绝对信息,例如无法区分“极其相似”与“较为相似”,但对长时程 Agent 记忆检索这类需要稳健多信号融合的场景而言,排名级融合通常更可靠。
生产集成中的三个陷阱
嵌入归一化缺失:deer-flow 不强制 L2 归一化,我们观察到召回率下降 22%,直到手动添加归一化函数才恢复。这是一个容易被忽视但影响巨大的细节。
并发写入瓶颈:HNSW 索引在批量插入时会锁表,导致 5 秒以上的写入停顿。我们的解决方案是批量写入记忆并配合 INSERT ... ON CONFLICT DO NOTHING,同时引入 50ms 的防抖窗口。
嵌入生成成为瓶颈:通过第三方中继网关测试多提供商回退延迟时,text-embedding-3-small 的平均生成时间为 127ms,这比数据库写入更慢。建议异步预生成嵌入,避免阻塞记忆写入路径。
嵌入归一化:向量嵌入的 L2 归一化是指将每个向量除以其欧氏范数,使其长度为 1。归一化后,向量点积等价于余弦相似度,而不同长度的向量在未归一化的点积计算中会因模长差异产生系统性偏差——长向量更容易获得高分。不同嵌入模型对是否输出归一化向量并无统一约定,deer-flow 等框架也不会强制检查。若向量未归一化而索引按余弦相似度构建,检索排序会出现偏差,表现为召回率下降。修复方式是在生成嵌入后立即执行归一化并持久化归一化后的向量,同时确保写入与查询使用同一套归一化逻辑,避免索引内向量分布不一致。
运维层面的权衡
deer-flow 的可插拔记忆抽象让替换 PostgreSQL 为 Qdrant 变得非常容易,parent_task_id 支持的血缘追踪也让我们能实现因果检索过滤器。临时缓冲区与持久存储的清晰分离同样值得称道。
但痛点也很明显。框架没有内置记忆压缩机制,我们的 Agent 每会话可达 5 万+ 行,导致索引膨胀。上游模型变更时缺乏自动的嵌入缓存失效机制,需要外部处理。混合搜索逻辑只能写在应用层,而非框架原生支持——这意味着每换一个存储后端,你都要重写这部分代码。
嵌入缓存失效:嵌入缓存通常以“文本内容哈希 + 模型标识”作为键存储向量结果,以节省重复生成的 API 调用与延迟。但当上游嵌入模型升级、被替换或下线时,旧向量与新向量处于不同的语义空间,若缓存键中不包含模型版本,就会在检索时混用不同空间的向量,造成语义漂移且难以排查。因此缓存设计应把模型名、版本号乃至关键参数纳入缓存键,并在模型变更时主动使相关缓存失效或按版本隔离。这一机制必须由应用层实现,因为多数 Agent 框架与向量数据库都不会自动追踪嵌入来源,缺少它时一次模型迁移就可能需要全量重建向量并伴随隐性检索质量下降。
尚未解决的开放问题:Agent 何时该遗忘?
我们最大的未解困境是:Agent 应该在什么时候遗忘? 无限增长的记忆在 6 小时会话后严重拖垮性能。朴素的 LRU 淘汰会破坏因果链。时间衰减评分有所帮助,但在上下文切换时引入了新的失败模式。
这是一个值得整个社区共同探讨的问题——你在生产环境的长时程系统中,是如何平衡记忆保留与检索性能的?
相关推荐
一人量产90集AI漫剧:10小时10块钱的完整制作流程
没有编剧经验也能做AI漫剧:10小时10块钱成本,红果平台单部收益4200元。本文拆解从AI生成剧本、分镜脚本到成片的六步完整流程,附万能提问公式和新手避坑指南。
豆包Agent自制报价测算器:接单报价告别凭感觉
B站UP主用豆包Agent零代码自制报价测算器,输入项目类型、数量、周期即可自动生成报价明细,支持加急与版权买断费率,一键复制发客户,手机端也能随时报价。
WorkBuddy实战教程:10个Agent项目从入门到简历级
WorkBuddy 实战教程解析:用中文交代任务的 AI 工作助手,配置环境比 Codex、Claude Code 更简单。10 个 Agent 实战项目覆盖文件整理、表格汇整、网页生成,新手三步上手,学完可写进简历。