等待揭示两个风险矩:预测驱动分配的内生识别

在风险依赖流失下,每多观测一期多识别两个矩,但时机遗憾不可避免。
本文解读了一项关于预测驱动分配中等待与干预权衡的研究。在预防性干预资源有限时,等待可揭示风险但高风险个体先流失,导致内生性。论文证明观测长度τ恰好识别潜在风险的2τ个矩,每多一期多识别两个矩,但这些矩不足以识别分配福利。固定观测长度下,无论样本量多大,时机遗憾不可避免,并给出精确证书判断唯一最优日期。匹配实验显示bootstrap平均和早停改善决策,遗憾加权无增益,表明统计拟合更好不等于分配福利更好。更长的观测常能消解时机模糊,但最优日期可能已过。
当等待成为策略:风险揭示与干预机会的权衡
在预防性干预资源有限的场景中——无论是公共卫生中的高危人群管理、金融风控中的客户流失预防,还是平台运营中的用户挽留——决策者面临一个两难:立即行动可能用错人,等待更多信息则可能错过时机。一篇题为《Waiting Buys Exactly Two Moments: Endogenous Identification in Prediction-Driven Allocation》的研究,用严谨的计量经济学框架刻画了这一权衡。
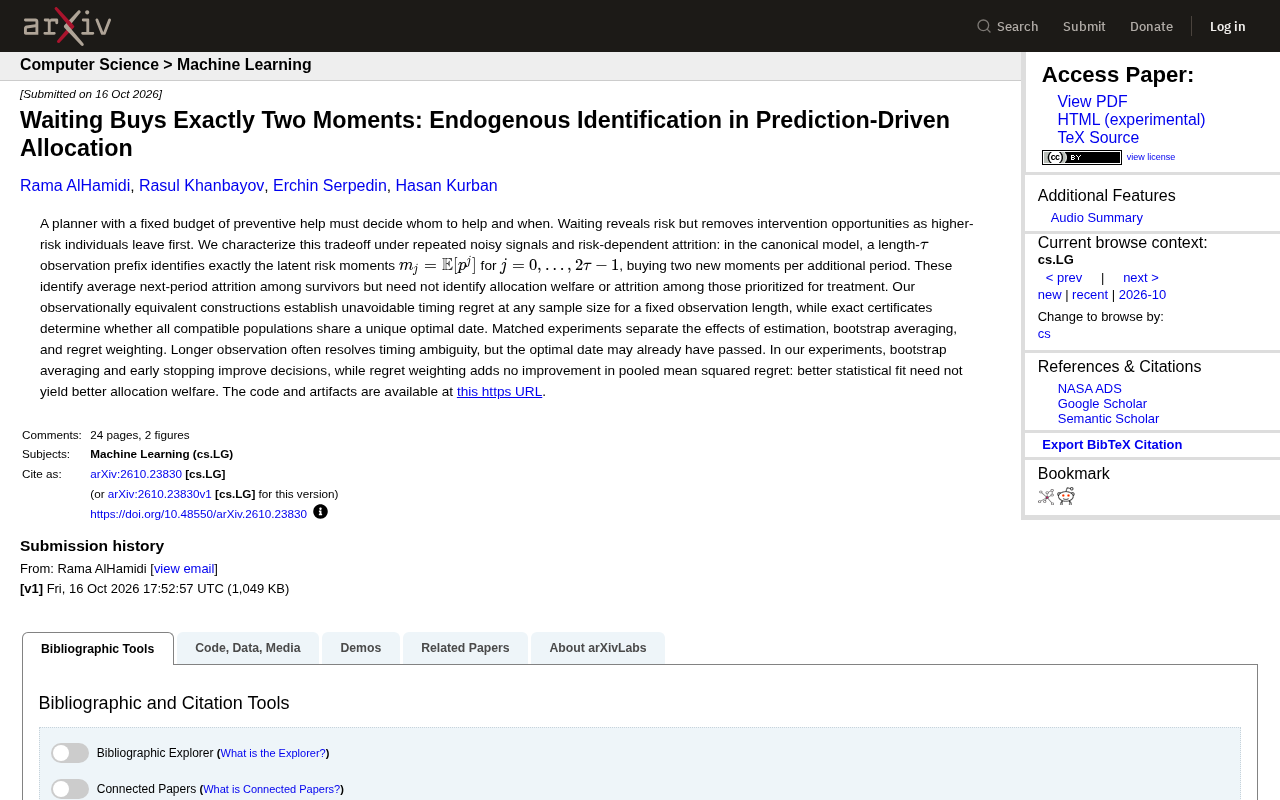
论文的核心设定是:规划者拥有固定预算的预防性帮助,需要决定帮助谁、何时帮助。等待可以揭示个体的风险信号,但高风险个体往往先“离开”(流失、违约、发病),从而移除干预机会。这种风险依赖的 attrition(流失)使得观测样本不再随机,构成了内生性问题。
核心发现:每多观测一期,多识别两个矩
经典模型下的识别结果
在典型模型中,若观测长度为 τ 期,则恰好能识别潜在风险的矩 m_j = E[p^j](j = 0, …, 2τ−1)。换言之,每增加一个观测期,就多“买”到两个新的矩。这一结果简洁而有力:它明确了数据能告诉我们什么,也界定了不能告诉我们什么。
这些矩足以识别幸存者中下一期的平均流失率,却不一定能识别分配福利或优先干预人群中的流失情况。这意味着,即使统计上识别了流失模式,决策者仍可能无法判断哪种分配策略能带来最大福利。
矩(moment) 在概率论与统计中是描述随机变量分布特征的期望值,如均值(一阶矩)、方差(二阶中心矩)等。本文中的矩 ( m_j = E[p^j] ) 是潜在风险概率 ( p ) 的幂次期望,它们编码了风险分布的信息。识别出前 ( 2\tau ) 个矩意味着可以恢复风险分布的某些泛函,但通常不足以唯一确定整个分布,尤其当关注的是分配福利这类非线性泛函时。这解释了为何矩的识别不直接等同于福利识别。
时机遗憾不可避免
论文通过构造观测等价(observationally equivalent)的总体,证明了:在固定观测长度下,无论样本量多大,时机遗憾(timing regret)都无法避免。也就是说,总存在与数据完全兼容、但最优干预日期截然不同的情形。作者进一步给出了精确的证书(certificate),用于判断所有兼容总体是否共享唯一最优日期。
观测等价(observationally equivalent) 指两个不同的数据生成过程产生完全相同的观测数据分布。在因果推断与结构计量中,若两个模型观测等价,则仅凭数据无法区分它们。本文构造观测等价的总体,意味着存在与样本数据完全兼容但最优干预日期截然不同的情景,因此任何基于数据的决策规则都无法保证选中真正最优的时机,从而时机遗憾不可避免。
统计拟合更好,不等于分配福利更好
论文通过匹配实验分离了三种机制的影响:估计(estimation)、bootstrap 平均(bootstrap averaging)和遗憾加权(regret weighting)。实验结果耐人寻味:
- bootstrap 平均和早停(early stopping)改善了决策;
- 遗憾加权在汇总均方遗憾上没有带来改进。
作者因此指出:更好的统计拟合未必带来更好的分配福利。这一结论对实践者有直接的警示意义——优化预测精度与优化决策效果是两个不同的目标,不能想当然地混为一谈。
另一个实践洞察是:更长的观测期通常能消解时机模糊性,但最优日期可能已经过去。这构成了一种根本性的时间约束:信息的价值与机会的流失在赛跑。
bootstrap 平均 是一种通过重抽样估计参数或决策不确定性的方法,常被用于改善决策的稳健性:对多个 bootstrap 样本分别做出决策再平均,可降低方差。早停(early stopping) 在本文语境中并非机器学习中的正则化技术,而是指在观测序列中提前终止等待、更早做出干预决策的策略。遗憾加权(regret weighting) 则是一种调整决策权重以侧重减少遗憾的方法,但实验表明其未能改善汇总均方遗憾。
对预测驱动决策的启示
这项研究的价值在于将“何时决策”这一常被忽视的维度形式化。在机器学习广泛用于资源分配的今天,多数工作聚焦于“预测谁”,而这篇论文提醒我们:观测窗口本身就是一种需要优化的设计变量。代码与工件已在 GitHub 开源(KurbanIntelligenceLab/waiting-buys-two-moments),便于复现与扩展。
对于构建预测驱动分配系统的团队,论文给出三点可操作的启示:其一,明确你的观测长度能识别哪些矩,避免对不可识别量做过度承诺;其二,谨慎对待“等更多数据再决策”的默认策略,因为等待本身会改变样本构成;其三,评估决策策略时,用分配福利而非预测指标作为最终标尺。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。