DGX Spark部署Qwen3 27B实测:三种模式怎么选
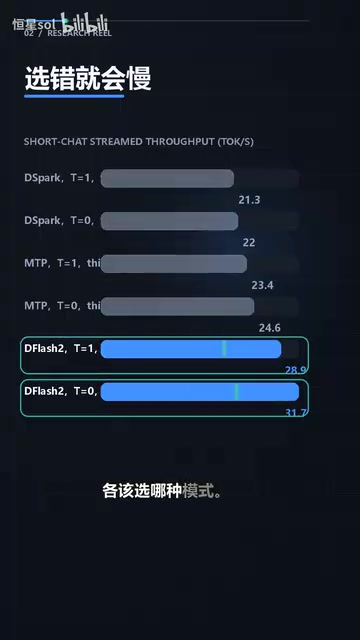
Qwen3 27B在DGX Spark上的三种部署模式实测:按场景选模式比调参数更重要
本文基于B站UP主的实测数据,梳理了Qwen3 27B模型在DGX Spark上通过封装脚本支持的三种运行模式——D-Spark、MPP和D-Flash2——在代码、长文本、思考短聊及并发场景下的性能差异。核心结论是:D-Spark在纯代码场景以51.5 Token/s吞吐略微领先,但长文本仅18.3;D-Flash2则以代码50.9、长文25.4、思考短聊66.6的均衡表现,在长文档处理、多轮推理及16路并发(总吞吐227.6 Token/s)场景中更具优势。项目采用MIT协议、近30天22次提交,并支持一行Curl命令调用,整体降低了本地大模型落地的门槛。文章建议用户根据真实工作负载在自己环境中复测后再确定长期配置。
部署不难,难的是选对模式
在DGX Spark上部署大模型,真正的挑战往往不在于跑起来,而在于面对不同任务时该如何配置。据B站UP主的实测分享,Qwen3系列27B模型的部署已经被封装成脚本,可以在三种运行模式间自由切换:D-Spark、MPP和D-Flash2。这种设计的核心逻辑很直接——没有一种模式能包打天下,代码补全、短对话、长文本处理各有各的最优解。
模型默认支持原生262K的超长上下文窗口,这为长文档处理提供了硬件基础。但上下文长度只是纸面参数,实际吞吐和延迟表现才是决定使用体验的关键。这也是为什么脚本要提供多模式切换,而不是给一个"万能配置"。
DGX Spark是英伟达面向个人开发者和小型团队推出的桌面级AI超级计算机,搭载Grace Blackwell超级芯片,集成了高带宽内存(HBM)与NVLink互联,能够在本地运行数百亿参数规模的大型语言模型。与云端API调用相比,本地部署意味着数据不出本机、无token计费、低延迟,但也对运行模式的调优提出了更高要求——同样的硬件,配置不同,性能差距可能超过40%。
三种模式的实测数据对比
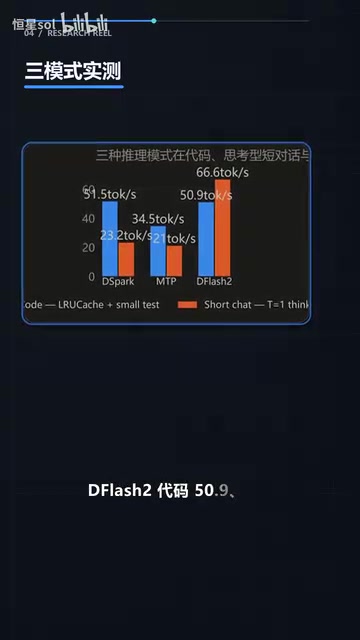
从实测结果看,不同模式在不同场景下的差异相当明显,用一组吞吐数据(单位 Token/s,原文记作 TalkS)就能看清取舍。
D-Spark:代码场景占优
D-Spark模式在代码任务上跑出51.5的吞吐,是三种模式里代码表现最好的。但它的短板同样突出——长文本处理只有18.3,明显落后。这意味着如果你的主要工作是代码补全、函数生成这类短上下文、高频请求的场景,D-Spark是首选。
D-Flash2:长文与思考更均衡
D-Flash2模式的代码吞吐为50.9,与D-Spark几乎持平,但长文本处理拉到了25.4,比D-Spark高出近四成。更关键的是,在思考型短聊场景下,D-Flash2达到了66.6的吞吐。这说明当任务涉及推理链条、多轮对话或长文档分析时,D-Flash2是更稳妥的选择。
并发吞吐:D-Flash2的规模化能力
单路性能之外,并发能力决定了模型能否支撑实际的多用户服务。实测中,D-Flash2在16路并发下总吞吐达到227.6 Token/s,平均每路28.2 Token/s,首Token延迟(TTFT)为4.18秒。
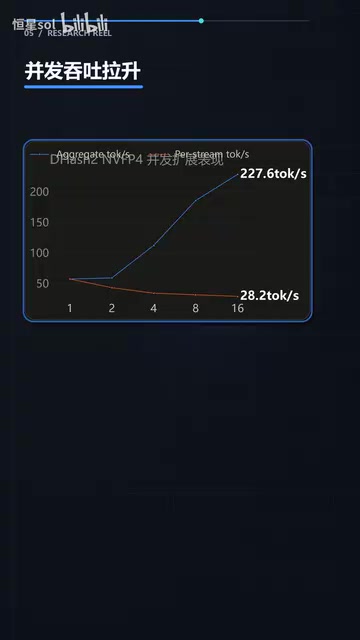
这组数据说明D-Flash2不仅单路表现均衡,在高并发下的扩展性也不错。16路并发下每路仍能保持28.2的吞吐,意味着在多人共用一台DGX Spark的场景中,D-Flash2能提供相对稳定的服务质量。4.18秒的首包延迟对于长上下文模型来说属于可接受范围,但在对交互实时性要求极高的场景中仍需权衡。
首Token延迟(TTFT,Time To First Token)是衡量模型响应速度的关键指标,指从用户发出请求到模型输出第一个Token的时间间隔。在交互式对话场景中,TTFT直接决定用户感知到的"卡顿感":低于1秒通常被视为流畅,2-4秒属于可接受范围,超过5秒则会明显影响体验。对于长上下文模型,由于需要预填充(prefill)大量输入token,TTFT通常高于短对话场景,4.18秒的结果处于该类模型的正常区间。并发模式下TTFT会进一步拉长,因此高实时性场景建议控制并发路数或采用流式输出(streaming)来缓解等待感。
开源活跃度与快速上手
该项目采用MIT开源协议,这是对商用最友好的授权方式之一。从维护活跃度看,近30天内有22次提交,更新频率相当密集,说明项目仍在积极迭代,遇到问题也更容易获得响应。
对于想直接上手的用户,部署启动后可以通过一条Curl命令直接调用API,省去了复杂的接口封装工作。这种"脚本化部署 + 一行调用"的组合,大幅降低了在DGX Spark这类硬件上跑本地大模型的门槛。
MIT协议是开源软件领域最宽松的许可证之一,允许任何人自由使用、复制、修改、合并、发布,甚至用于商业产品,唯一要求是保留原始版权声明。相比GPL(需要衍生作品同样开源)或Apache 2.0(需保留专利授权条款),MIT协议对商业集成几乎没有额外约束,企业团队无需担心因内部部署或二次开发产生法律风险,是评估开源项目商用可行性时的重要加分项。
该怎么选:一张决策表
结合实测数据,模式选择的思路其实很清晰:
- 纯代码高频场景:选D-Spark,代码吞吐51.5领先,无需长上下文。
- 长文档、推理、多轮对话:选D-Flash2,长文25.4、思考短聊66.6,综合最优。
- 多用户并发服务:选D-Flash2,16路总吞吐227.6,扩展性更好。
需要提醒的是,这些数据来自单一来源的实测分享,具体表现会因硬件批次、模型版本和实际负载而波动。建议在自己的真实工作负载下复测,再决定长期采用哪种模式。整体来看,这套封装脚本把"部署+调优+调用"打包成了低成本方案,对想在DGX Spark上落地本地推理的团队有实际参考价值。
相关推荐
深入LLM推理:从KV Cache到PD分离的Serving全景解析
深入解析LLM推理与Serving技术栈:涵盖KV Cache原理、Prefill/Decode两阶段计算形态、PagedAttention、PD分离、EP并行、投机解码等核心机制,剖析大模型推理系统的关键工程权衡与优化思路。
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta旗下个人AI智能体Muse上线仅六天下载量突破90万,连续登顶美国App Store与Google Play双榜,超越ChatGPT、Claude等明星产品。本文深度解析Muse的核心能力、入口优势与AI Agent赛道的竞争格局。
认知行为疗法 vs 精神分析:谁赢得了心理治疗之争
认知行为疗法(CBT)如何战胜精神分析成为心理治疗主流?历史学家Andrew Scull揭示了从二战、联邦经费到循证医学的深层原因,并客观评估CBT在轻度与重度精神障碍上的真实疗效。