dhAIBench:用293次实验重新定义大模型语言标注评测
查尔斯大学推出dhAIBench,主张按具体语言任务而非通用排名评估大模型标注能力。
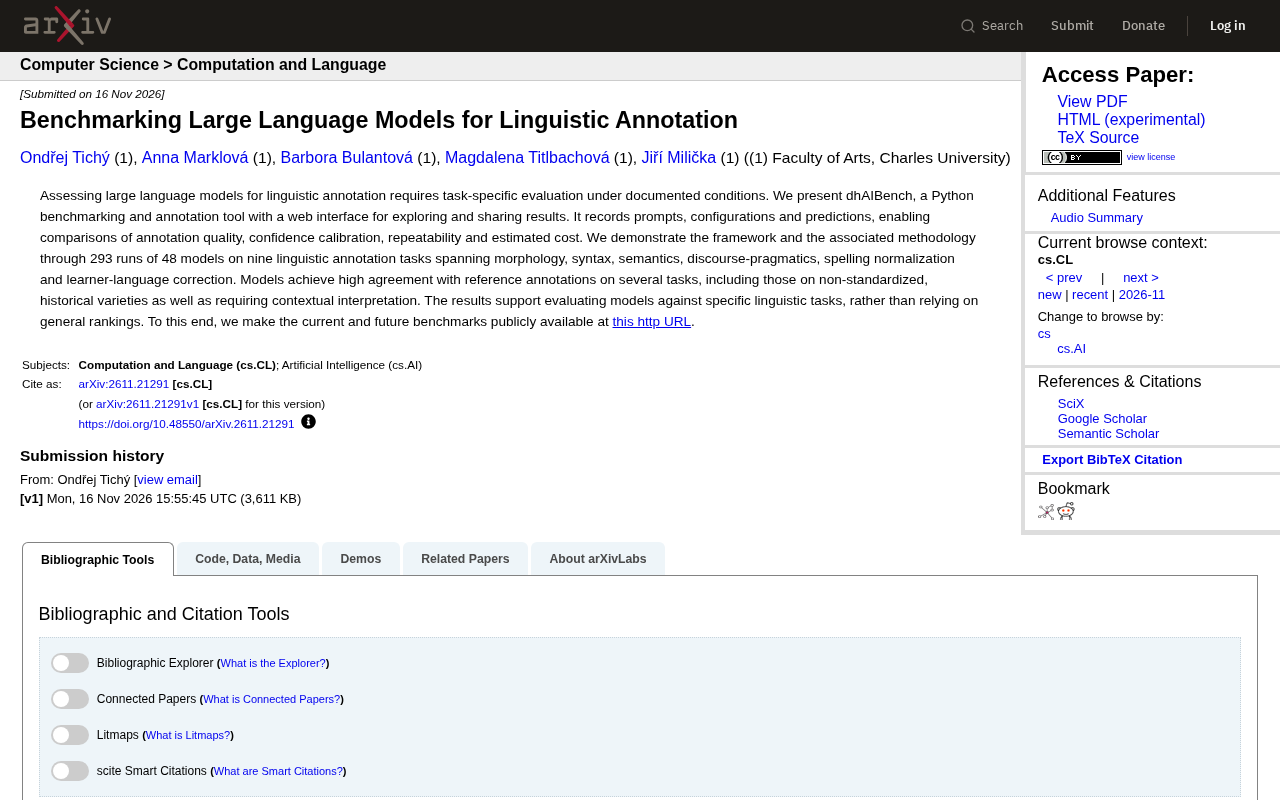
查尔斯大学研究团队开发了dhAIBench框架,主张大语言模型的评估应针对具体语言标注任务,而非依赖通用排行榜。该框架是一个记录提示词、配置和预测的Python基准测试与标注工具,配有Web界面,支持从标注质量、置信度校准、可重复性和预估成本四个维度比较模型。团队用48个模型在九个语言标注任务上运行了293次实验,覆盖形态学、句法、语义、语篇语用、拼写规范化和学习者语言纠错。结果显示,模型在非标准化文本和历史语言变体等任务上与参考标注达到高一致性,但不同任务间表现差异明显,证明任务级评估的必要性。文章建议标注团队在目标任务上做可复现的小规模对比,并将提示词和配置作为实验记录的一部分。
大语言模型在语言标注任务上表现如何?通用排行榜上的高分是否意味着它能胜任词形还原、句法分析或语义标注?来自查尔斯大学的研究团队给出了否定答案——他们开发的dhAIBench框架,通过任务级的系统性评测,揭示了模型能力与具体语言任务之间的复杂关系。
为什么通用排名不够用?
传统的大模型评测往往依赖综合基准或单一指标排名,但语言标注是一个高度分化的领域。形态学、句法、语义、语篇语用等任务对模型的底层能力要求截然不同。一个在通用问答中表现优异的模型,未必能准确标注历史文本中的非标准拼写,也未必能处理需要上下文推理的语篇关系。
dhAIBench的核心主张由此展开:评估模型必须针对特定语言任务,在可记录的条件下进行。论文明确指出,结果“支持针对具体语言任务评估模型,而不是依赖通用排名”。这一结论对语言学家、标注工具开发者和AI产品选型都有直接参考价值。
语言标注任务在NLP中通常按语言学分层面划分:形态学处理词内部结构(如词形还原需将“running”还原为“run”),句法分析关注词与词之间的结构关系(如依存句法),语义标注涉及词义消歧和语义角色标注,语篇语用则处理跨句子的指代、连贯和言语行为。这些任务对模型能力的要求差异显著——形态学依赖字符级模式记忆,句法需要结构化输出能力,语篇推理则要求长上下文建模。传统NLP流水线为每个任务单独训练专用模型,而大语言模型的统一接口使得同一模型可尝试多种任务,但能力并不均衡。dhAIBench正是基于这种分层框架设计任务集,从而能定位模型在具体语言学子领域中的强弱项,而非给出一个掩盖差异的平均分。
dhAIBench是什么:一个可复现的评测基础设施
dhAIBench本质上是一个Python基准测试与标注工具,配有Web界面用于浏览和分享结果。它的关键设计在于可追溯性——系统会记录提示词(prompts)、配置(configurations)和预测结果(predictions),从而支持四个维度的比较:
- 标注质量:模型输出与参考标注的一致程度
- 置信度校准:模型的自信程度是否与其实际准确性匹配
- 可重复性:相同配置下结果是否稳定
- 预估成本:运行标注任务的资源开销
这四个维度构成了一个远比“准确率”更立体的评估画像。尤其值得关注的是置信度校准和可重复性,它们直接关系到模型能否被信任用于实际标注流水线。
293次实验揭示了什么
研究团队用48个模型在九个语言标注任务上运行了293次实验,任务覆盖形态学、句法、语义、语篇语用、拼写规范化以及学习者语言纠错。几个关键发现值得细读:
- 模型在多个任务上与参考标注达到高一致性,包括非标准化文本、历史语言变体,以及需要上下文解释的任务。这说明大模型的语言能力已经延伸到传统NLP工具难以覆盖的领域。
- 高一致性并不意味着所有任务都同等轻松。不同任务之间的表现差异,恰恰证明了任务级评估的必要性。
- 评测框架本身是公开的,当前及未来的基准测试结果可在dhaibench.silent3.ff.cuni.cz访问。
置信度校准(confidence calibration)是评估模型可靠性的关键指标,衡量模型自报的置信度与实际正确率之间的偏差。一个校准良好的模型,当其声称“很有把握”时确实大概率正确,而校准差的模型可能在高置信度下频繁出错。对于语言标注流水线而言,校准比单纯的准确率更重要:如果模型能可靠地标识出低置信度的样本,人工审核就可以集中处理这些疑难案例,从而大幅降低标注成本。dhAIBench将置信度校准列为独立比较维度,意味着它不只关心模型“对不对”,还关心模型“知不知道自己可能错”,这直接决定了模型输出能否被信任并嵌入人机协作的标注流程。
对语言标注工作流的实际意义
对正在考虑将大模型引入标注流程的团队来说,dhAIBench的方法论提供了两个务实建议。第一,不要用通用榜单做选型决策,而应该在目标任务的小规模样本上跑一轮可复现的对比。第二,把提示词和配置当作实验记录的一部分,因为标注质量对提示设计高度敏感,没有记录的实验结果无法复现也无法比较。
dhAIBench的Web界面让结果浏览和分享变得低门槛,这对跨机构协作标注项目尤其有用——团队成员可以基于同一套记录对比不同模型配置,而不必各自维护零散的评测脚本。
提示词敏感性(prompt sensitivity)指同一模型在提示措辞、示例选择、输出格式约束等微小变化下表现出的性能波动。在语言标注任务中,这种敏感性尤为突出:改变标签体系的表述方式、调整few-shot示例的顺序或数量、甚至仅修改指令中的动词,都可能导致标注一致性显著变化。dhAIBench将提示词和配置纳入实验记录,正是为了控制这一变量。没有完整记录的提示设计,实验结果既无法复现也无法在不同模型间公平比较,团队协作时更会因各自使用不同提示而产生不可比的数据。将提示词视为实验记录的一部分,是使大模型标注从“试出来的效果”走向可积累、可审计工程实践的前提。
局限与展望
九个任务和48个模型的组合已经相当可观,但语言标注的多样性远不止于此。框架的公开托管意味着社区可以持续补充新任务和新模型,这将逐步积累出一张比任何静态排行榜都更有信息量的“任务-模型”能力图谱。对语言学研究而言,这种细粒度的评测数据本身也是理解模型语言能力的素材。
相关推荐

AI代打电话?Muse让语音助手替你预约
Muse推出AI代打电话功能,仅限美国付费订阅用户。本文分析语音助手切入电话场景的产品逻辑、付费墙策略与语音代理的想象空间及隐私隐忧。
谷歌PaperOrchestra:多智能体框架自动化写AI论文
谷歌研究院开源 PaperOrchestra 多智能体框架,将 AI 研究论文写作拆解为文献、方法、实验等子任务,由不同智能体协作编排完成,GitHub 已获 2093 星,今日新增 313 星。

Marimba:0.6B小模型如何用单一编码器处理语音问答
Marimba 是一个基于 Qwen3-ASR-0.6B 编码器的轻量语音问答模型,支持流式处理、本地运行,可作为轮次检测器接入 Pipecat、LiveKit 和 Vapi,在特定任务上超越大模型。