低比特量化新突破:GGA+PW让线性注意力长文本生成更准更短

GGA按梯度敏感度分配比特,PW为近期写入保留高精度,二者结合显著提升低比特GDN长上下文推理表现。
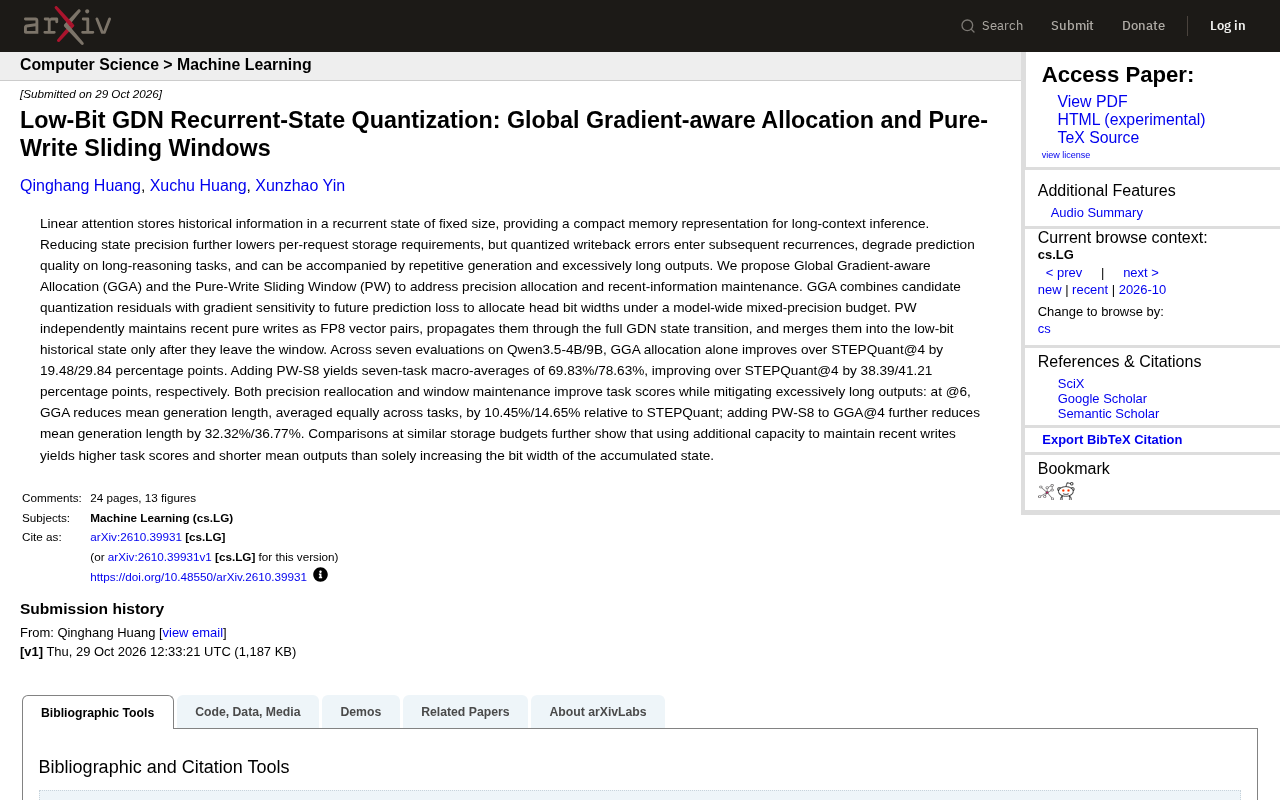
线性注意力模型依靠固定大小的循环状态压缩历史,低比特量化带来的写回残差会在循环中累积,导致长推理任务准确率下降、重复生成和输出过长。针对低比特GDN循环状态量化,研究提出全局梯度感知分配(GGA)与纯写滑动窗口(PW):GGA评估各注意力头量化残差对损失的梯度影响,在混合精度预算下为不同头分配比特;PW以FP8向量对独立维护近期纯写入,离开窗口后才并入低比特历史状态。在Qwen3.5-4B/9B上,GGA alone较STEPQuant@4提升19.48/29.84个百分点,GGA+PW-S8七任务宏平均达69.83%/78.63%,并显著缩短平均生成长度。同预算对比表明,优先保障近期信息精度比单纯提高历史状态比特更划算。
线性注意力模型在长上下文推理中依赖固定大小的循环状态来压缩历史信息,这种设计天然节省存储,但一旦对状态做低比特量化,量化写回误差就会在后续循环中不断累积,导致长推理任务预测质量下降,甚至出现重复生成和输出过长的问题。近期一篇关于低比特GDN(Gated DeltaNet)循环状态量化的研究,提出了全局梯度感知分配(Global Gradient-aware Allocation, GGA)与纯写滑动窗口(Pure-Write Sliding Window, PW)两种方法,试图在存储预算内同时解决精度分配与近期信息维护的难题。
为什么低比特状态量化会“越写越错”
循环状态是线性注意力模型记忆历史信息的唯一载体,每一步推理都会把新信息写入状态,同时读出状态参与预测。当状态被压缩到低比特后,写回操作会引入量化残差,这些残差不会消失,而是随着循环步数逐步叠加。在长推理任务中,误差累积会直接削弱模型对早期上下文的回忆能力,表现为答案准确率下降、生成内容重复,以及模型“停不下来”地输出过长文本。
研究团队指出,单纯提高累积状态的比特宽度并非最优解:同样的存储预算,如果用于维护近期写入的原始信息,往往能获得更高的任务分数和更短的输出。这一观察构成了GGA与PW两种方法的设计出发点。
线性注意力(Linear Attention)是Transformer注意力的一种高效变体,其核心思想是用核函数将softmax注意力分解为可线性累加的形式,从而把推理复杂度从序列长度的平方降到线性。GDN(Gated DeltaNet)在此基础上引入了门控机制与Delta规则:门控控制历史信息的遗忘速率,Delta规则则让状态更新近似于在线学习中的梯度步,使循环状态能够有选择地记住或覆盖信息。正因如此,GDN的状态不仅是简单的累加器,而是承载了带权重的历史记忆,每一步写入都会与已有状态发生交互。这也解释了为何量化残差在GDN中危害更大:残差不仅作为噪声存在,还会通过门控和Delta更新被放大或持久化,进而扭曲后续所有读出。
GGA:用梯度敏感度决定“谁该多分比特”
GGA的核心思路是把量化残差与梯度敏感度结合起来。具体来说,它评估每个注意力头的候选量化残差对未来预测损失的梯度影响,再在模型级混合精度预算下为不同头分配比特宽度。换句话说,对最终预测更敏感的头获得更高精度,不敏感的头则压缩得更狠,从而在总预算不变的前提下降低整体量化误差。
据论文数据,在Qwen3.5-4B和9B两个模型上,仅使用GGA分配、不做其他改动,七项评测成绩就比STEPQuant@4分别提升了19.48和29.84个百分点。这说明精度分配策略本身就能带来显著收益,而不需要额外增加存储开销。
混合精度量化(Mixed-Precision Quantization)是指在同一模型内为不同部分分配不同比特宽度,而非全局统一压缩。其关键挑战在于如何度量各部分的“重要性”。梯度敏感度是常用准则之一:对某个参数或激活施加微小扰动,观察损失函数的一阶响应,响应越大说明该部分对最终预测越关键。GGA将这一思想迁移到量化残差上,即评估“如果这个头的状态被量化,其残差会对损失产生多大影响”,从而把有限的比特预算向高敏感头倾斜。与逐层或逐通道的启发式分配相比,梯度感知分配更贴近任务损失,但需要在校准数据上计算梯度,带来一定的离线开销。
PW:让近期写入走“纯净通道”
PW解决的是另一个问题:近期信息不应该和低比特历史状态混在一起。该方法独立维护最近一段时间的纯写入内容,以FP8向量对的形式保存,并让这些向量完整参与GDN的状态转移过程。只有当它们离开滑动窗口后,才被合并进低比特历史状态。这样,模型在推理近期上下文时使用的是高精度信息,而远期历史仍以低比特形式长期保存。
在GGA基础上加入PW-S8后,七任务宏平均分别达到69.83%和78.63%,相比STEPQuant@4分别提升38.39和41.21个百分点。说个细节,精度重分配和窗口维护不仅提升任务分数,还缓解了输出过长的问题:在@6设置下,GGA相对STEPQuant将平均生成长度(按任务等权平均)降低10.45%和14.65%;在GGA@4上再加入PW-S8,平均生成长度进一步降低32.32%和36.77%。
滑动窗口(Sliding Window)是流式推理中维护近期上下文的常见结构:只保留最近若干步的原始信息,更早的内容则被压缩或丢弃。PW的特殊之处在于,它并不丢弃窗口外的信息,而是等这些纯写入向量离开窗口后再并入低比特历史状态,从而形成“近期高精度、远期低精度”的分层记忆。FP8(8位浮点)是近年来硬件广泛支持的低精度格式,相比INT8能更好地保留动态范围,适合表示数值分布较宽的写入向量。窗口大小S8中的“8”即指窗口覆盖的步数或槽位数,窗口越大近期保真度越高,但额外存储也越多,因此需要与总预算权衡。
存储预算怎么花更划算
论文还做了同存储预算下的对比:把额外容量用于维护近期写入,比单纯提高累积状态的比特宽度,能获得更高的任务分数和更短的平均输出。这一结论对实际部署有直接指导意义——在显存或带宽受限的场景中,优先保障近期信息的精度,比一味追求历史状态的高比特更有效。
对长上下文推理的启示
这项工作的价值在于把低比特量化从“均匀压缩”推向“按敏感度分配+按时间分层”的组合策略。GGA处理的是空间维度上的精度分配,PW处理的是时间维度上的信息新鲜度,两者互补。对于需要在端侧或低成本硬件上运行长上下文推理的模型,这种思路提供了一条可复用的工程路径:与其整体提高精度,不如把钱花在刀刃上——让敏感的头和近期的记忆保持更高保真度。
当然,论文目前只在Qwen3.5-4B/9B上验证了七项评测,方法在不同模型架构和更长上下文下的泛化能力还有待进一步观察。但就已有数据来看,GGA与PW的组合在任务分数和生成长度两个维度上都带来了可观的改善,为线性注意力模型的低比特部署提供了新的参考。
相关推荐
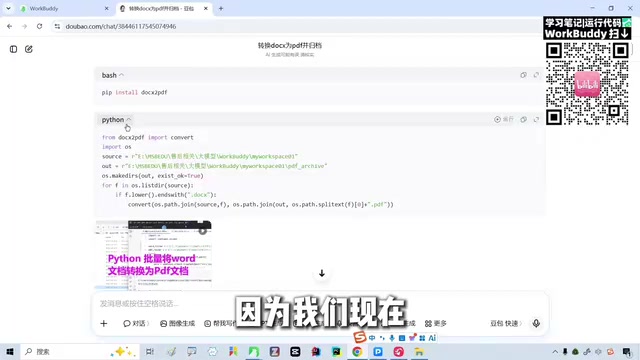
WorkBuddy实战:腾讯AI Agent如何让大模型真正动手干活
WorkBuddy是腾讯推出的办公场景AI Agent工具,能理解自然语言需求并直接操作电脑完成任务。本文通过文件转换实战演示,对比豆包等聊天大模型与Agent的核心差异,分析WorkBuddy与CodeX的能力差距及适用场景。
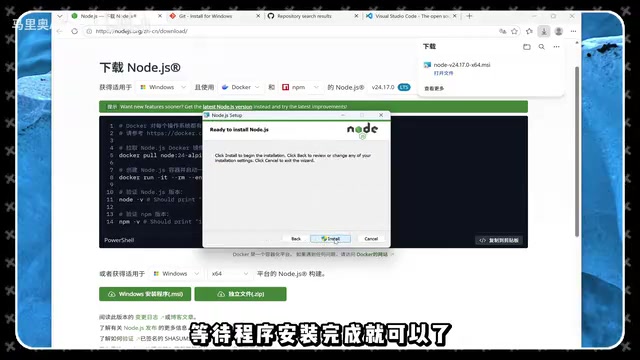
Vibe Coding保姆级教程:3步上手AI编程
一篇面向零基础用户的Vibe Coding保姆级教程,分三步讲解Claude Code安装、DeepSeek API接入与编辑器调度配置,附常见报错解决方法和踩坑提醒。
Instagram放任名人AI深伪内容泛滥?
一张AI生成的Mia Goth照片经Instagram蓝V认证账号发布后全网疯传,Google AI Overview将其当作真实信息摘要。Taylor Swift和Lionel Messi的AI视频播放量达百万级,Meta却不要求AI照片标注,平台治理面临失效质疑。