低成本训练大模型:$998实现3.8B模型训练全解析
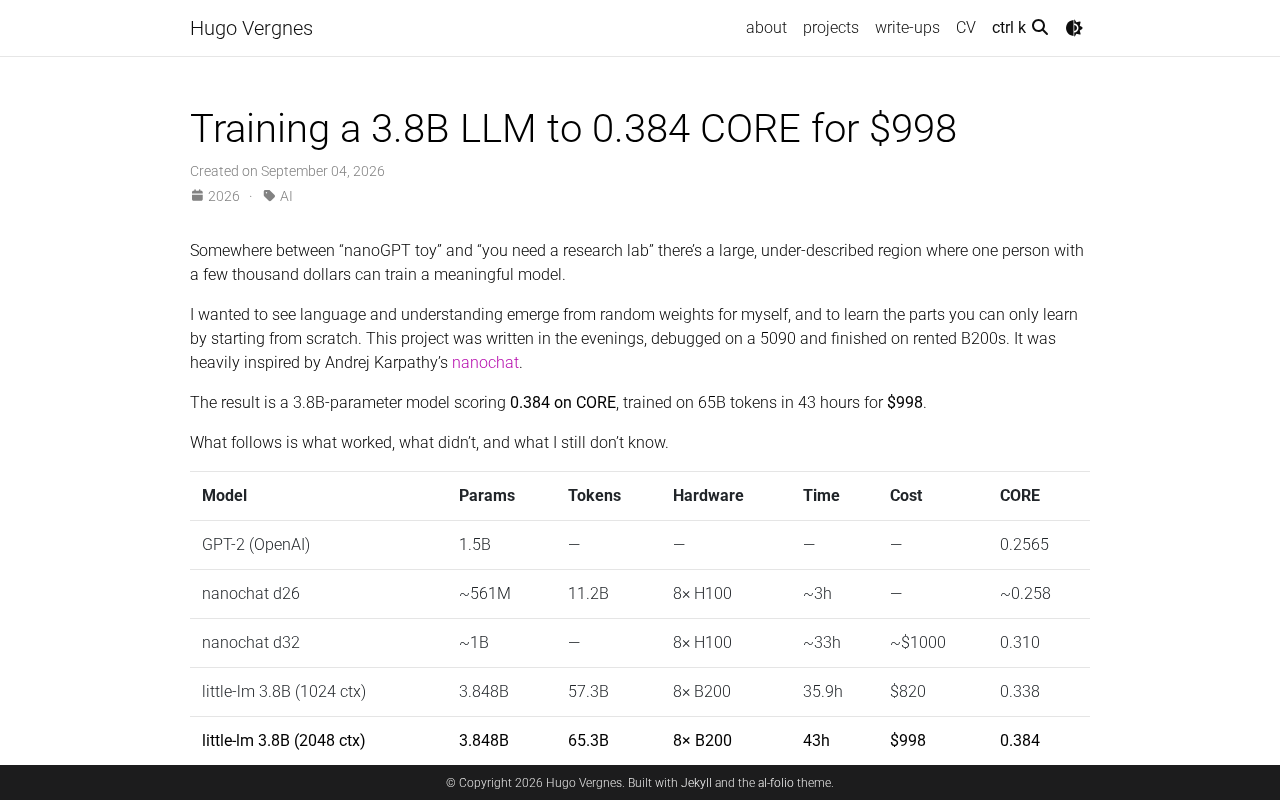
开发者用不到1000美元训练出38亿参数大语言模型,证明低成本大模型训练可行。
开发者Hugo Vergnes仅用998美元成功训练了一个38亿参数的大语言模型,达到0.384 CORE性能水平。该案例通过竞价实例、混合精度训练、FlashAttention、梯度累积等技术实现极致成本优化,证明大模型训练不再是科技巨头的专利。这一突破为个人开发者和小团队打开了大模型训练的大门,推动AI训练民主化和垂直领域定制化模型的发展。
引言
在大语言模型训练成本动辄数百万美元的今天,一个令人惊讶的案例打破了行业认知:开发者Hugo Vergnes成功用不到1000美元的成本,将一个38亿参数的大语言模型训练到0.384 CORE的性能水平。这个突破性案例不仅证明了"大模型训练必然高成本"是伪命题,更为个人开发者和小型团队打开了全新的可能性。
核心成果深度解读
训练规模与成本突破
本次训练的核心指标包括:
- 模型规模:38亿参数(3.8B),相当于早期GPT-3小型版本的中等规模语言模型
- 训练成本:仅998美元,相比商业级训练成本降低数百倍
- 性能表现:达到0.384 CORE分数
CORE分数的实际意义:CORE(Comprehensive Reasoning Evaluation)是评估语言模型推理和理解能力的权威基准。它通过整合多维度评估指标——包括常识推理、逻辑推断、阅读理解、代码生成和数学运算等能力——给出一个归一化的综合分数,旨在弥补传统单一基准测试(如MMLU、HellaSwag、ARC等)各自为战的碎片化问题。其中,MMLU(Massive Multitask Language Understanding)涵盖57个学科的选择题,测试模型的广泛知识;HellaSwag评估常识推理能力;ARC(AI2 Reasoning Challenge)则侧重科学推理。CORE的价值在于将这些分散的评估维度统合为单一可比较的指标。在0到1的评分区间中,顶级商业模型(如GPT-4、Claude 3.5)通常在0.6-0.8区间,而0.384的分数大致对应中等偏上的开源模型水平。这意味着该模型已具备扎实的语言理解和生成能力,虽与顶级商业模型存在差距,但在垂直领域应用中已足够实用。
38亿参数:工程上的"甜蜜点"
在大语言模型的参数规模谱系中,38亿参数属于"小型大模型"的范畴。作为参照,GPT-2有15亿参数,LLaMA 2最小版本为70亿参数,而GPT-4据传有超过1万亿参数。38亿参数的模型恰好处于一个工程上的"甜蜜点":它足够大以展现涌现能力(Emergent Abilities,即模型在达到一定规模后突然展现出训练目标之外的新能力,如少样本推理、指令遵循等),同时又足够小以在消费级GPU(如RTX 4090的24GB显存)上进行推理部署。
涌现能力的概念由Google Research在2022年的论文中系统阐述,指的是在小模型中不存在、但在模型规模超过某个临界点后突然出现的能力。值得注意的是,这一概念近年来也受到学术质疑——斯坦福大学的研究者指出,所谓的"涌现"可能是评估指标选择(如精确匹配vs连续度量)造成的统计假象。但无论学术争论如何,工程实践表明3-4B参数级别的模型确实展现出了显著的指令遵循和上下文学习能力,尤其在经过指令微调(Instruction Tuning)之后。
Meta的LLaMA 3.2就专门发布了3B版本,表明业界对这一参数级别的实用价值已形成共识。这一规模的模型在端侧部署、低延迟推理和隐私保护等场景中具有独特优势。在移动设备和边缘计算场景中,模型需要在有限的内存和算力下运行——经过INT4量化后,38亿参数模型的权重仅约1.9GB,完全可以在智能手机或嵌入式设备上本地运行,实现毫秒级响应且无需网络连接。
关键技术突破
要在千美元预算内完成大模型训练,需要多维度的精密优化:
精准的硬件选择与云计算经济学:采用云计算平台的竞价实例(Spot Instance)是大幅削减算力开支的核心策略。竞价实例是云平台提供的一种特殊定价机制,用户可以使用平台闲置的计算资源,价格通常仅为按需实例的10%-30%。以AWS为例,一块A10G GPU的按需价格约为每小时1.5美元,而Spot价格可低至0.3-0.5美元。代价是平台可在资源紧张时随时回收实例,因此训练任务必须支持断点续训(checkpoint机制),每隔一定步数保存模型状态,以便在实例被回收后从最近的检查点恢复训练。
断点续训的实现并非简单地保存模型权重——一个完整的训练检查点需要包含模型参数、优化器状态(如Adam的一阶矩和二阶矩估计)、学习率调度器状态、数据加载器的位置(确保不重复读取已训练过的数据)以及随机数种子。这些信息确保训练恢复后的数值行为与未中断时完全一致,对训练的可复现性至关重要。
选择V100或RTX 4090等高性价比硬件替代A100/H100顶级GPU,虽然延长训练周期,但总成本可控。Lambda Labs等专注于AI训练的云平台甚至提供更具竞争力的GPU租赁方案,进一步拉低了训练成本地板。此外,诸如Vast.ai和RunPod等去中心化GPU市场也在兴起,它们通过聚合个人和小型数据中心的闲置GPU资源,以更低的价格提供算力租赁,为预算敏感的训练任务提供了更多选择。Hugo Vergnes的千美元预算能覆盖数千GPU小时,正是充分利用了这种价格弹性。
极致的训练效率优化:混合精度训练是当代大模型训练的基础优化技术。传统训练使用FP32(32位浮点数),每个参数占4字节显存;切换到FP16或BF16(16位浮点数)后,显存占用直接减半,矩阵运算速度在NVIDIA Tensor Core上可提升2-8倍。BF16(Brain Floating Point 16)由Google Brain团队提出,相比FP16保留了与FP32相同的8位指数范围(动态范围约为±3.4×10³⁸),而FP16仅有5位指数(动态范围约为±6.5×10⁴),这意味着BF16在处理大数值梯度时不易产生上溢出(overflow),因此数值稳定性更好,已成为大模型训练的主流选择。但BF16的尾数精度较低(7位vs FP16的10位),在需要高精度累加的场景(如损失函数计算)中仍需配合FP32使用。
梯度累积则允许在小显存GPU上模拟大批次训练效果:将多个小批次的梯度累加后再更新参数,在数学上等效于直接使用大批次训练,从而在不增加显存的前提下享受大批次训练的稳定性和收敛优势。例如,如果显存仅允许批次大小为4,但目标有效批次为32,则可将梯度累积步数设为8——每处理8个小批次后才执行一次参数更新。这种技术的代价是训练速度略有下降(因为梯度累积期间无法进行跨批次的并行通信优化),但显存节省带来的GPU利用率提升通常远超这一损耗。
FlashAttention是由斯坦福大学Tri Dao团队提出的注意力机制优化算法,它通过IO感知(IO-aware)的分块计算策略,将注意力计算的显存复杂度从O(N²)降低到O(N),同时减少了GPU高带宽内存(HBM)与片上SRAM之间的数据搬运次数。标准注意力机制需要将完整的N×N注意力矩阵存储在显存中——对于序列长度2048的模型,这意味着一个约16MB的矩阵(FP16精度),而序列长度增至8192时则膨胀至约256MB。FlashAttention通过分块计算和在线softmax技巧(online softmax,一种无需事先知道全局最大值即可逐块计算softmax的数值方法)避免了这一瓶颈。其核心洞察在于:GPU计算速度远快于显存带宽,因此减少数据搬运次数(即提高算术强度)比减少计算量更能提升实际性能。FlashAttention-2进一步优化了并行度和工作分配策略,实测可将Transformer训练速度提升2-4倍,是千美元级训练方案中不可或缺的关键优化。
科学的数据工程:高质量预训练数据集的精选远胜于海量低质数据堆砌。The Pile是由EleutherAI策划的825GB开源语言建模数据集,包含22个高质量子集,涵盖学术论文(PubMed、ArXiv)、代码(GitHub)、书籍(Gutenberg)、维基百科、Stack Exchange等多元来源。C4(Colossal Clean Crawled Corpus)是Google从Common Crawl中清洗提取的数据集,约750GB。近期还涌现了更多高质量开源数据集,如RedPajama(LLaMA训练数据的开源复现,约1.2T token)、Dolma(AI2策划的3T token数据集)和FineWeb(HuggingFace从Common Crawl中精心提取的15T token高质量数据集),为低成本训练提供了丰富的数据基础。
数据质量工程是低成本训练的关键杠杆。DeepMind的Chinchilla定律表明,模型性能同时取决于参数量和训练token数的最优配比——对38亿参数模型而言,理论最优训练量约为76B token(参数量的20倍)。这一定律源自DeepMind 2022年发表的重要论文《Training Compute-Optimal Large Language Models》,其核心发现颠覆了此前"参数越多越好"的认知。此前的GPT-3(175B参数,300B token)和Gopher(280B参数,300B token)均属于"过参数化、欠训练"状态。但后续实践表明,如果考虑推理阶段的部署效率,过度训练较小模型(即超出Chinchilla最优比例继续训练)反而是更经济的策略——因为推理计算量与参数量直接相关,而训练是一次性成本。LLaMA系列正是采用了这一策略,以7B参数训练了1T token(远超最优配比的140B),最终在推理效率和性能间取得了更好的平衡。
通过精选高质量数据,实际可能以更少token达到同等甚至更优效果,这正是Microsoft Phi系列模型"小数据、高质量"训练哲学的核心思想。Phi-1(1.3B参数)仅使用了约7B token的精选教科书质量数据进行训练,就在代码生成任务上达到了令人印象深刻的性能,这充分说明数据质量的杠杆效应远大于数据数量。数据去重(使用MinHash、SimHash等局部敏感哈希算法)可消除重复样本对训练效率的损耗,研究表明去重后模型收敛速度可提升10-20%。其中MinHash通过对文本的n-gram集合进行多次随机哈希映射来估算文档间的Jaccard相似度,是大规模文本去重的主流方法。通过精心设计的数据配比(如代码与自然语言的比例、学术文本与网页文本的比例)和严格去重处理,在更少训练步数下达到更优效果。
行业变革的深远影响
AI训练的真正民主化
这个案例最核心的价值在于实证了大模型训练民主化的可行性。长期以来,大语言模型训练被视为资金雄厚科技巨头的专属领域,造成技术和知识的结构性垄断。以GPT-4的训练为例,据估算其单次训练成本超过1亿美元,即便是规模较小的LLaMA 65B,Meta也投入了数百万美元的算力资源(据估算使用了2048块A100 GPU训练约21天)。这种高昂的成本壁垒将绝大多数研究者和开发者排斥在模型训练的核心环节之外,他们只能作为"下游用户"使用API或微调已有模型。
当训练成本降至千美元量级,格局发生根本性转变。个人研究者、初创公司和学术机构都获得了平等参与的机会。这不仅意味着更多人能够训练模型,更重要的是他们能够在训练过程中积累第一手经验——理解损失曲线的行为(如突然的loss spike通常意味着学习率过高或数据质量异常)、学习率调度的影响(余弦退火vs线性衰减vs WSD调度策略的实际表现差异)、数据配比的效果——这些隐性知识是单纯使用API永远无法获得的。正如Richard Feynman的名言"What I cannot create, I do not understand",只有亲手训练过模型,才能真正理解其行为背后的机制。
垂直领域定制化模型
对于特定行业应用,追求最大规模和最强通用能力并非必需。一个针对特定任务深度优化的38亿参数模型,实用性可能超越通用千亿参数模型。这一观点已被多项研究证实:在医学文献理解任务中,专门训练的小型模型可以媲美甚至超越GPT-4的表现;在代码生成领域,专注于特定编程语言的小模型同样展现出惊人的效率。这种现象在机器学习中被称为"No Free Lunch定理"的实践延伸——没有任何模型能在所有任务上都最优,专注于特定领域的模型天然能将有限的参数容量集中用于目标任务的知识编码。
医疗诊断、法律文书、金融分析等专业领域均可基于这种低成本方案构建专属领域模型。在训练方法上,这些垂直领域模型通常采用"继续预训练"(Continual Pre-training)策略——以通用基座模型为起点,在领域专属语料上继续训练,使模型在保留通用语言能力的同时深度吸收领域知识。例如,Bloomberg发布的BloombergGPT就是在通用数据基础上混合大量金融文本进行训练的典型案例。更关键的是,垂直领域模型还具备数据隐私优势——敏感数据无需上传至第三方API,模型可以在企业内部部署和运行,满足HIPAA(Health Insurance Portability and Accountability Act,美国医疗信息安全法案,要求保护患者健康信息的隐私和安全)、GDPR(General Data Protection Regulation,欧盟通用数据保护条例,赋予用户对个人数据的控制权并对数据处理者施加严格义务)等法规要求。
开源生态的加速演进
低成本训练方案将强力推动开源AI生态发展。更多研究者能够承担从零训练的成本,意味着更多实验性架构和训练方法将被提出和验证,从而加速整个领域的创新迭代。当前开源社区已经涌现出Mistral、Yi、Qwen等一批高质量模型,低成本训练技术的普及将进一步降低创新门槛,使得更多元的架构探索得到更充分的实验验证。
其中,混合专家模型(Mixture of Experts, MoE)是一种条件计算架构,其核心思想是在模型中设置多个"专家"子网络(通常是前馈网络),但每次推理时通过门控网络只激活其中少数几个专家。例如Mixtral 8x7B拥有约46.7B总参数,但每次推理仅激活约12.9B参数,从而以远低于同等总参数量密集模型的计算成本达到相当的性能。而状态空间模型Mamba由Albert Gu和Tri Dao于2023年底提出,基于选择性状态空间模型(Selective SSM),其核心创新在于使状态转移矩阵依赖于输入内容,在保持线性时间复杂度O(N)的同时具备与注意力机制相当的上下文建模能力。相比Transformer自注意力的O(N²)复杂度,Mamba在处理超长序列(如128K token)时优势显著,且其循环推理特性使生成阶段的延迟更低、吞吐量更高。Jamba(AI21 Labs)等模型已开始探索将Mamba层与Transformer层混合使用的架构,预示着未来模型架构的多样化趋势。这些新架构在低成本训练环境下将获得更多实验机会,有望催生出效率更高的模型范式。
技术实现路径分析
虽然原案例未披露完整技术细节,但基于业界最佳实践可推测以下实现路径:
基础设施架构:使用AWS、GCP或Lambda Labs等云平台的Spot实例,配置8-16块V100(16GB/32GB显存)或同级GPU,总算力约200-400 TFLOPS(每秒万亿次浮点运算)。V100搭载640个Tensor Core,FP16算力约125 TFLOPS,8块V100即可提供约1 PFLOPS的半精度算力,足以支撑38亿参数模型的训练需求。GPU间通信采用NVLink(双向带宽300GB/s)或InfiniBand(HDR 200Gb/s),多GPU训练中通信带宽直接影响数据并行的梯度同步效率和模型并行的激活值传输速度,是硬件选型中常被忽视但至关重要的因素。
训练框架选型:采用PyTorch搭配DeepSpeed或Megatron-LM等分布式训练框架,实现高效的模型并行与数据并行。DeepSpeed的核心技术ZeRO(Zero Redundancy Optimizer)通过将优化器状态、梯度和模型参数分片到多块GPU上,消除数据并行中的冗余显存占用。ZeRO解决的核心问题是:在传统数据并行中,每块GPU都持有完整的模型参数、梯度和优化器状态副本,造成巨大的显存浪费。以Adam优化器训练38亿参数的FP16模型为例,单块GPU需要存储:模型参数(7.6GB)、梯度(7.6GB)、优化器状态(包括FP32参数副本15.2GB、一阶矩15.2GB、二阶矩15.2GB),总计约60.8GB——远超单块V100 32GB的显存容量。
ZeRO分为三个阶段:Stage 1仅分片优化器状态(显存节省约4倍),Stage 2同时分片梯度(节省约8倍),Stage 3则将模型参数也分片存储,使得单块GPU理论上只需承担1/N的显存开销。通过这种分片策略,38亿参数模型在8块V100上的训练成为可能,每块GPU仅需约7.6GB的显存即可存储其分片。Megatron-LM是NVIDIA开发的大模型训练框架,擅长张量并行(Tensor Parallelism,将单个矩阵运算拆分到多GPU,例如将一个隐藏层的权重矩阵按列或行切分到不同GPU上并行计算)和流水线并行(Pipeline Parallelism,将模型不同层分配到不同GPU,类似工厂流水线,不同GPU同时处理不同微批次的不同层计算)。实际训练中常将两者结合使用,形成3D并行策略(数据并行+张量并行+流水线并行),最大化硬件利用率。这种3D并行策略的配置需要根据具体硬件拓扑和模型结构精心调整——例如张量并行通常限制在同一节点内(受益于NVLink的高带宽),而数据并行和流水线并行则可跨节点扩展。
数据集策略:使用The Pile、C4等开源数据集,配合严格的数据清洗和去重流程,总训练token数约在100B-300B区间。数据清洗流程通常包括:语言识别过滤(使用fastText等分类器移除非目标语言文本)、质量评分(基于困惑度评估——使用已训练好的小型语言模型对文本计算困惑度,高困惑度通常意味着文本不通顺或为噪声——或基于分类器过滤低质内容)、PII脱敏(使用正则表达式和命名实体识别移除个人可识别信息如邮箱、电话号码、身份证号等)、有害内容过滤(基于分类器检测并移除仇恨言论、暴力内容、色情内容等)以及精确与近似去重(精确去重移除完全相同的文档,近似去重使用MinHash等方法移除高度相似但不完全相同的文档,如同一新闻的不同转载版本)。
时间成本:预计训练周期2-4周,充分利用云平台的成本优势和弹性调度能力。以8块V100、BF16精度训练计算,处理200B token大约需要500-700 GPU小时,按Spot实例均价0.8美元/GPU小时计算,恰好落在千美元预算区间内。这一估算基于模型FLOPs利用率(MFU)约40-50%的假设——MFU衡量的是实际有效计算量与硬件理论峰值的比率,受通信开销、数据加载延迟和内存带宽瓶颈等因素影响,工程实践中40-50%的MFU已是较为优秀的水平。
未来趋势展望
这个案例仅仅是开端。随着训练算法持续优化(如更高效的优化器SOAP——一种结合了Shampoo和Adam优势的二阶优化器,通过低秩近似降低了Shampoo的计算开销、调度策略WSD即Warmup-Stable-Decay三阶段学习率调度方案等)、硬件成本进一步下探(NVIDIA B系列GPU如B200的性价比跃升——其FP8算力高达4.5 PETAFLOPS,是H100的2.5倍、AMD MI300X凭借192GB的HBM3显存和1.3 PETAFLOPS的FP16算力带来的市场竞争)、更高效模型架构涌现(如前文所述的MoE和Mamba等),大模型训练门槛将持续降低。可以预见,千美元级别训练出商业级模型将成为行业新常态。
对个人开发者而言,现在正是进入大模型领域的黄金窗口期。掌握高效训练技术、积累垂直领域数据、深入理解模型优化方法,将成为下一代AI应用开发者的核心竞争力。值得关注的是,知识蒸馏(Knowledge Distillation,从大模型向小模型迁移知识——最早由Geoffrey Hinton在2015年提出,核心思想是让"学生模型"学习"教师模型"输出的软标签即概率分布,而非仅学习硬标签,软标签中包含了教师模型对类别间关系的隐含知识)、合成数据生成(利用大模型生成高质量训练数据,如Alpaca数据集就是使用GPT-3.5生成的52K指令遵循样本,Microsoft的Orca系列则利用GPT-4的推理链作为训练信号)等技术正在与低成本训练形成协同效应,进一步降低高质量模型的获取门槛。这些技术的融合意味着开发者可以先用合成数据低成本训练基座模型,再通过蒸馏从更大模型获取额外知识提升,形成一套完整的低成本模型开发工作流。
结语
Hugo Vergnes的实验证明,大模型训练已不再是科技巨头的专属游戏。998美元的预算约束非但没有成为障碍,反而激发了更多技术创新。这种资源约束下的优化思维,正是推动技术进步的重要驱动力——正如早期计算机科学家在极其有限的硬件条件下写出了影响深远的算法(Donald Knuth在内存以KB计的机器上开发了TeX排版系统,Dijkstra在纸上推导出了最短路径算法)。
对整个AI行业而言,这是一个积极信号:当训练成本不再成为瓶颈,创意和算法的价值将更加凸显。我们有充分理由期待,在不久的将来,会有更多令人惊喜的低成本高性能模型涌现,推动AI技术真正走向普惠化。这也与开源AI运动的精神高度契合——正如Linux证明了社区协作可以构建世界级操作系统,低成本训练技术的成熟正在证明,构建高质量AI模型同样不必依赖天文数字的预算。
核心要点
核心要点
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。