DialFork:对话智能体的过程幻觉评测新基准

IDIAP 发布 DialFork,首个评测对话智能体「过程幻觉」的基准,用流程相似度替代语义相似度。
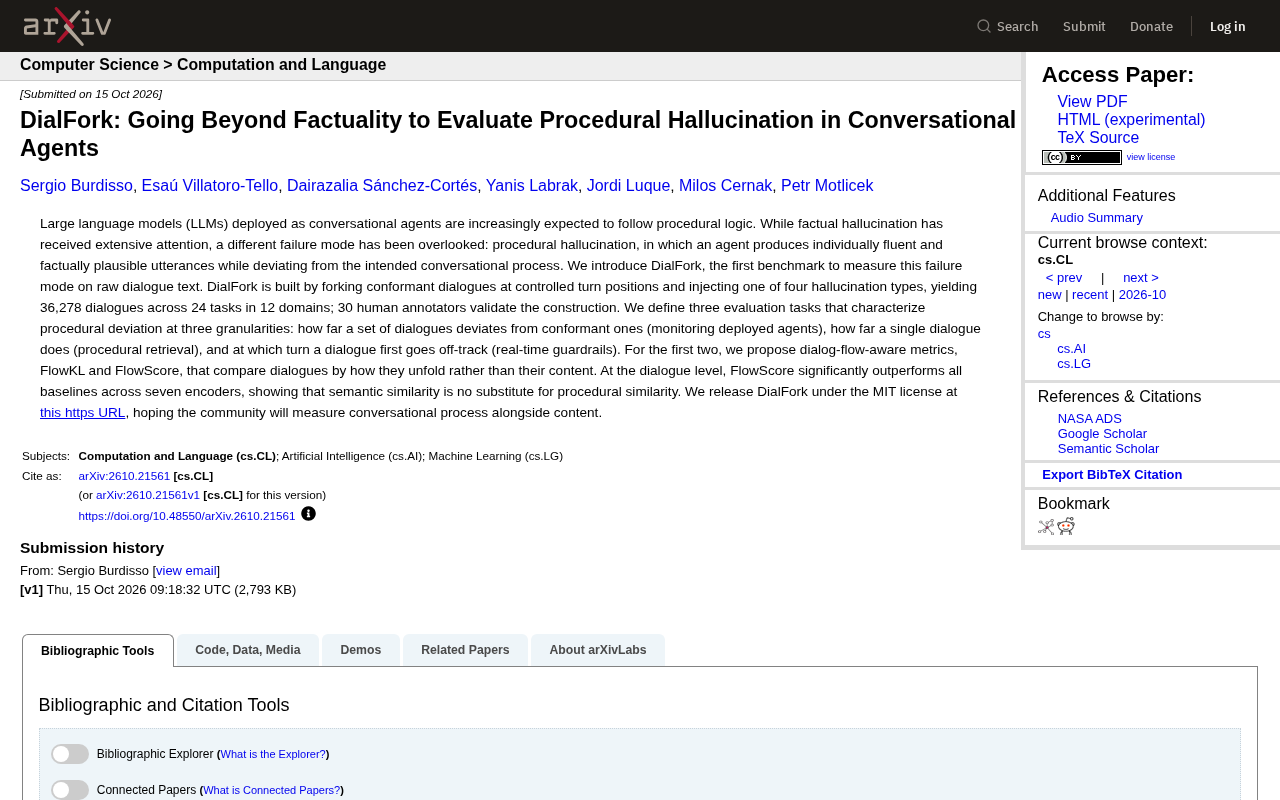
IDIAP 研究团队提出「过程幻觉」概念,指对话智能体每句话单独看都流畅无误,却偏离了本该遵循的业务流程,在客服、问诊等强流程场景中代价极高。为此他们发布首个面向原始对话文本的评测基准 DialFork,通过「受控分叉」方式在规范对话的指定轮次注入四类流程偏离,构建了覆盖 24 个任务、12 个领域、36,278 段对话的数据集,并由 30 名人类标注者验证。基准将评测拆成三种粒度:对话集偏离监控、单条对话偏离检索、首次跑偏轮次定位,并配套提出 FlowKL 与 FlowScore 两个流程指标,在七种编码器上显著优于基线,证明语义相似度无法替代流程相似度。
对话式AI的评测长期聚焦在「说了什么」——事实是否正确、知识是否准确。但当大语言模型被部署为对话智能体时,另一类失败模式几乎被忽视:它说的每句话单独看都流畅、合理、事实无误,却偏离了本该遵循的对话流程。来自 IDIAP 的研究团队把这种现象命名为过程幻觉(procedural hallucination),并发布了首个面向原始对话文本的评测基准 DialFork。
事实幻觉之外:被忽视的「流程跑偏」
事实幻觉的问题很直观:模型说错了话。过程幻觉则更隐蔽——模型没有说错任何一句,但它在该确认身份时直接跳到了退款、在该收集必要信息时提前给结论、在需要等待用户确认时自作主张推进下一步。单句质量毫无破绽,整体流程却已脱轨。
这类失败在客服、订票、医疗问诊、金融办理等强流程场景中代价极高。传统评测用语义相似度、事实一致性等指标衡量输出,恰恰对流程偏离不敏感:一段跑偏的对话,可能在语义上与标准对话高度接近。研究团队的核心判断是,语义相似度不能替代流程相似度,评测必须换一套度量方式。
DialFork 是怎么构造的
DialFork 的构造思路是「在受控位置分叉」。研究团队先准备符合预期流程的规范对话(conformant dialogues),然后在指定的轮次位置切出分支,注入四种类型的幻觉,让对话从这里开始偏离原定轨道。
最终数据集包含 24 个任务、12 个领域,共 36,278 段对话。全部构造过程由 30 名人类标注者验证,确保注入的偏离在人工判断下确实构成流程错误,而非无意义的随机扰动。这种「以规范对话为基准、按轮次受控注入」的设计,使得偏离的程度和位置都可量化,而不是依赖事后主观判断。
数据集以 MIT 许可证开源,托管在 https://github.com/idiap/dialfork,便于社区直接接入既有评测流程。
过程幻觉与受控分叉的关系:《DialFork》的「受控分叉」灵感来自软件测试中的「故障注入」(fault injection)思想。传统对话数据集往往只记录真实用户与智能体的交互,其中天然包含大量闲聊、寒暄和无关轮次,流程偏离的边界模糊;而 DialFork 先由人工撰写完全符合业务规范的标准流程(如「先确认身份→核对订单→确认退款金额→等待用户确认→执行退款」),再在特定轮次强制让模型执行「跳步」「提前结论」「绕过确认」等错误动作。这样的构造使「偏离起点」「偏离类型」「偏离长度」都成为可独立控制的变量,从而把原本主观的「这对话怪怪的」转化为可复现、可统计的量化实验条件。
三种粒度:监控、检索与实时护栏
DialFork 把过程偏离的评测拆成三个不同粒度的任务,对应部署场景中的三类需求:
- 对话集偏离度量(monitoring deployed agents):衡量一整批对话相对规范流程偏离了多远,用于线上智能体的持续监控。
- 单条对话偏离度量(procedural retrieval):判断一段单独对话偏离了多少,可用于检索相似流程轨迹。
- 首次跑偏轮次定位(real-time guardrails):找出对话在哪一轮第一次脱轨,是实时护栏能否及时介入的关键。
前两个任务对度量方法提出了新要求:不能比较内容,而要比较对话「如何展开」。为此团队提出两个面向对话流的指标 FlowKL 和 FlowScore。
FlowScore:用流程相似度替代语义相似度
在对话级别的评测中,FlowScore 在七种编码器上显著优于所有基线方法。这一结果直接支撑了团队的核心论点——语义相似度无法替代流程相似度。换句话说,即便两段对话在语义空间里挨得很近,它们遵循的流程逻辑可能完全不同,而现有指标对此几乎无感知。
这套指标的意义在于给出了可落地的度量方式:把「对话是否按正确顺序推进」变成一个可计算、可比较的分数,从而支持监控、检索与实时护栏三类实际需求。
FlowKL 与 FlowScore 的技术直觉:FlowKL 借鉴了 Kullback–Leibler 散度(KL divergence)的思想,把对话视为一条「流程状态转移链」,计算两段对话在各轮次上「下一步动作类型」分布之间的差异,从而惩罚动作顺序上的偏离;FlowScore 则是一个归一化后的可解释分数,便于直接比较不同长度、不同领域的对话。二者都不依赖词面或语义嵌入的相似度,而是把对话抽象为「意图—动作」序列后做序列级比对。这样设计的直接好处是:两段用词完全不同但流程完全一致的对话会得到高分,而两段用词高度相似但步骤错乱的对话会被判为低分。
对行业的实际影响
DialFork 补上了对话智能体评测中的一块空白。对于正在把 LLM 部署进强流程业务(客服、预约、问诊、交易办理)的团队,这意味着:
单句质量的优化无法解决流程幻觉。 模型可能在每个局部都表现优秀,整体却不可靠,评测必须显式纳入流程维度。
护栏需要轮次级判断能力。 定位「第一次跑偏」的轮次,比事后判断整段对话是否正确更有实际价值,因为它决定了介入时机。
评测标准需要与内容评测并行。 团队在发布说明中的期望很明确:希望社区在测量内容之外,也开始测量对话过程。
当智能体从「答对问题」走向「办成事情」,流程本身就是产品能力的一部分。DialFork 提供的,正是衡量这部分能力的第一把尺子。
背景补充
实时护栏与轮次级评测:实时护栏(real-time guardrails)指的是在对话进行中实时监控智能体输出、并在检测到风险时立即干预(如强制追问、阻断当前响应、转人工)的机制。这类系统对延迟极其敏感,因此不能等整段对话结束再做判断。DialFork 把「首次跑偏轮次定位」单独列为一项任务,正是因为护栏必须在偏离发生的那一轮就做出反应。评估该任务时,指标不再是比较整段对话的最终结果,而是看模型能否在正确的轮次位置精确标记出「从这里开始流程已经不对」。这一任务难度高于事后判断,因为随着对话推进,偏离信号会被后续看似正常的回复稀释。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。