Dify工作流搭建全攻略:零代码构建AI应用实战指南

什么是Dify?零代码AI应用构建平台
Dify是一款面向普通用户和开发者的AI应用构建平台,最大的特点是无需编写任何代码,就能快速搭建各类AI应用。与许多人接触过的Coze等工具相比,Dify在应用类型的丰富度上更胜一筹。
从技术架构上看,Dify属于LLMOps(大语言模型运维)平台的范畴。LLMOps是MLOps概念在大语言模型时代的延伸——MLOps本身脱胎于DevOps理念,旨在将软件工程的持续集成/持续交付(CI/CD)实践引入机器学习模型的全生命周期管理。MLOps的技术债务问题最早由Google于2015年在论文《Hidden Technical Debt in Machine Learning Systems》中系统阐述,揭示了数据管道、特征工程、模型监控等工程环节才是ML系统落地的真正挑战。随着GPT-4、Claude、文心一言等大语言模型的商业化落地,企业面临的挑战不再仅仅是"如何训练模型",而是"如何将模型能力稳定、高效地集成到业务系统中"。LLMOps在继承传统MLOps挑战的同时,还引入了大语言模型特有的新问题:提示词版本管理(Prompt Versioning)、幻觉检测与评估、Token成本控制、多模型路由策略等。LLMOps平台因此应运而生,统一处理提示词版本管理、模型A/B测试、调用成本监控、输出质量评估等运维问题。Dify在这一赛道中的差异化定位是"面向非技术用户的LLMOps"——它将提示词工程、模型管理、数据处理、应用编排等复杂的AI开发环节抽象为可视化的操作界面,大幅降低了AI应用的开发门槛。用户无需理解底层的API调用逻辑或模型推理机制,只需通过拖拽和配置即可完成应用搭建。
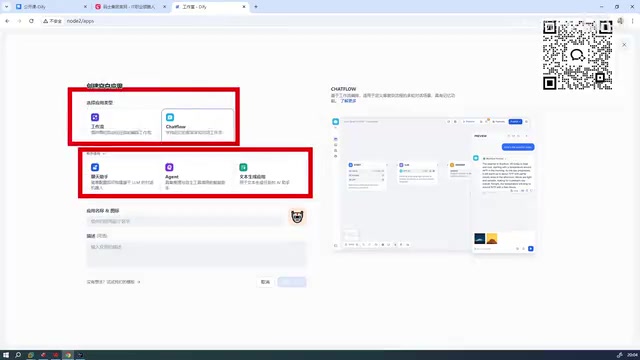
目前Dify支持五种应用类型:前三种偏向新手使用(包括聊天助手、Agent等),后两种则是更高阶的工作流(Workflow)和Chatflow。
其中,**Agent(智能体)**是AI领域中一个重要概念,指的是能够自主感知环境、做出决策并执行行动的AI系统。与简单的问答式AI不同,Agent具备工具调用能力——它可以根据用户需求自主判断需要使用哪些工具(如搜索引擎、计算器、数据库查询等),按照什么顺序执行,并将多步操作的结果整合后返回给用户。这种"思考-行动-观察"的循环机制在学术界有一个正式名称:ReAct(Reasoning + Acting)框架,由谷歌研究院于2022年提出。其核心思想是让大语言模型在生成最终答案之前,先输出交替的"推理轨迹"(Thought)和"行动指令"(Action),每次行动后观察环境反馈(Observation),再决定下一步推理。
在Dify的Agent实现中,工具调用通常基于OpenAI的Function Calling规范——这一规范于2023年6月正式推出,已成为AI Agent工具调用的事实标准,被Anthropic、Google等主流模型厂商相继采纳。其工作机制是:开发者通过JSON Schema格式向模型描述可用工具的名称、功能说明和参数规范,模型在推理过程中会判断是否需要调用工具,若需要则输出结构化的函数调用请求(包含函数名和参数值),而非直接生成自由文本答案。这种机制的关键优势在于输出的确定性——模型不再是在自由文本中"描述"它想做什么,而是输出机器可直接解析执行的结构化指令。2024年推出的Parallel Function Calling进一步允许模型在单次推理中同时请求多个工具调用,显著提升了复杂任务的执行效率。
值得一提的是,Dify 1.8.0版本还引入了对MCP(Model Context Protocol)协议的支持。MCP是Anthropic于2024年11月发布的开放标准,旨在统一大语言模型与外部工具、数据源之间的通信接口。在MCP出现之前,每个AI平台都有自己的工具调用规范,开发者需要为不同平台重复开发适配层,造成大量重复劳动。MCP采用客户端-服务器架构:MCP Server负责暴露工具能力(如文件系统访问、数据库查询、第三方API调用),MCP Client(即AI应用)按标准协议发起调用,实现了工具生态的互通复用。这意味着社区开发的MCP Server可以被任何支持该协议的AI平台直接使用,极大丰富了Dify的工具生态。这与早期基于规则的机器人有本质区别:Agent的工具选择是模型自主推理的结果,而非预设的if-else逻辑,使Agent能够处理远比单轮对话复杂的任务。
工作流和Chatflow虽然本质上属于同一大类,但在交互形式和适用场景上有明显差异——工作流(Workflow)采用的是DAG(有向无环图)架构。DAG是计算机科学中描述任务依赖关系的经典数据结构,在Apache Airflow、Apache Spark等大数据调度系统中被广泛采用。"有向"意味着数据流动有明确方向,"无环"则保证不存在死锁情况,确保工作流能够有确定的起点和终点。DAG架构的优势还在于支持并行执行——当多个节点的前置依赖都已满足时,可以同时触发,显著提升复杂流程的执行效率。在Dify的Workflow中,数据从起始节点单向流动到结束节点,适合处理如批量文档摘要、数据清洗、定时报告生成等不需要用户中途干预的自动化任务。Chatflow则在工作流的基础上引入了对话记忆和用户交互节点,允许流程在执行过程中暂停等待用户输入,适合构建多轮对话机器人、客服系统等需要持续交互的场景。两者共享相同的节点组件库,但在触发方式和状态管理上有本质区别。
Dify在国内AI工具中的定位
企业级AI工具推荐排序
在当前主流的AI应用构建工具中,包括Coze、Dify、RagFlow、N8N等,从企业级使用角度来看,推荐排序如下:
- 第一梯队:Dify — 功能最全面,用户友好度最高
- 第二梯队:Coze — 同样具备较强的易用性
- RagFlow和N8N等工具则相对可以暂缓学习
这里简单介绍一下后两者:RagFlow是一款专注于RAG(检索增强生成)场景的开源工具,在文档解析和知识库构建方面有独到之处,但应用类型较为单一;N8N则是一款通用的工作流自动化平台,虽然功能强大,但并非专为AI应用设计,学习曲线相对陡峭,且在中文生态和国内模型接入方面不如Dify和Coze便捷。
之所以如此推荐,核心原因在于:Dify和Coze这两款国内平台在功能支撑的完善度上明显更优,支持的功能种类更多。同时在易用性和用户友好性方面,也做到了同类产品中的最佳水平。
Dify与Coze的关键区别
Coze主要支持两种AI应用形式:普通AI应用和带Email功能的AI应用。而Dify支持五种应用类型,覆盖面更广。对于企业级应用场景,Dify的工作流能力和自部署特性(基于Docker)使其在数据隐私保护和定制化开发方面具备天然优势。
**私有化部署(Self-hosted)**意味着企业可以将整个AI平台运行在自己的服务器或私有云上,所有数据(包括用户对话记录、知识库文档、模型调用日志等)都不会离开企业的网络边界。这对于金融、医疗、法律等对数据合规性要求极高的行业至关重要——这些行业通常需要遵守GDPR、等保2.0、HIPAA等数据安全法规,数据出境或存储于第三方服务器可能面临严重的合规风险。相比之下,SaaS模式虽然使用便捷,但数据需要传输到第三方服务器,存在潜在的数据泄露和合规风险。Dify的开源特性还允许企业对源码进行审计和二次开发,进一步增强了安全可控性。
Dify 1.8.0版本部署实战
环境准备与安装步骤
当前教程基于Dify最新的1.8.0版本,相较于老版本,部署流程已经大幅简化。以下是完整的Docker部署步骤:
在开始之前,先简要说明Docker部署的技术背景:Docker是2013年由Solomon Hykes发布的容器化技术,其核心创新在于利用Linux内核的cgroups和namespace机制实现进程级别的资源隔离——Namespace实现进程、网络、文件系统等资源的视图隔离(每个容器"看到"的是独立的系统环境),cgroups(Control Groups)实现CPU、内存、磁盘I/O等资源的配额限制。相比传统虚拟机(VM)省去了完整操作系统的开销,启动时间从分钟级降至秒级,资源占用减少60%-80%。Docker镜像还采用分层存储(Union File System)架构,多个容器可以共享相同的基础层,只有差异层需要额外存储空间,这也是为什么Dify各服务容器的总磁盘占用远小于各镜像大小之和。它将应用程序及其所有依赖项打包到一个标准化的单元中,确保在任何环境中都能一致运行。
Docker Compose则是Docker的编排工具,通过一个YAML配置文件定义多个容器服务之间的关系和启动顺序。Dify作为一个采用微服务架构的复杂平台,通常包含多个独立服务:Nginx负责流量入口和SSL终止,API服务处理业务逻辑,Worker服务处理异步任务(如文档向量化),PostgreSQL存储结构化数据,Redis提供缓存和消息队列,向量数据库(Weaviate或Qdrant)存储文档的向量嵌入。理解这一架构有助于在遇到性能瓶颈时针对性地扩容特定服务。Docker Compose能够一键协调这些组件的启动和通信,免去了逐个手动配置的繁琐过程。
第一步:解压安装包
cd dify
# 解压Dify安装包
第二步:配置环境变量
进入Dify的Docker目录,找到.env.env文件,将其重命名为.env即可。这个文件包含了所有必需的环境变量配置,包括数据库连接信息、密钥、存储路径等关键参数。老版本需要手动做额外的环境配置,1.8.0版本已经省去了这些步骤,基本做到开箱即用。
第三步:启动Docker容器
docker compose up -d
一条命令即可将整个Dify平台启动起来。其中-d参数表示以后台守护进程(Daemon)模式运行,容器启动后终端不会被占用。如果需要查看启动日志排查问题,可以使用docker compose logs -f命令实时跟踪;使用docker compose ps可以查看各服务容器的运行状态,确认所有组件均已正常启动。
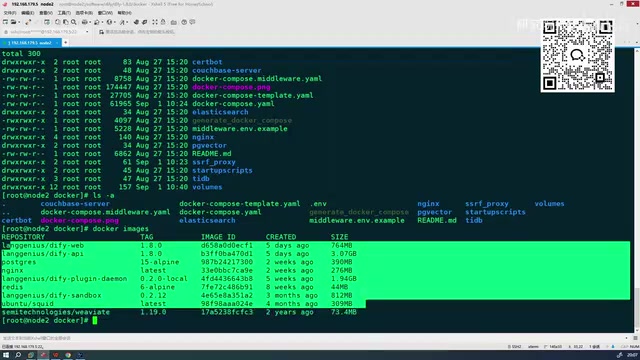
镜像大小与下载速度
1.8.0版本对应的Docker镜像总计大约在5-6GB左右,10GB磁盘空间绑绑有余。与之前的版本相比,新版本的镜像下载速度有了显著提升,很短时间内就能完成全部下载并启动服务。更重要的是,之前版本中存在的诸多bug在新版本中已经修复,整体稳定性有了明显改善。
需要注意的是,如果在国内网络环境下拉取Docker镜像速度较慢,建议配置国内镜像加速器(如阿里云广告容器镜像服务、中科大镜像等),或者使用离线镜像包的方式进行部署。镜像加速器的原理是在国内CDN节点缓存Docker Hub的镜像内容,通过修改Docker的/etc/docker/daemon.json配置文件指定registry-mirrors地址即可生效。
登录与管理界面概览
启动完成后,通过浏览器访问部署节点的地址(默认端口通常为80或自定义端口)即可进入Dify管理界面。首次访问时需要设置管理员账号和密码。界面主要包含以下几个核心模块:
- 探索:浏览和发现社区共享的AI应用
- 工作室:创建和管理自己的AI应用(核心功能区)
- 知识库:管理RAG所需的文档和数据
- 工具:集成和管理外部工具与API
其中知识库模块承载的是RAG(Retrieval-Augmented Generation,检索增强生成)能力。RAG由Meta AI研究院于2020年正式提出,是当前企业级AI应用中最重要的技术架构之一。其工程实现分为两个阶段:离线索引阶段,文档经过分块(Chunking)处理后,通过嵌入模型(如text-embedding-ada-002或BGE系列)转换为高维向量,存入向量数据库;在线检索阶段,用户查询同样被向量化,通过余弦相似度或近似最近邻(ANN)算法找到最相关的文档片段,拼接到提示词中送入大模型。
向量数据库是RAG架构的核心基础设施,其技术原理值得深入理解。传统关系型数据库通过精确匹配检索数据,而向量数据库通过计算高维向量之间的相似度来实现语义检索。文本经过嵌入模型处理后,会被转换为通常512到4096维的浮点数向量,语义相近的文本在这个高维空间中距离更近。为了在海量向量中实现毫秒级检索,向量数据库通常采用HNSW(Hierarchical Navigable Small World)图算法等近似最近邻技术——该算法通过构建多层级的"小世界"导航图,在检索时从顶层稀疏图快速定位候选区域,再逐层下钻到底层密集图精确匹配,以牺牲极小精度换取数量级的检索速度提升。除HNSW外,**IVF(Inverted File Index)通过K-means聚类将向量空间分区,检索时只扫描最近的若干分区,适合超大规模(亿级)数据集;Google开源的ScaNN(Scalable Nearest Neighbors)**则在精度与速度之间提供更灵活的权衡配置。Dify默认集成了Weaviate和Qdrant等开源向量数据库,企业也可以对接Pinecone、Milvus等商业或自建方案,根据数据规模和延迟要求灵活选择。
RAG有效解决了大模型的"幻觉"问题和知识时效性问题,是企业将私有数据与AI能力结合的主流方案。RAG的工程挑战主要集中在Chunk Size的选择(过小丢失上下文,过大引入噪声)、混合检索策略(结合关键词检索BM25和向量检索)以及检索结果的重排序(Reranking)等环节。在Dify中,你可以上传PDF、Word、网页等多种格式的文档,平台会自动完成文本分割、向量化和索引构建,并提供可视化界面对上述参数进行调优。
工作室是最核心的模块,所有AI应用的创建都从这里开始。点击"创建空白应用"即可开始搭建你的第一个AI应用。
新版本使用注意事项
虽然1.8.0版本整体表现优秀,但实际使用中仍存在一些小问题需要留意。新版本与之前版本在某些细节上有所不同,可能会成为初学者的"坑"。常见的问题包括:部分插件的兼容性变化、环境变量命名的调整、以及某些API接口的版本升级等。
这也是为什么跟随最新版本的教程学习尤为重要——网上许多教程基于老版本,配置方式和操作流程可能已经过时,照搬容易踩坑。建议在遇到问题时优先查阅Dify官方GitHub仓库的Issue区和官方文档,社区活跃度较高,大部分常见问题都能找到解决方案。Dify的GitHub仓库目前已积累数万Star,是国内开源AI应用平台中社区生态最为活跃的项目之一,这也意味着问题修复和功能迭代的速度相对较快。
Dify学习路径与总结
Dify凭借零代码操作、多应用类型支持、私有化部署等特性,成为当前国内最值得学习的AI应用构建平台。对于初学者,建议按照以下路径循序渐进:
-
先掌握基础应用:从聊天助手、Agent等新手友好的应用类型入手,理解提示词工程(Prompt Engineering)的基本原则。提示词工程的核心技术包括:零样本提示(Zero-shot)、少样本提示(Few-shot,通过提供示例引导模型输出格式)、思维链提示(Chain-of-Thought,要求模型逐步推理)以及结构化输出约束(通过JSON Schema限定输出格式)。在企业级实践中,提示词工程还涉及更多高级策略:提示词注入防御(Prompt Injection Defense)——防止恶意用户通过精心构造的输入覆盖系统提示词,通常通过输入过滤和角色权限分离实现;提示词压缩(Prompt Compression)——在Token成本敏感的场景下,使用LLMLingua等技术压缩上下文长度而不损失关键信息;提示词评估(Prompt Evaluation)——建立自动化测试集,量化评估提示词变更对输出质量的影响,类似软件工程中的单元测试。值得关注的是,Dify还内置了提示词版本控制功能,支持类似Git分支管理的提示词迭代机制——团队成员可以在不同版本的提示词上并行实验,通过内置的A/B测试框架对比各版本在准确率、用户满意度等指标上的表现,再将优胜版本合并到主干。这种将软件工程最佳实践引入提示词管理的设计理念,是Dify相比Coze等工具在企业级场景中的重要差异化能力。在企业级应用中,提示词通常分为系统提示词(System Prompt,定义AI角色和行为规范)和用户提示词(User Prompt,承载实际业务输入)两层,Dify的提示词编辑器支持变量插值(使用{{variable}}语法),使同一套模板可以通过注入不同的业务参数适配多种场景,有效避免了为每个细分场景单独维护提示词的管理混乱问题。
-
再深入工作流:理解Workflow和Chatflow的区别与各自适用场景,掌握条件分支、变量传递、循环等流程控制逻辑,以及DAG架构下并行节点的设计思路
-
结合知识库:学习RAG相关的知识库配置,包括文档分割策略(chunk size的选择)、向量模型的选用、混合检索策略(BM25关键词检索与向量检索的结合)、以及Reranking重排序的调优,构建具备领域知识的AI应用
-
工具集成:掌握外部API和工具的接入方法,如HTTP请求节点、自定义代码节点、第三方服务集成等,扩展应用能力边界。随着MCP协议生态的快速成熟,越来越多的第三方服务正在发布官方MCP Server,Dify用户可以直接复用这些现成的工具能力,而无需自行开发API适配层,这将进一步降低工具集成的技术门槛。
掌握Dify这样的平台级工具,能够让你在不写一行代码的情况下,快速将AI能力落地到实际业务场景中。无论是个人项目还是企业需求,Dify都能提供从原型验证到生产部署的完整支撑。随着大模型技术的持续演进,掌握这类AI应用编排平台的使用能力,将成为技术从业者和业务人员的重要竞争力。
核心要点
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。