Dify 本地部署实战:Docker 安装到大模型接入全流程
手把手讲解 Dify 本地部署全流程,从 Docker 环境准备到首次登录的关键步骤与易错点。
本文介绍了如何在本地部署企业级 AI 应用开发平台 Dify。Dify 以无代码可视化方式支持聊天机器人、智能体和工作流编排,相比在线版本,本地部署可规避网速瓶颈和数据安全风险。部署的核心依赖是 Docker 与 Docker Compose,硬件要求为 CPU≥2核、内存≥4GB,Linux/macOS 用户需手动安装这两个组件,Windows 用户则可直接使用 Docker Desktop。启动时有三个关键操作:进入源码的 `docker` 子目录、将 `.env.example` 重命名为 `.env`、执行 `docker compose up -d`。容器启动后通过 `localhost` 访问界面并完成管理员账号初始化,后续还需接入本地大模型(如 DeepSeek)才能真正投入使用。整套流程门槛不高,掌握易错点后可快速搭建完整的本地化 AI 开发底座。
为什么选择 Dify 做企业级 AI 应用
Dify 是当前搭建 AI 应用与智能体的高频工具之一,尤其在企业级场景和智能体开发中被广泛采用。它最大的价值在于无需编码:开发者可以在不写代码的前提下,快速构建聊天机器人、智能体(Agent),并通过可视化的工作流编排能力把业务逻辑串联起来。
对企业团队来说,这意味着能够以更低的门槛把大模型能力落地到实际业务中,而不必从零搭建复杂的应用框架。与 Coze 类似,Dify 在 AI 应用开发领域扮演着重要角色,两者都是值得掌握的产品。本文聚焦 Dify 的安装与本地部署流程,帮助你打通从环境准备到大模型接入的完整链路。
Dify 的核心架构由工作流引擎、RAG(检索增强生成)管道、Agent 框架和模型接入层四部分组成。其中工作流编排采用有向无环图(DAG)结构,允许用户以节点连线的方式定义数据在各步骤之间的流转逻辑,类似于 n8n 或 Zapier,但专为大模型任务设计。RAG 管道则支持将企业内部文档(PDF、Word、数据库等)向量化后存入知识库,让模型在对话时能检索私有数据,而非依赖训练集中的通用知识。这一能力是企业级场景的核心诉求之一——既能利用大模型的语言理解能力,又能保证答案基于企业自身的业务数据,而非凭空生成。
在线体验 vs 本地部署:如何取舍
Dify 官方提供了在线使用入口,访问官网 dify.ai 后点击 Get Started 即可打开在线工作界面。这种方式上手最快,但存在两个明显限制:
- 网速受限:在线访问的加载速度会受到较大影响;
- 模型调用在线化:所有模型推理都走在线通道,会拖慢实际开发效率。
正因如此,对于需要频繁调试、追求开发效率或有数据安全要求的团队来说,本地部署是更务实的选择。Dify 官方在 GitHub 上提供了完整的源码与 Docker 镜像,可以直接拉取到本地完成部署。
环境准备:Docker 与 Docker Compose
本地部署 Dify 的核心依赖是 Docker 环境。官方文档中列出了基本的硬件要求:CPU 大于 2 核,内存大于 4GB。启动命令本身很简单,就是一条 docker compose up -d,但前提是你的机器上必须具备 Docker 与 Docker Compose 环境。
Linux 环境安装
无论使用 Ubuntu 还是 CentOS,安装流程是一致的:
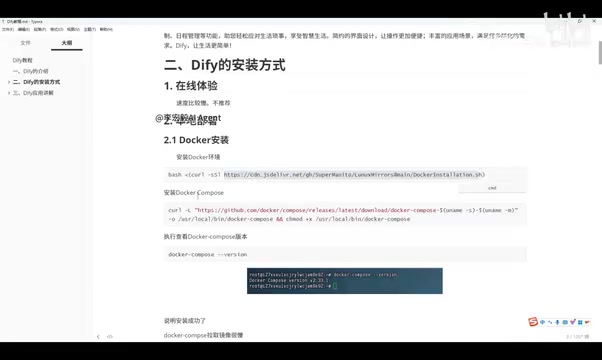
- 安装 Docker:可以直接执行官方提供的安装脚本,该脚本会把 Docker 安装及相关镜像一并处理好。如果因网速原因拉取失败,可以先把脚本下载到本地再执行。
- 安装 Docker Compose:执行对应安装命令后,运行
docker compose version,若能正常显示版本号,说明安装成功。 - 配置镜像代理:如果 Docker Compose 后续拉取镜像较慢,可以配置镜像代理来加速。
macOS 与 Windows 环境
Mac 电脑同样可以按照上述步骤安装。如果你已经安装过 Docker Compose,则无需重复处理。
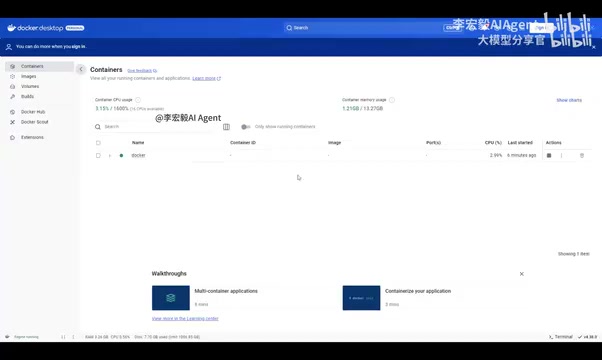
Windows 用户则更简单——直接使用 Docker Desktop(桌面版)。进入 Docker 官方站点下载 exe 安装文件,双击安装即可。安装完成后打开界面,其中自带终端,可以直接在里面执行命令;当然也可以在系统命令行中操作。
Docker 是一种容器化技术,它将应用程序及其所有依赖项(运行时、库、配置文件)打包进一个标准化的「容器」中,使其可以在任何支持 Docker 的机器上一致运行,彻底解决「在我机器上能跑,换台机器就报错」的问题。Docker Compose 则是在此基础上的多容器编排工具——Dify 本身由多个服务组成(Web 前端、API 服务、Worker 进程、PostgreSQL 数据库、Redis 缓存、向量数据库等),Compose 通过一个 docker-compose.yaml 配置文件统一定义这些服务的启动顺序、网络互联和数据卷挂载,让原本需要逐一手动启动的多个进程变成一条命令即可完成。这也是为什么必须在 docker 目录下执行命令——该目录中的 docker-compose.yaml 正是整个 Dify 服务拓扑的「说明书」。
启动 Dify 容器
环境就绪后,启动 Dify 的步骤非常清晰,但有几个关键细节需要注意:
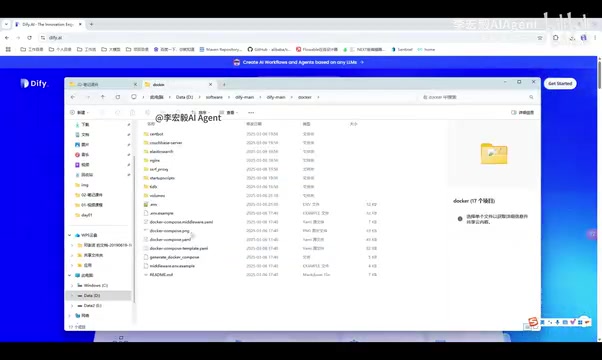
- 进入正确目录:
docker compose up命令必须在 Dify 源码的docker目录下执行,因为该目录中包含了 Docker Compose 的配置文件。 - 重命名配置文件:目录中有一个
.env.example文件,需要手动把它重命名为.env,否则容器无法正确读取配置。这是新手最容易踩的坑之一。 - 执行启动命令:在
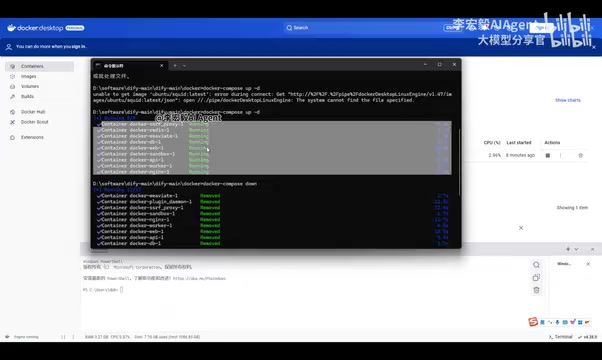
docker目录下执行docker compose up,容器就会开始运行相关组件。
第一次执行时,由于需要拉取镜像,速度可能偏慢,需要耐心等待。若采用后台模式(-d),则看不到后台执行日志,容器会在后台默默完成组件启动。
首次访问与初始化配置
容器启动成功后,由于默认端口为 80,直接在浏览器中访问 localhost 即可打开 Dify 界面。
首次进入会看到设置管理员账号的页面,需要自行填写管理员邮箱、用户名和密码。设置完成后点击确认,系统会跳转到登录界面,使用刚才设置的账号密码登录即可进入 Dify 工作台。进入后可以切换语言为中文,方便后续操作。
下一步:接入本地大模型
完成 Dify 本地部署只是第一步。要真正用它创建应用,还需要关联对应的推理模型或对话模型来驱动实际工作。既然已经把 Dify 部署到了本地,与之配套的思路自然是把相关大模型也在本地部署,从而实现完整的本地化 AI 应用开发环境。
这一部分(如 DeepSeek 等模型的本地接入)将是后续实战的重点,也是 Dify 从"能跑起来"到"能干活"的关键衔接。
本地部署大模型通常借助 Ollama 或 LM Studio 等推理框架实现。以 Ollama 为例,它会在本地起一个兼容 OpenAI API 格式的 HTTP 服务(默认端口 11434),Dify 只需在「模型供应商」设置中填入该地址,即可像调用 GPT 一样调用本地运行的 DeepSeek、Llama、Qwen 等开源模型。这种架构的好处是双重的:一方面所有数据均在本地流转,满足数据不出域的安全要求;另一方面推理延迟仅受本机硬件限制,不依赖外部网络,调试体验远优于在线 API。选择本地模型时需根据显存或内存容量匹配合适的参数量,通常 8B 参数的模型在 16GB 内存的机器上即可流畅运行。
小结
Dify 的本地部署门槛并不高,核心就是三步:准备 Docker 环境、拉取源码、进入 docker 目录执行启动命令。真正需要留意的是几个易错点——硬件配置要求、.env 配置文件的重命名、以及镜像拉取慢时的代理配置。掌握这套流程后,你就拥有了一个可控、高效的企业级 AI 应用开发底座。
相关推荐
厦门大学AI编程课落地实践:从教材到教学的全解析
厦门大学林子雨副教授分享《AI编程与智能体开发》课程建设实践,涵盖AI编程三段演进、Claude Code生产级拐点、三种编程方法论及教材设计,详解免费可复现的高校教学落地方案。
DeepSeek研究员自白:亲手训练的AI即将取代自己
DeepSeek V4.1核心算子编写者刘胜宇发文自白:亲手训练的AI最快半年到一年将取代自己写算子的能力。他为何仍坚持优化模型?又为何担忧AI把世界推向赛博朋克式极端并选择开源?
n8n 自动化实战:AI 工作流如何为中小企业降本增效
本文基于一线从业者的实战分享,讲解如何用 n8n 与 AI 工具构建工作流自动化,涵盖多平台消息聚合、AI 自动回复、批量数据录入与智能校验,帮助中小企业降本增效。