Dify企业级实战:90+项目掌握AI工作流搭建

梳理Dify低代码AI平台的核心架构、四大课程模块与企业落地路径。
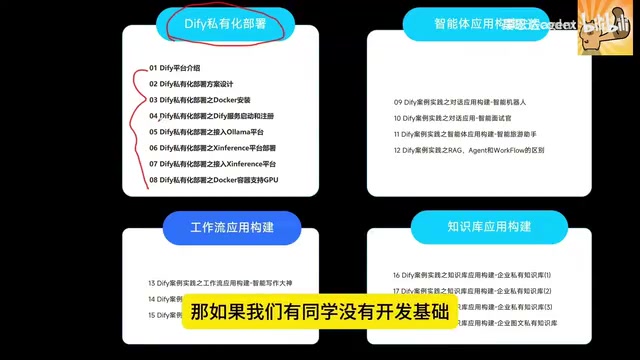
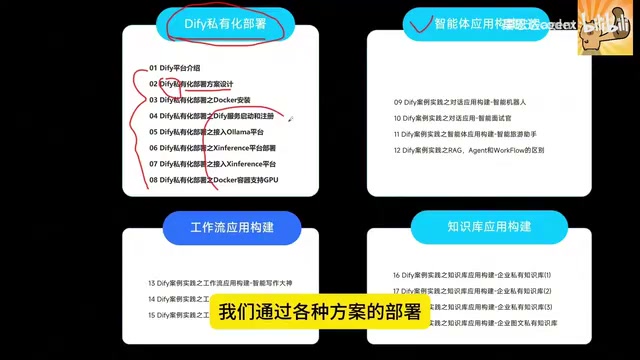
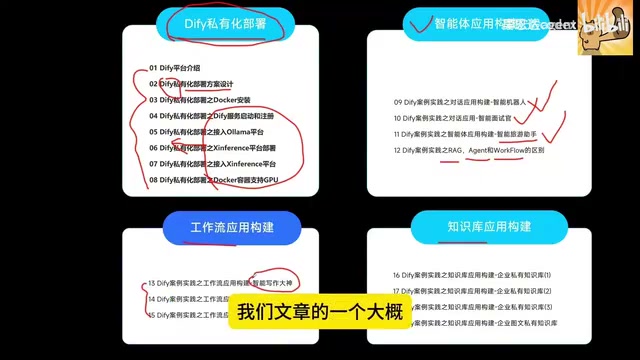
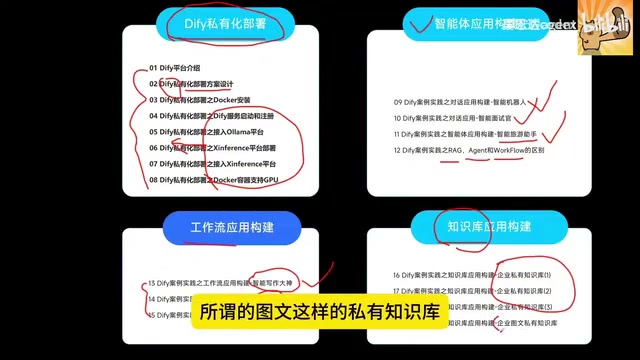
文章基于B站《Dify智能应用开发实战》课程,介绍Dify这一低代码/零代码企业级大模型应用开发平台。Dify支持智能体、RAG和工作流三种应用架构,受众覆盖无开发基础的业务人员与有技术能力的企业团队。课程分为四大模块:Dify及语言、嵌入、向量、多模态模型的完全私有化部署;智能机器人、智能面试官、智能旅游助手三个智能体项目;智能写作与打通企业微信、飞书的企业智能客服两个工作流项目;以及纯文本与图文混合两类私有知识库问答。文章指出私有化部署模块难度较高、价值在于数据不出域,并提醒“七天掌握”属营销话术,建议学习者按自身需求选择模块。
Dify作为低代码甚至零代码的大模型应用开发平台,正在成为企业快速落地AI能力的关键工具。B站上有一套名为《Dify智能应用开发实战》的课程,宣称通过90+个企业级实战项目,帮助学习者在七天内掌握AI工作流搭建。本文基于该课程内容,梳理Dify的核心能力、项目案例与学习路径,为想要系统入门Dify的开发者提供一份参考。
Dify是什么:低门槛的企业级AI应用平台
据课程介绍,Dify是一个让用户通过低代码或零代码方式快速生成企业级大模型应用的平台。它支持三种主要应用类型:智能体架构、RAG(检索增强生成)架构以及工作流架构。用户可以根据智能体的功能构建各类智能体,基于RAG架构落地私有知识库应用,或通过工作流实现更复杂的智能应用。课程主讲人将其评价为“门槛最低、最受欢迎、效果最好的大模型开发平台之一”。
这种定位决定了Dify的受众范围:既包括没有开发基础的业务人员,也包括需要为企业构建数据安全方案的技术团队。
RAG(检索增强生成) 是一种将外部知识检索与LLM生成相结合的技术范式。其基本流程是:先把私有文档切分、向量化并存入向量数据库;用户提问时,系统先检索出与问题最相关的若干文本片段,再把这些片段作为上下文拼入提示词,交给大模型生成答案。相比直接微调模型,RAG的优势在于知识可随时更新、答案可溯源、成本更低,因此成为企业落地私有知识库问答的主流方案。Dify将RAG的关键环节(文档解析、分段、嵌入、检索、重排)封装为可视化配置,用户无需编写检索代码即可搭建知识库应用。
Agent(智能体)架构 与RAG的区别在于,Agent让大模型具备自主决策能力:模型根据目标自行判断是否需要调用工具(搜索、计算、API、数据库等)、调用哪个工具、以及多轮调用后如何整合结果。Dify中的Agent可配置工具列表与推理策略,适合任务路径不固定、需要动态规划的场景;而工作流架构则是把步骤预先编排成确定的流程图,可控性和可调试性更强。三者并非互斥,实际项目中常在工流节点内嵌入RAG检索或Agent调用。
课程四大模块:从私有化部署到应用落地
课程内容被划分为四个大模块,覆盖从底层部署到上层应用的完整链路。
模块一:Dify私有化部署
第一个模块聚焦Dify平台的完全私有化部署,包括平台本身以及各类模型的私有化部署与管理。课程提到需要部署的模型类型涉及语言模型、嵌入模型、向量模型和多模态模型,最终统一接入Dify平台。这一模块有一定难度,适合有开发基础的同学;没有开发基础的学习者可以跳过,直接基于公有云平台继续后续学习。
对于企业而言,私有化部署的核心价值在于数据安全。课程强调,企业构建的应用需要确保数据不出域,因此完全私有化是重要选项。
私有化部署中提到的几类模型各有分工:语言模型(LLM) 负责理解与生成文本,是应用的主推理引擎;嵌入模型(Embedding Model) 把文本转换为高维向量,是知识库检索的基础;向量模型/向量数据库 负责存储这些向量并支持相似度检索(如Milvus、Qdrant、Weaviate等),严格来说它不是“模型”而是检索基础设施,课程表述中常与嵌入模型合并提及;多模态模型 则能同时处理文本与图像,支持图文混合问答和图片理解。
私有化部署的典型方式是使用Docker Compose编排Dify的各个服务组件,模型侧则通过Ollama、vLLM、Xinference等推理框架本地加载开源模型,再在Dify的“模型供应商”设置中以OpenAI兼容接口接入。这一链路涉及GPU显存规划、模型量化、内网端口与鉴权配置,因此课程将其标注为有难度、适合有开发基础者。对数据合规要求高的企业,还需考虑日志与对话记录的本地留存。
模块二:智能体应用开发
在平台就绪后,课程进入应用构建阶段。智能体部分包含三个项目:智能机器人、智能面试官和智能旅游助手。课程还详细对比了RAG架构、Agent架构与工作流架构之间的区别与相似点,帮助学习者理解不同架构的适用场景。
模块三:工作流应用开发
工作流模块打造了两个应用:智能写作大神和智能客服。智能写作工具只需输入标题和一级大纲,即可生成结构完整、语言优美的长文本,适用于写文章、写书甚至写论文。智能客服则打通了企业微信、飞书等平台,能够显著降低客服成本。
智能客服“打通企业微信、飞书”依赖的是平台的渠道集成与API回调机制。典型做法是:在企业微信或飞书开放平台创建自建应用,获取CorpID、AgentID、Secret等凭证,配置接收消息的回调地址;Dify侧则通过其API或Webhook把工作流的推理能力暴露为服务端点,两者完成鉴权与消息格式转换后即可实现双向收发。这一环节的工程难点通常不在模型本身,而在于消息加解密、事件订阅验证、以及会话上下文与企业用户身份的映射。
工作流中的长文写作能力则依赖节点编排:通常由大纲生成、分章节扩写、风格润色、合并校验等多个LLM节点串联,配合变量在节点间传递中间结果,并通过条件分支或循环节点控制篇幅。相比单次提示词生成,这种拆分式编排能显著缓解长文本生成中的结构漂移与前后不一致问题,也便于对单章节单独调试和替换模型。
模块四:私有知识库应用
最后一个模块聚焦私有知识库的构建,包含两个需求场景:纯文本知识库问答,以及图文混合的知识库问答。后者允许模型在回答中同时输出文字和图片,更贴近企业实际文档的形态。
课程特点与适用人群
从课程描述来看,这套内容强调“全程干货无废话”,以项目驱动的方式覆盖Dify的主要功能。90+个实战项目的说法在原始素材中并未逐一列出,实际课程可能包含更多细分案例。对于希望系统学习Dify的开发者,可以将其作为一条结构化的学习路径参考;对于企业技术团队,私有化部署模块和知识库模块的实践价值相对更高。
需要提醒的是,课程宣传中的“七天轻松搞定”属于营销话术,实际掌握程度仍取决于学习者的基础投入。建议先明确自身需求——是快速搭建原型,还是为企业构建合规的私有化AI平台——再选择对应模块深入学习。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。