Dify是什么?开源AI应用平台核心功能与入门指南

什么是Dify?面向企业的开源AI应用开发平台
Dify是当前备受关注的开源AI应用开发平台,核心定位非常明确——让个人和企业都能快速搭建AI应用。无论是提升个人工作效率,还是解决企业业务中的实际痛点,Dify都能胜任。
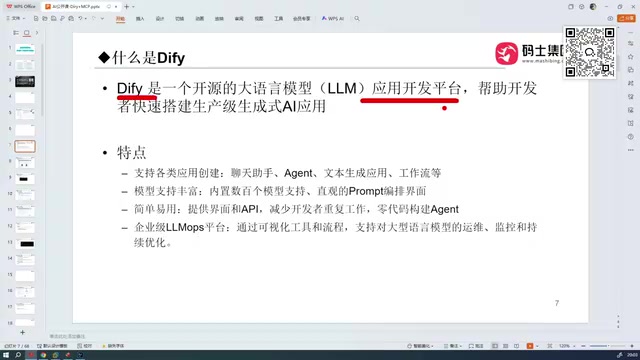
简单来说,Dify就是一个让你无需从零编写代码,就能基于大语言模型(LLM)创建各类AI应用的平台。大语言模型(Large Language Model, LLM)是基于Transformer架构、通过海量文本数据训练而成的深度学习模型,具备文本生成、理解、推理、翻译等多种自然语言处理能力。
Transformer架构由Google在2017年的论文《Attention Is All You Need》中提出,其核心创新是自注意力机制(Self-Attention),能够并行处理序列中所有位置的关系,解决了此前RNN/LSTM模型在长序列处理中的效率瓶颈。从GPT-1到GPT-4,模型参数从1.17亿增长到据传超过万亿级别,训练数据也从书籍语料扩展到互联网全域文本。这种规模效应带来了涌现能力(Emergent Abilities),即模型在达到一定规模后突然展现出小模型不具备的推理、编程等能力。
代表性模型包括OpenAI的GPT系列、Meta的LLaMA系列、Google的Gemini以及国内的通义千问广告、文心一言等。Dify作为应用开发平台,本身不训练模型,而是通过API接口对接各种LLM,让开发者可以灵活选择底层模型,专注于应用层的逻辑设计。正因如此,Dify大幅降低了AI应用开发的门槛,让非技术背景的人也能参与到AI应用的构建中来。
Dify的核心优势:开源特性与企业级能力
完全开源带来的灵活性
Dify最突出的特点之一是完全开源。源代码公开意味着:
- 企业可以自行私有化部署,数据完全掌控在自己手中
- 开发者可以根据业务需求进行二次开发和深度定制
- 社区驱动的迭代速度快,功能更新频繁
- 无需担心供应商锁定问题
对于注重数据安全和系统可控性的企业来说,开源方案往往是首选。在企业级AI应用场景中,私有化部署意味着所有数据(包括用户输入、模型推理结果、知识库内容等)都在企业自有的服务器或私有云环境中流转,不经过第三方平台。这对于金融、医疗、政务等对数据合规性要求极高的行业至关重要。
同时,Dify采用Apache 2.0开源许可证,允许企业在遵守协议的前提下自由修改和分发代码,避免了对单一商业供应商的技术依赖——这在行业中被称为"供应商锁定"(Vendor Lock-in)风险。Apache 2.0是最为宽松的开源许可证之一,它允许企业自由使用、修改、分发代码,甚至可以在修改后的代码基础上构建闭源商业产品,唯一的核心要求是保留原始版权声明。相比之下,GPL许可证要求衍生作品也必须开源,AGPL更是将网络服务也纳入约束范围。Dify选择Apache 2.0意味着企业可以放心地基于Dify进行商业化开发,无需担心法律合规风险。Dify正是抓住了这一核心需求,在企业级AI应用市场中占据了重要位置。
Dify与Coze的区别:如何选择?
很多初学者会将Dify与字节跳动的Coze进行比较。两者虽然都是AI应用搭建平台,但定位有明显差异:
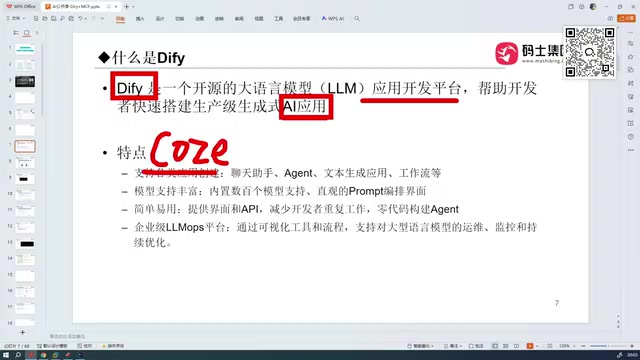
| 对比维度 | Dify | Coze |
|---|---|---|
| 目标用户 | 企业、大团队 | 个体、小团队 |
| 部署方式 | 支持私有化部署 | 主要为SaaS服务 |
| 开源程度 | 完全开源 | 非开源 |
| 定制能力 | 高度可定制 | 相对受限 |
这里需要理解两种部署模式的本质区别:SaaS(Software as a Service,软件即服务)是一种云端交付模式,用户通过浏览器直接使用服务商托管的软件,无需自行维护服务器和基础设施,优势在于开箱即用、运维成本低。而私有化部署则是将软件安装在企业自有的服务器环境中,企业拥有完整的数据主权和系统控制权,但需要承担部署、运维和升级的成本。在AI应用领域,由于涉及大量敏感业务数据和用户隐私信息,许多企业(尤其是受监管行业)倾向于选择私有化部署方案。
对于大中型企业而言,选择Dify的比例明显更高,这主要得益于其私有化部署能力和企业级的安全合规保障。而个人开发者或小团队如果追求快速上手、开箱即用,Coze也是不错的选择。
Dify的典型应用场景
个人效率提升场景
对于个人用户,Dify可以帮助你搭建:
- 个人知识库问答系统:基于RAG技术构建专属知识助手。RAG(Retrieval-Augmented Generation,检索增强生成)是当前构建知识库问答系统的主流技术范式。其核心思路是:在大语言模型生成回答之前,先从外部知识库中检索与用户问题最相关的文档片段,然后将这些片段作为上下文信息一并输入模型,从而让模型基于特定领域知识给出更准确、更有依据的回答。RAG的典型流程包括:文档切片(Chunking)→ 向量化嵌入(Embedding)→ 存入向量数据库 → 用户提问时进行语义检索 → 将检索结果与问题拼接后送入LLM生成答案。这种方式有效缓解了LLM的"幻觉"问题(即模型编造不存在的信息),同时避免了为每个特定场景重新微调模型的高昂成本。
在RAG系统中,向量数据库(如Weaviate、Milvus、Qdrant、Pinecone等)是不可或缺的基础设施。传统数据库基于精确匹配进行检索,而向量数据库则基于语义相似度进行近似最近邻(ANN)搜索。文本通过Embedding模型(如OpenAI的text-embedding-ada-002)被转化为高维向量(通常为768或1536维),语义相近的文本在向量空间中距离更近。Dify内置支持多种向量数据库,用户可根据数据规模和性能需求灵活选择。
- 自动化文档处理工具:批量处理、摘要、翻译等
- 智能写作助手:辅助内容创作和文案优化
- 数据分析辅助工具:快速从数据中提取洞察
企业业务赋能场景
在企业场景中,Dify的应用范围更加广泛:
- 客服智能问答系统:7×24小时自动响应客户咨询
- 内部知识管理平台:沉淀企业知识资产,提升信息检索效率
- 业务流程自动化:通过工作流编排实现复杂业务逻辑
- 智能报告生成:自动化生成分析报告和业务简报
- 多轮对话应用:构建具备上下文理解能力的交互式应用
Dify学习路径:从入门到企业级实战
系统学习的五个阶段
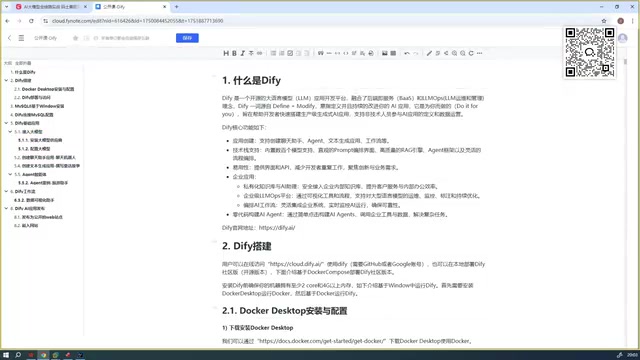
对于想要系统掌握Dify的开发者,建议按照以下路径循序渐进:
- 基础概念理解:了解Dify的架构设计和核心组件,包括工作流(Workflow)、Agent、知识库(Knowledge Base)等。工作流(Workflow)是Dify中用于编排复杂业务逻辑的核心功能,开发者可以通过可视化的拖拽界面将多个处理节点(如LLM调用、条件判断、代码执行、HTTP请求等)串联起来,形成一条完整的自动化处理链路。这种方式特别适合需要多步骤协作的业务场景,例如先检索知识库、再调用模型生成回答、最后格式化输出。
Agent(智能体)则是一种更高级的AI应用形态,它赋予LLM自主决策和工具调用的能力——Agent可以根据用户的意图自动选择合适的工具(如搜索引擎、计算器、数据库查询等)来完成任务,而不是按照预设的固定流程执行。Agent的理论基础源自ReAct(Reasoning + Acting)框架,即让模型在推理和行动之间交替迭代,直到完成目标。
2024年以来,AI Agent成为行业最热门的技术方向之一。从AutoGPT引发关注,到OpenAI推出Function Calling机制,再到各大厂商纷纷发布Agent框架(如LangChain的LangGraph、Microsoft的AutoGen),Agent正从概念验证走向生产落地。Agent的核心挑战包括:工具调用的准确性、多步推理的可靠性、长任务执行中的错误恢复等。Dify的Agent实现提供了可视化的工具配置和调试界面,降低了Agent应用的开发难度。
- 环境搭建与部署:学会在本地通过Docker部署Dify,熟悉其配置流程。Docker是一种容器化技术,它将应用程序及其所有依赖项(运行时环境、系统库、配置文件等)打包成一个标准化的"容器",确保应用在任何环境中都能一致运行。Dify推荐使用Docker Compose进行部署,这是Docker的多容器编排工具,可以通过一个YAML配置文件同时启动Dify所需的多个服务组件(如Web服务、API服务、数据库、Redis缓存、向量数据库等)。对于开发者而言,使用Docker部署Dify通常只需要几条命令即可完成,大幅简化了环境配置的复杂度。
Dify采用微服务架构设计,将Web前端、API后端、Worker异步任务处理、数据库(PostgreSQL)、缓存(Redis)、向量数据库等拆分为独立服务。这种架构使得各组件可以独立扩缩容,在高并发场景下尤为重要。与传统的虚拟机相比,Docker容器共享宿主机操作系统内核,启动时间从分钟级缩短到秒级,资源开销大幅降低。企业生产环境中通常还会结合Kubernetes进行容器编排,实现自动化的高可用部署。
- 基础应用创建:从简单的聊天机器人入手,逐步熟悉可视化界面操作
- 进阶功能探索:深入掌握工作流编排、RAG知识库检索、外部工具调用等高级功能
- 企业级项目实战:结合真实业务场景,完成从需求分析到上线部署的完整项目
DSL文件:快速复现应用的利器
在Dify中,DSL(Domain Specific Language)文件是应用的配置描述文件。DSL即领域特定语言,是为特定应用领域设计的专用语言,与通用编程语言(如Python、Java)不同,DSL只关注特定领域的表达需求。在Dify中,DSL文件采用YAML格式,完整描述了一个AI应用的所有配置信息,包括模型选择、提示词(Prompt)设计、工作流节点编排、变量定义、知识库关联等。
这种"应用即配置"的设计理念使得AI应用可以像代码一样进行版本管理、团队协作和跨环境迁移,极大提升了开发效率和可复现性。这一思路与基础设施即代码(Infrastructure as Code, IaC)的理念一脉相承——将原本需要手动操作的配置过程转化为可版本化、可审计的声明式文件。在团队协作中,DSL文件可以通过Git进行版本控制,团队成员可以清晰地追踪每次应用配置的变更历史,进行代码审查(Code Review),并在不同环境(开发、测试、生产)之间无缝迁移。
通过导入DSL文件,你可以快速复现他人创建的应用,这对于学习和团队协作都非常有价值。建议初学者多收集和研究优秀的DSL模板,从模仿开始逐步掌握应用设计的精髓。Dify社区和GitHub上有大量开源的DSL模板可供参考。
总结:为什么值得学习Dify
Dify作为一个开源的企业级AI应用开发平台,正在成为越来越多团队构建AI应用的首选工具。它的完全开源特性、企业级私有化部署能力以及丰富的功能组件(工作流、Agent、RAG知识库等),使其在AI应用开发领域具有独特的竞争优势。
从行业趋势来看,AI应用开发正在经历从"代码密集型"向"配置编排型"的范式转变。早期构建AI应用需要深厚的机器学习功底和工程能力,而Dify等低代码/无代码平台的出现,正在将AI应用开发的门槛从"会写代码"降低到"会设计流程"。这意味着产品经理、业务分析师等非技术角色也能直接参与AI应用的原型设计和迭代,大幅缩短了从需求到产品的交付周期。
无论你是想提升个人工作效率,还是为企业构建智能化解决方案,Dify都值得深入学习和实践。从搭建第一个聊天机器人开始,逐步探索这个强大平台的全部潜力吧。
核心要点
核心要点
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。