Dify智能客服实战:多轮对话与转人工怎么搭

B站UP主用Dify从零搭建智能客服原型,重点拆解多轮对话与转人工的实现思路。
文章基于B站UP主的直播课程,系统梳理了用Dify搭建智能客服原型的完整路径。选型上对比Coze与Dify,指出Dify支持私有化部署、数据可完全留在本地,更适合金融医疗等合规场景。部署部分给出三种方式并推荐Windows下WSL加Docker Desktop的本机方案,认为比虚拟机轻量、比官方云服务更可控。功能实现上,多轮对话依赖提示词规则、知识库挂载和变量承接,转人工则通过条件分支与外部工具调用,在意图识别为复杂问题或多轮未命中时触发。文章最后提醒Dify是理解概念的跳板,深入开发仍需掌握LangChain等代码框架。
智能客服如果只会答一句就卡壳,用户体验会断崖式下跌。多轮对话和转人工是两道绕不过去的坎。B站UP主在直播课里用Dify从零搭建了这样一个客服原型,重点拆解了这两个环节的实现思路。本文基于该课程内容,结合Dify的公开特性做一次系统梳理。
为什么选Dify而不是Coze
市面上做AI应用搭建的工具不止一个。UP主对比了Coze和Dify两条路线,结论很明确:Coze以云端托管为主,数据存放在平台侧;Dify支持私有化部署,数据可以百分之百留在本地。
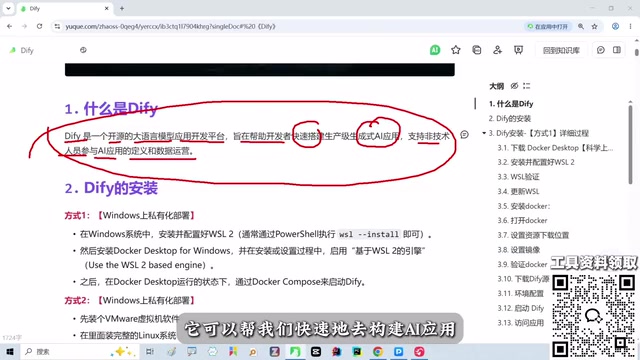
[据UP主在课程中的说法]“如果你做一些金融医疗等行业的那些合规的公司的话,这个需求我们去用它都没什么问题。”这不是说Coze不好用,而是数据主权在企业场景里是硬约束。Dify的定位是一个开源的大模型应用开发平台,官方描述是帮助开发者快速搭建生产级AI应用,同时支持非技术人员参与应用定义和数据运营。
对零基础学习者来说,Dify的拖拽式界面降低了理解智能体和知识库概念的门槛。UP主建议先通过这种直观方式建立感性认识,再去碰LangChain、LangGraph这些代码框架。
三步完成本地部署
课程花了相当篇幅讲安装,因为这是后续所有操作的前提。UP主给出了三种方式并做了明确取舍。
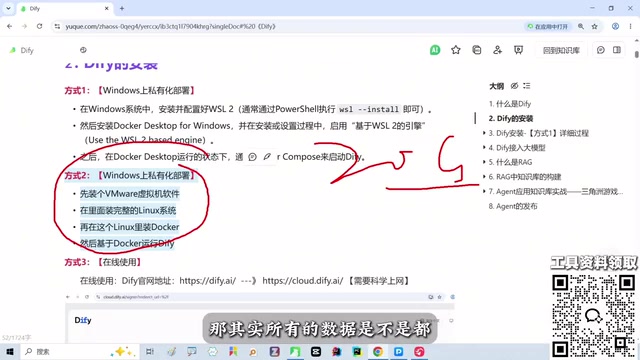
方式一:本机私有化部署(推荐)
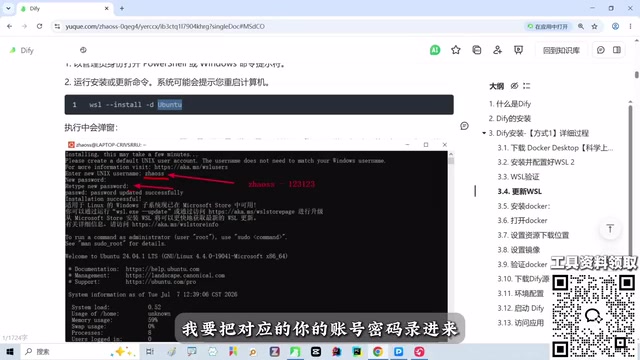
在Windows机器上装WSL和Docker Desktop,然后跑Dify。UP主认为这是最轻量的路径:“你把几个软件安一安就可以了。”安装过程在配套笔记里有逐步截图,核心步骤是先启用WSL相关系统功能,用wsl --version验证版本,版本无效就执行更新命令,再安装Docker Desktop并完成重启。
WSL 全称 Windows Subsystem for Linux,是微软在 Windows 10/11 中内置的兼容层,让用户不必装双系统或虚拟机就能直接运行 Ubuntu 等 Linux 发行版。Dify 的官方镜像和大量依赖脚本都以 Linux 为默认环境,因此 Windows 用户通常先启用 WSL,再在其中安装 Docker。启用方式是在“启用或关闭 Windows 功能”中勾选“适用于 Linux 的 Windows 子系统”和“虚拟机平台”,重启后用 wsl --version 检查版本;若提示版本无效,执行 wsl --update 升级到 WSL2。WSL2 使用轻量级虚拟机内核,与 Docker Desktop 的集成最顺畅,也是 Dify 本地部署最常见的底座。
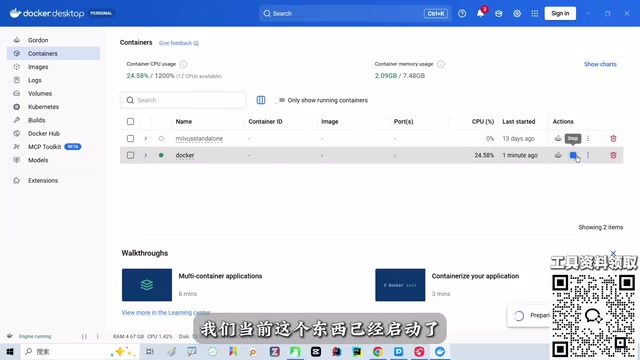
Docker Desktop 是 Docker 官方提供的桌面端容器管理工具,把镜像拉取、容器编排、端口映射等操作封装成图形界面。Dify 的部署包由多个容器组成(Web 前端、API 后端、PostgreSQL、Redis、向量数据库等),通过一份 docker-compose.yaml 统一拉起。安装 Docker Desktop 后需在设置中勾选“Use WSL 2 based engine”,并确保与已启用的 WSL 发行版完成集成;左下角显示 running 即代表 Docker 引擎就绪,此时在 Dify 目录执行 docker compose up -d 即可启动整套服务,浏览器访问映射端口进入初始化页面。
方式二:虚拟机部署
把所有东西跑在虚拟机里,数据存在虚拟机硬盘上。好处是数据掌控权完全在自己手里,代价是“至少20G的空间就没了”。UP主个人不太推荐这种方式,认为太重。
方式三:官方云服务
最省事,但数据会存放在美国东部地区的服务器上。UP主的态度很直接:“几乎所有人都会比较崇尚这种自由化部署。”
部署完成后,Docker左下角显示“running”状态,Dify即可启动。UP主特别提醒初学者不要在WSL是什么、Docker是什么这些细节上纠缠:“你一定要明白这个东西在学习上一定不要有强迫症”,主线是把应用跑通,细节课后再补。
多轮对话的搭建逻辑
课程中Dify的工作室、知识库、集成等模块全部从空白状态开始配置,UP主带着学员一步步搭建。多轮对话的核心在于让智能体记住上下文并基于知识库做出连贯回应。
从Dify的产品设计来看,聊天助手类型应用天然支持多轮交互,你需要在提示词里定义对话规则,挂载知识库作为事实来源,再设置变量来承接用户在多轮中提供的信息。UP主在课程里强调的一点是,这些配置都要围绕实际业务需求来定,而不是把所有能力都堆上去。
提示词中的对话规则决定了多轮对话的质量上限。在 Dify 聊天助手应用中,系统提示词不只是角色设定,还可以写入追问策略、信息收集顺序和终止条件,例如“用户未提供订单号时先索要订单号,不要直接回答退款进度”。由于每轮请求都会携带历史消息,提示词中的规则会在整个会话中持续生效,因此要写明“什么情况下必须澄清、什么情况下可以给出结论”,避免模型在信息不全时编造答案。
变量(Variables) 是承接多轮信息的结构化容器。相比让模型从长对话历史里自行提取,把订单号、手机号、产品型号等关键槽位定义为会话变量,可以让后续节点直接引用,减少上下文过长导致的遗忘和串扰。在 Dify 中变量可在对话开场白或节点中赋值,并在条件分支、知识库检索 query 拼装、工具调用参数中复用,这也是把“闲聊式多轮”变成“任务式多轮”的关键手段。
转人工的触发设计
转人工是客服场景的兜底能力。Dify本身不直接提供呼叫中心功能,但可以通过条件分支和外部工具调用来实现:当意图识别为投诉、退款、复杂售后,或者连续多轮未能命中知识库时,触发转接动作,把会话上下文传递给人工坐席系统。
课程里UP主把这一环节放在知识库配置之后讲解,逻辑是先让机器能答的答好,答不了的再交给人。这个顺序值得借鉴——转人工不是失败,而是服务连续性的保障。
条件分支(IF/ELSE 节点) 是 Dify 工作流中实现路由判断的基础节点,可基于变量值、模型分类结果或检索命中情况决定后续走向。转人工的典型做法是在意图分类节点之后接一个条件分支:分类结果为“投诉/退款/复杂售后”时走人工通道,否则进入知识库问答。对于“连续多轮未命中”,可以借助会话变量累计未命中次数,每轮检索得分低于阈值时计数加一,达到设定值即触发转接,这样比单轮判断更贴近真实客服的兜底逻辑。
外部工具调用 用于把转接动作落到真实系统。Dify 支持通过自定义工具或 API 扩展接入外部 HTTP 接口,把会话 ID、用户标识、历史对话摘要等字段推送给工单系统或在线客服平台(如环信、智齿、企业自建坐席系统),由对方完成排队和分配。需要注意的是,Dify 只负责“判断该转”和“把上下文传出去”,坐席端的排队、路由、会话接管仍需呼叫中心或客服系统承担,二者是编排层与执行层的关系。
对学习者的建议
UP主反复提到配套笔记的价值:安装步骤、镜像命令、环境变量配置都有截图记录。对零基础学员来说,照着跑一遍是成本最低的入门方式。课程也点明了一个现实:真正做大模型开发最终要落到代码框架上,Dify是理解概念和快速验证的跳板,不是终点。
如果你正在做智能客服的早期原型,Dify的私有化部署加可视化编排,值得花一个下午跑通。
相关推荐

Zed编辑器发布v1.29.2:一次常规版本迭代的观察
Zed编辑器发布v1.29.2补丁版本,由@JosephTLyons完成版本升级,提交经GitHub签名验证。本文梳理该版本的基本信息、补丁版本的含义以及对用户升级的实际建议。

Anthropic IPO遭质疑:Hacker News热议其上市时机
Hacker News出现「Just say no to Anthropic's IPO」帖子,引发对Anthropic上市时机与AI公司资本化的讨论,涉及估值泡沫与使命独立性等议题。

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。