Doc-foundry:AI自动编写并验证安全检测规则

Doc-foundry 主张用 AI 生成安全检测规则并自证有效性,切中规则可信度痛点,但验证细节尚缺。
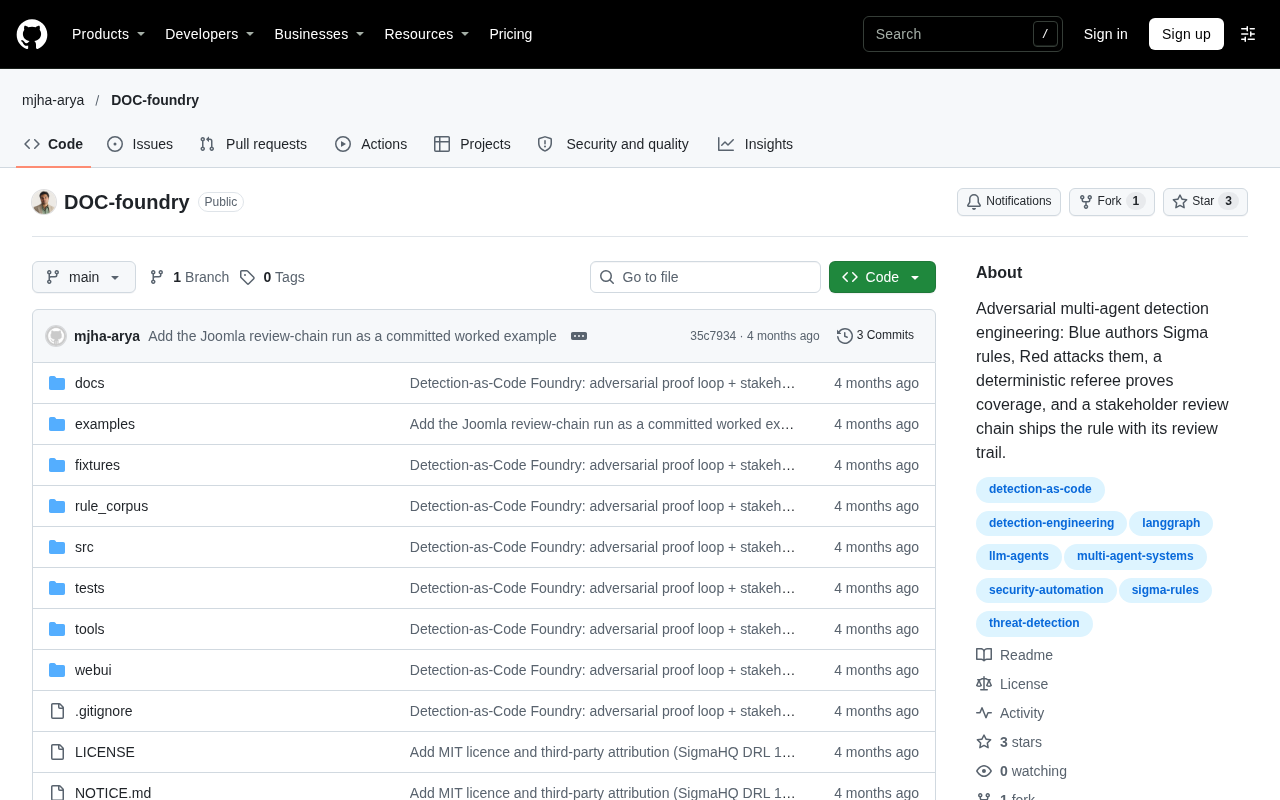
Doc-foundry 是一个在 Hacker News 上被介绍的项目,其核心主张是让 AI 不仅自动生成安全检测规则,还要在交付前证明规则确实有效。文章指出,传统规则开发依赖专家手写并在测试环境验证,循环慢且难规模化;AI 生成可提速,但缺少验证的规则可能只是“看起来合理”。在安全场景下,大模型幻觉风险被放大,错误规则会导致漏报或误报疲劳。因此,“生成+自证”的组合相当于给生成式系统加工程约束。行业正从堆规则转向管规则质量,这类工具对缺少专职检测人员的中小团队价值明显。不过项目披露信息有限,验证方法、覆盖场景、误报率度量等关键细节缺失,HN 社区也无实质反馈,评估时应关注验证机制是否透明、能否在自有日志环境复现。
安全运营团队长期面临一个尴尬的现实:检测规则的编写高度依赖专家经验,而规则写完之后的验证环节往往更耗时——一条规则是否真的能捕获目标攻击行为、会不会产生大量误报,通常需要反复调试和真实流量检验。Doc-foundry 试图用 AI 把这两个环节打通:不仅自动生成安全检测规则,还要证明这些规则确实有效。
从"写得出来"到"证明有效"
据 Hacker News 上的项目介绍,Doc-foundry 的核心主张是让 AI 承担检测规则的编写工作,并在交付前完成有效性验证。这个定位切中了检测工程中的关键痛点:规则的数量从来不是稀缺资源,可信的规则才是。
传统的规则开发流程通常是:安全分析师根据威胁情报或攻防经验手写规则,再在测试环境中跑一遍日志验证。这个循环慢、依赖个人水平,而且难以规模化。让 AI 介入生成环节可以显著提速,但如果缺少验证,产出的规则很可能只是"看起来合理"——语法正确、逻辑自洽,实际却抓不到攻击,或者噪音大到无法使用。Doc-foundry 把验证作为产品主张的一部分,意味着它试图解决的是规则可信度问题,而不只是生成效率问题。
检测规则与误报率
安全检测规则(如 Sigma、YARA、Snort 规则)本质上是将攻击行为特征形式化为可匹配的条件表达式。一条规则的质量通常由两个维度衡量:召回率(能否捕获目标攻击)与精确率(是否产生大量误报)。误报率过高会导致“告警疲劳”——分析师被大量噪音淹没,进而忽略真实威胁,这是 SOC 团队最常见的运营痛点之一。因此,规则验证不仅要测试其能否命中恶意样本,还需在正常业务流量上评估其误报水平,两者缺一不可。
这个方向为什么值得关注
检测规则的自动生成并不是新想法,但"生成 + 自证"的组合在当前阶段有特殊意义。大模型生成的内容存在幻觉风险,在安全场景下这种风险被放大:一条错误的检测规则可能导致漏报真实攻击,也可能淹没分析师的时间。要求 AI 对自己的产出给出可验证的有效性证据,本质上是给生成式系统加了一道工程约束。
从行业趋势看,安全运营正在从"堆规则"转向"管规则质量"。规则库膨胀带来的维护成本、误报疲劳,已经是 SOC 团队的普遍困扰。一个能自动生成并筛选出高可信规则的工具体系,如果验证环节足够扎实,对中小型安全团队的价值会相当明显——这些团队往往缺少专职的检测工程人员。
大模型幻觉在安全场景的放大效应
大语言模型生成内容时可能出现“幻觉”,即输出语法通顺、逻辑自洽但与事实不符的信息。在安全检测规则场景下,这种风险尤为致命:一条看似合理但实际无效的规则,会让团队误以为某类攻击已被覆盖,从而放松其他防护手段,造成漏报;或者规则条件过于宽泛,在生产环境中触发海量误报,消耗分析师精力。因此,将 AI 生成引入安全运营时,必须配套可验证的有效性证据,而不能仅凭生成结果的“表面合理性”采信。
需要审慎看待的部分
原始信息相当有限,项目披露的细节只停留在主张层面:用什么方法验证规则、验证覆盖哪些攻击场景、误报率如何度量,这些关键问题目前都没有公开数据支撑。Hacker News 上该帖的讨论热度也不高,社区尚未给出实质性的技术反馈或实测结果。
AI 生成检测规则的可信度,最终取决于验证方法本身的严谨程度。如果验证只是在合成数据或有限样本上跑通,规则的实战价值仍然存疑。对于考虑尝试这类工具的安全团队,建议关注其验证机制是否透明、是否支持在自有日志环境中复现检验。
规则验证的常见方法及其局限
检测规则的验证通常依赖三类手段:一是用已知攻击样本(如 Atomic Red Team、CALDERA 模拟)回放测试,检验规则能否触发;二是用正常业务日志评估误报率;三是在真实或仿真环境中进行对抗性测试。合成数据或有限样本上的验证容易高估规则效果,因为真实攻击者会变形、混淆,而正常流量也远比测试集复杂。因此,评估一个规则生成工具时,应关注其验证数据集的来源、规模与多样性,以及是否支持在用户自有日志环境中复现检验——只有能在真实环境中稳定复现的验证结果,才具备实战参考价值。
小结
Doc-foundry 提出的"生成即验证"思路,指向了 AI 在安全运营中落地的一个务实方向:不是替代分析师做判断,而是把规则开发和验证的重复劳动自动化,并且为产出附上可检验的有效性依据。这个方向值得持续观察,但当前可获取的信息还不足以评估其实际效果。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。