DOCA GPUNetIO:统一NVIDIA软件栈的GPU发起网络通信
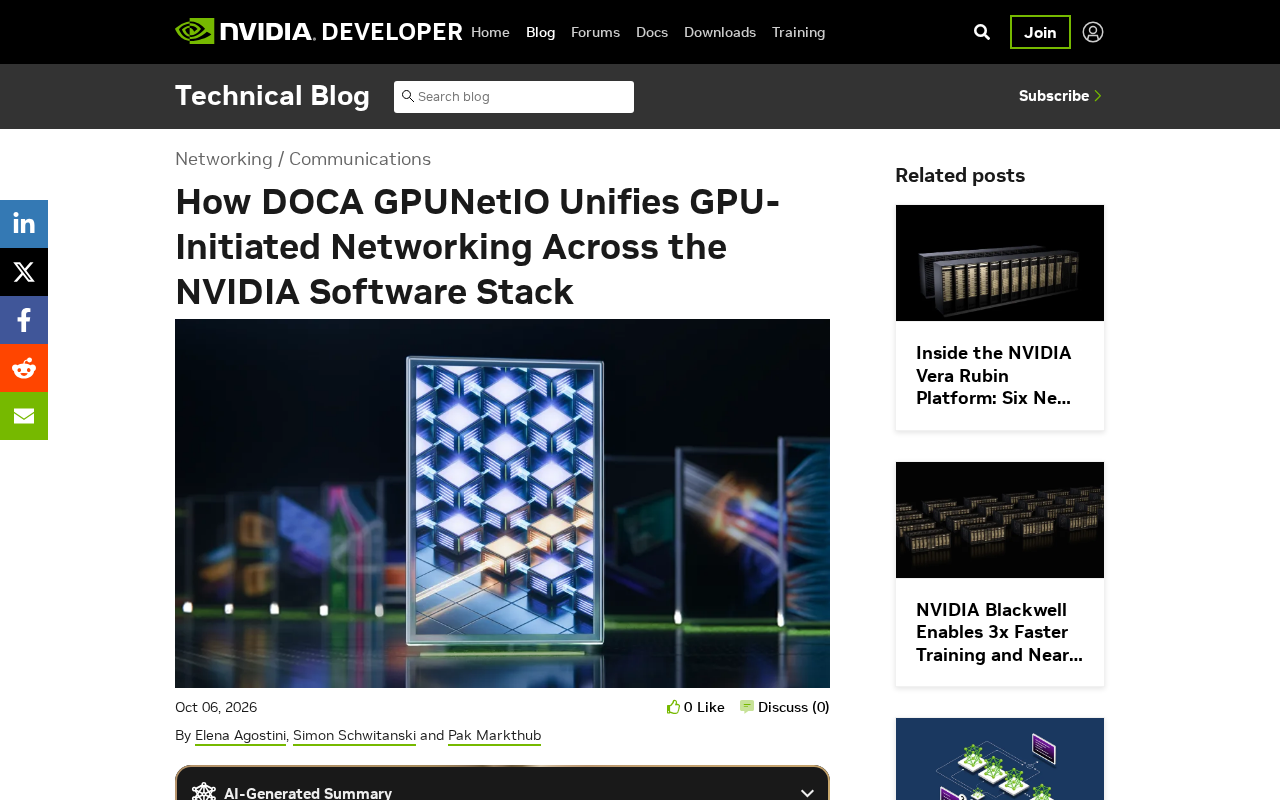
DOCA GPUNetIO让GPU绕过CPU直接控制网络通信,将数据移动与计算深度融合。
DOCA GPUNetIO是NVIDIA DOCA框架中专为GPU直控网络通信设计的组件,旨在打破传统"CPU驱动网络、GPU被动计算"的架构范式。在大规模AI训练和HPC场景下,每次GPU与CPU之间的通信协调都会引入不可忽视的延迟与同步开销,成为扩展瓶颈。GPUNetIO通过在整个NVIDIA软件栈中提供统一的GPU发起网络编程接口,允许通信逻辑直接内联到GPU计算核函数(kernel)中,与计算形成紧密流水线,大幅减少同步点和CPU中介开销。这一技术对分布式AI训练中的集合通信操作、多节点推理的端到端延迟以及HPC应用的计算通信重叠均有直接收益,同时也降低了开发者在不同网络层级间编写适配代码的复杂度。其背后折射出计算与网络界限日益模糊的行业大趋势。
GPU应用对网络与数据移动的需求正在发生根本性转变。过去,网络通信往往被视为由主机(Host)驱动的服务——CPU负责发起、调度和管理数据传输,GPU只是被动的计算单元。但随着大规模AI训练、推理和HPC工作负载的扩展,这种以CPU为中心的模式逐渐成为性能瓶颈。NVIDIA的DOCA GPUNetIO正是为解决这一问题而生,它让网络通信和数据移动成为由GPU直接控制的"一等公民"操作。
为什么需要GPU发起的网络通信
在传统架构中,当GPU完成一轮计算后需要与其他节点交换数据时,必须将控制权交回CPU。CPU负责准备网络描述符、触发传输、轮询完成状态,再通知GPU继续执行。这一来一回的"握手"过程引入了显著的延迟,并且在高并发场景下会让CPU成为调度瓶颈。
随着模型规模不断扩大,节点间通信的频率和数据量急剧增加。每一次由主机驱动的往返都意味着额外的同步开销和上下文切换。对于延迟敏感的分布式训练与推理任务而言,这种开销会直接拖累整体吞吐量和扩展效率。
GPU发起的网络通信(GPU-Initiated Networking)从根本上改变了这一流程:GPU可以在不经过CPU中介的情况下,直接发起远程内存访问、消息发送和数据接收。这意味着通信逻辑可以内联到GPU的计算核函数(kernel)中,与计算形成更紧密的流水线,大幅减少同步点。
GPU发起的网络通信(GPU-Initiated Networking)依赖于两项关键底层技术:GPUDirect RDMA 和 RDMA(Remote Direct Memory Access)。RDMA允许一台机器直接读写另一台机器的内存,绕过操作系统内核和CPU的介入,显著降低延迟。GPUDirect RDMA则在此基础上更进一步,允许网卡(NIC)或InfiniBand适配器直接与GPU显存(VRAM)交换数据,完全跳过主机内存(Host RAM)这一中间站。传统路径下,数据需经历"GPU显存→主机内存→网卡"的多次拷贝,每次拷贝都消耗PCIe带宽并引入延迟。GPUDirect RDMA将这条路径压缩为"GPU显存↔网卡"的直接传输。DOCA GPUNetIO在此之上进一步将控制平面也迁移到GPU侧,使得不仅数据路径、连发起和管理操作的逻辑也无需CPU参与,从而实现真正意义上的GPU完全自主通信。
DOCA GPUNetIO的核心定位
DOCA GPUNetIO是NVIDIA DOCA软件框架中专门面向GPU直控网络的组件。它的目标是在整个NVIDIA软件栈中提供一套统一的接口,让开发者能够从GPU侧直接管理网络I/O,而无需依赖CPU的持续参与。
这种"统一"的意义在于:以往不同层级的网络能力——从底层的RDMA、以太网,到上层的通信库——往往需要开发者针对不同场景采用不同的编程模型。GPUNetIO试图将这些能力整合到一个一致的抽象层下,使GPU发起的通信能够跨越DOCA、CUDA以及更上层的框架无缝协作。
对于构建在NVIDIA BlueField DPU和GPU之上的现代数据中心架构来说,这种统一尤为关键。它让网络、存储和计算资源能够以更接近硬件的方式协同,减少中间层的性能损耗。
NVIDIA BlueField DPU(Data Processing Unit)是理解GPUNetIO定位的重要背景。DPU是一类专用处理器,集成了网络接口、存储控制和通用计算核心,能够在数据进入主机之前完成数据包解析、加密/解密、压缩等操作,将原本由CPU承担的基础设施类任务卸载出去。在GPU+DPU的协同架构中,DPU负责处理网络控制层面的繁琐事务(如流量管理、安全策略),而GPU则专注于大规模张量计算。DOCA(Data-Center-on-a-Chip Architecture)是NVIDIA为BlueField DPU提供的统一软件开发框架,GPUNetIO作为其子组件,充当GPU与DPU之间的编程桥梁,使两者能够以协调一致的方式共同驱动数据流动,而不需要CPU作为中间协调者持续在场。
对AI与HPC工作负载的意义
对于大规模分布式AI训练,通信往往占据了可观的时间比例。将通信控制权下放到GPU,可以让集合通信(collective operations)等关键操作减少对CPU的依赖,从而在扩展到数千甚至上万GPU时保持更好的线性度。
在推理场景中,尤其是涉及多节点协同的大模型推理,低延迟的GPU直控通信有助于缩短端到端响应时间。而在传统HPC领域,许多科学计算应用同样受益于计算与通信的深度融合,减少了计算阶段与数据交换阶段之间的"空档"。
从工程角度看,GPUNetIO提供的统一编程模型也降低了开发和维护成本。开发者不必为每种网络传输或每个软件层编写专门的适配代码,而是可以依托一致的API来表达GPU发起的通信意图。
集合通信(Collective Operations)是分布式AI训练中通信开销的主要来源之一。常见操作包括 AllReduce(将所有节点的梯度求和后广播回每个节点)、AllGather(收集所有节点的张量片段拼成完整张量)和 ReduceScatter 等。以AllReduce为例,在每个训练迭代的反向传播结束后,所有GPU必须同步梯度才能继续下一步参数更新,这一步骤在数千卡规模下可能消耗数十毫秒甚至更长时间。NCCL(NVIDIA Collective Communications Library)是目前最广泛使用的GPU集合通信库,但其底层仍依赖主机侧的调度逻辑。GPU发起的网络通信技术可以让这类集合操作的触发与等待逻辑直接嵌入GPU核函数,消除GPU计算完成后"等待CPU下达通信指令"的空窗期,对于追求极致扩展效率的超大规模训练集群意义尤为突出。
技术趋势的信号
DOCA GPUNetIO的推出反映了一个更大的行业趋势:计算与网络的界限正在模糊。随着DPU、GPU和智能网卡的能力不断增强,数据中心正朝着"数据以数据流动的方式驱动计算"的方向演进,而不是让计算单元被动等待数据到位。
将网络操作提升为GPU可直接控制的一等能力,是这一演进的重要一步。它不仅是性能优化,更是编程范式的转变——未来的高性能应用可能会把通信逻辑直接写进GPU核函数,让数据移动与计算真正融为一体。
对于希望在超大规模集群上部署AI和HPC应用的团队而言,理解并采用这类GPU发起的网络技术,将成为释放硬件潜能、提升扩展效率的关键路径。
相关推荐
OpenAI DevDay 发布 Codex Cloud:AI 编程走出笔记本
OpenAI 在 DevDay 2026 推出 Codex Cloud、Space 和 dots,让 AI 编程 Agent 彻底摆脱本地笔记本。本文详解云端环境自动配置、私有资源访问、代码审查重构、Slack 协作与 CLI 改版等关键更新。
OpenAI DevDay 2026:ChatGPT Work如何重塑日常工作流
OpenAI DevDay 2026 演讲详解 ChatGPT Work、Space 与 Dots 三款产品,通过社交运营、竞争研究、人力资源三位内部高频用户的真实案例,展示 AI 智能代理如何接管日常工作、重塑知识工作者的协作方式。
Higgsfield:让AI智能体自己调配算力,重塑创意生产
OpenAI DevDay 2026上,Higgsfield CEO Alex Mashrobov分享了如何构建能自主调配GPU算力的AI智能体,以支撑连续视频生成、自动剪辑等多媒体创作工作流,并探讨了可控性、企业级落地与交互式媒体民主化的趋势。