Docker 为什么让人觉得怪异?一篇 Hacker News 热议的深度解读

Hacker News 热帖「Docker is weird」引发共鸣,探讨 Docker 抽象税与可预测性痛点。
Hacker News 上一则题为「Docker is weird」的帖子获得 366 分和 180 条评论,作者从开发者日常使用中那些说不上错却总觉得别扭的地方切入,引发广泛共鸣。文章分析认为,这种怪异感源于 Docker 在 Linux namespace、cgroup 和联合文件系统之上叠加的管理层,导致构建缓存不可预测、默认配置存在历史包袱、学习曲线被低估。评论区显示开发者更在意可预测性而非简洁性,这解释了围绕 Docker 的封装工具为何层出不穷。文章强调怪异不等于糟糕,复杂性是问题域的映射,并给出将 Dockerfile 视为代码、固定基础镜像版本、显式设计缓存策略等务实建议。
一个引发 180 条讨论的标题
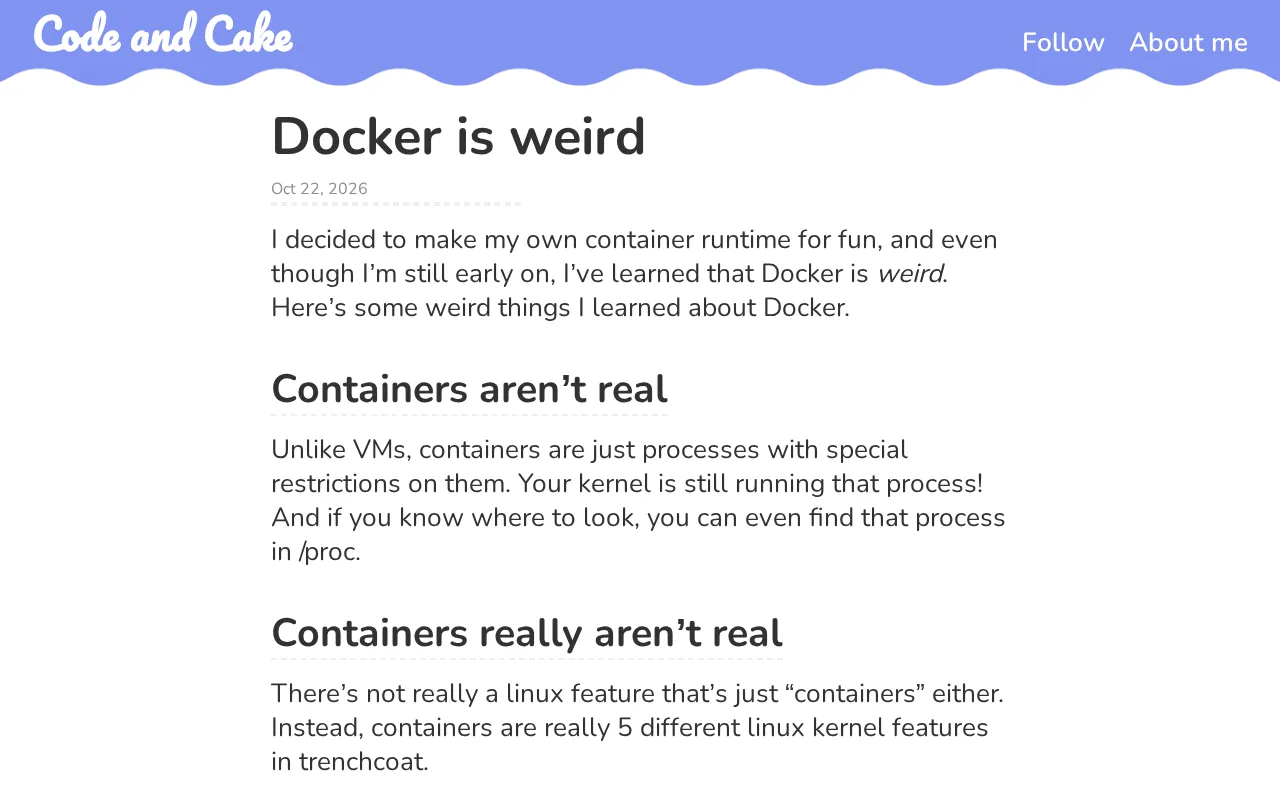
Hacker News 上出现了一个标题相当朴素却收获 366 分、180 条评论的帖子:「Docker is weird」。原始文章来自 codeandcake.dev,作者没有用「Docker 的十大坑」这类标题党写法,而是从开发者日常使用中那些说不上错、但总觉得别扭的地方入手。这种视角恰恰戳中了很多人的共鸣——Docker 已经成为现代软件交付的基础设施,可它的设计逻辑仍然让不少工程师感到「哪里不对」。
怪异感从何而来
围绕这个帖子的讨论很快分成了几类:有人抱怨镜像分层和构建缓存的行为难以预测,有人觉得容器网络和端口映射的抽象层次过多,也有人指出 Dockerfile 的指令集看起来简单,实际组合起来却容易产生反直觉的结果。这些反馈的共同点在于,问题往往不发生在第一次使用,而发生在你已经熟悉它之后——当你以为理解了规则,它又给出一个例外。
Docker 的「怪异」其实是抽象税
两层抽象叠加的代价
Docker 的核心价值是把应用和运行环境打包在一起,但它并非直接操作内核能力,而是在 Linux 的 namespace、cgroup、联合文件系统之上又叠了一层管理层。用户看到的每个 docker run,背后是镜像拉取、容器创建、网络配置、存储挂载等一系列动作。抽象层降低了入门门槛,也意味着当行为偏离预期时,排查路径变长。
社区里经常被提到的例子是构建缓存:Dockerfile 中指令顺序的微小调整可能导致缓存全部失效,而某些看似无关的指令又会意外命中旧缓存。这不是 bug,而是分层文件系统的工作方式决定的,但它与大多数开发者对「构建」的直觉并不一致。
namespace、cgroup 与联合文件系统是理解 Docker 抽象层的关键背景。namespace 负责隔离视图,让容器内的进程只能看到自己的 PID、网络、挂载点等资源;cgroup 负责资源限制与统计,控制 CPU、内存、IO 的分配;联合文件系统(如 overlay2)则把只读的镜像层与可写的容器层叠加成一个统一视图。Docker 本身并不实现这些内核机制,而是通过 containerd、runc 等组件调用它们。正因如此,当容器行为异常时,问题可能出在 Docker 的编排逻辑、containerd 的状态管理,也可能出在内核参数或存储驱动上,排查需要跨越多层。
默认值设计的历史包袱
另一个被反复讨论的点是默认配置。Docker 的许多默认行为在早期版本中是合理取舍,随着使用场景扩展到生产环境,这些默认值就显得保守甚至危险。容器默认不限制资源、日志默认可能无限增长、网络默认桥接模式在复杂拓扑下容易造成困惑。这些设计并非错误,但它们要求使用者主动去了解和覆盖默认值,而这部分知识往往不在入门教程的覆盖范围内。
**桥接网络(bridge network)**是 Docker 默认网络模式,容器通过虚拟网桥获得独立 IP,并通过 iptables 规则实现 NAT 和端口映射。这种模式在单机简单场景下开箱即用,但在多主机、多网络或与现有网络拓扑集成时,会引入额外的地址转换和路由复杂度。用户看到的 -p 8080:80 背后是一整套 iptables 链和网桥配置,一旦出现端口冲突或跨容器通信异常,理解这些隐藏规则就成为排错前提。这也是评论区认为网络抽象层次过多的原因之一。
从评论区看开发者真正在意什么
可预测性优先于简洁
180 条评论中,一个高频主题是「可预测性」。开发者可以接受复杂,但难以接受同样的输入产生不同的结果。容器构建在不同机器、不同 Docker 版本上的行为差异,是讨论中出现较多的痛点。这也解释了为什么围绕 Docker 的替代方案和封装工具层出不穷——它们大多不是要取代 Docker,而是试图把不可预测的部分收敛起来。
**多阶段构建(multi-stage build)**是 Docker 为缓解构建复杂性和镜像膨胀提供的机制:在一个 Dockerfile 中定义多个 FROM 阶段,前面的阶段用于编译和测试,最终只把产物复制到精简的运行阶段。它能把构建环境与运行环境分离,显著减小镜像体积,但也增加了 Dockerfile 的结构复杂度。评论中提到的构建不可预测问题,在多阶段构建中同样存在——阶段间的缓存依赖和指令顺序仍然影响最终结果,需要显式设计才能稳定复现。
学习曲线被低估
不少评论者提到,Docker 的入门演示极其简单,一个 hello-world 镜像就能跑起来,但要真正掌握构建优化、多阶段构建、网络调试、存储驱动选择等内容,所需的知识量远超预期。这种「入门容易、精通难」的曲线,让很多团队在项目中期才开始补课,而那时架构决策已经做出。
怪异不等于糟糕
复杂性是问题域的映射
补充一点,帖子标题里的「weird」更多是一种体验描述,而非否定性评价。容器化本身要解决的问题——环境一致性、依赖隔离、可复现构建——天然带有复杂性。Docker 把这份复杂性封装成了相对统一的接口,已经大幅降低了直接操作底层机制的难度。评论区的讨论也大多停留在「希望更好用」,而非「应该被替代」。
对使用者的实际启示
从这场讨论中能提炼出几条务实的建议:把 Dockerfile 当作需要 review 的代码而非配置文件;在 CI 中固定基础镜像版本,减少漂移;对关键构建步骤做缓存策略的显式设计;以及为团队建立容器相关的排错知识库。这些做法不能消除「怪异感」,但能把它的影响控制在可管理范围内。
结语
「Docker is weird」之所以能引发广泛共鸣,是因为它说出了很多工程师的共同体验:一个每天都在用、却始终没有完全驯服的工具。这种坦诚的讨论比单向的赞美或批评更有价值,它提醒我们,基础设施工具的成熟不仅体现在功能上,也体现在使用者对其行为边界的清晰认知上。
相关推荐
计算机博士解析:应届生AI职业规划,算法与应用开发如何选?
计算机博士建议应届生AI职业规划:优先尝试算法岗但不必死磕,应用开发机会更多。重点学习大模型微调部署与智能体框架(MetaGPT、LangChain),关注AI+行业落地,拓宽就业路径。
Agent应用开发入门:从概念到实战,搞懂AI智能体
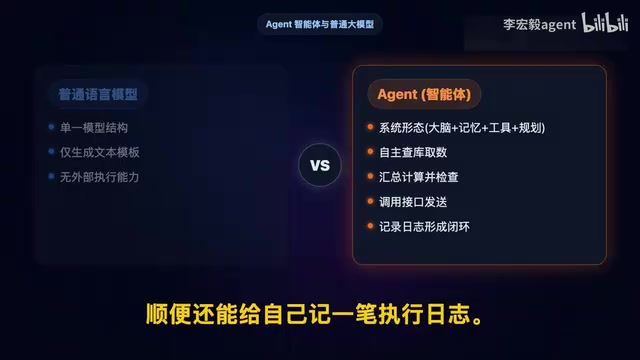
从大模型函数到Agent系统形态,拆解Agent六大核心组件、与传统AI和Workflow的本质区别,以及面试高频追问和生产落地风险,帮助开发者快速建立AI智能体开发的完整认知框架。
小方律师的AI灵魂伴侣:法律AI实战与MaaS启示
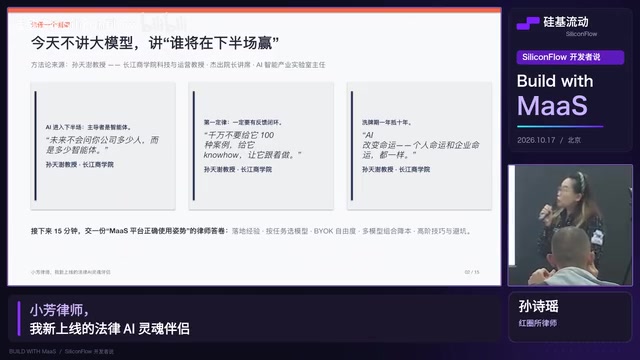
港股IPO律师分享如何用SiliconFlow等MaaS平台打造法律AI智能体"小方":从招股书核查到人情世故判断,BYOK多模型对比、skill沉淀、保密脱敏与Token ROI管理,揭示法律行业AI重构的真实账本与MaaS平台启示。