Docker服务器备份难题:寻找真正好用的3-2-1方案
Docker用户普遍缺少一款能自动理解compose项目结构、按项目粒度备份数据卷的开箱即用工具。
一位Reddit用户的发帖揭示了Docker自托管生态中一个普遍存在的痛点:现有备份工具要么是通用文件备份工具(如Duplicati)不懂Docker项目语义,要么是高效但门槛较高的命令行工具(如Borg、Restic),要么是依赖标签配置、容易静默出错的方案(如Nautical Backup)。用户的理想需求其实清晰而合理——自动发现所有docker-compose项目及其数据卷、按项目独立备份、支持3-2-1备份策略、提供Web界面和备份钩子脚本——但目前没有一款工具能完整覆盖。这一缺口的技术根源在于Docker数据卷的bind mount与named volume二元机制,使得自动发现备份源本身就有一定复杂度。在理想产品出现之前,Restic加调度封装、结合备份前后钩子脚本仍是务实选择。
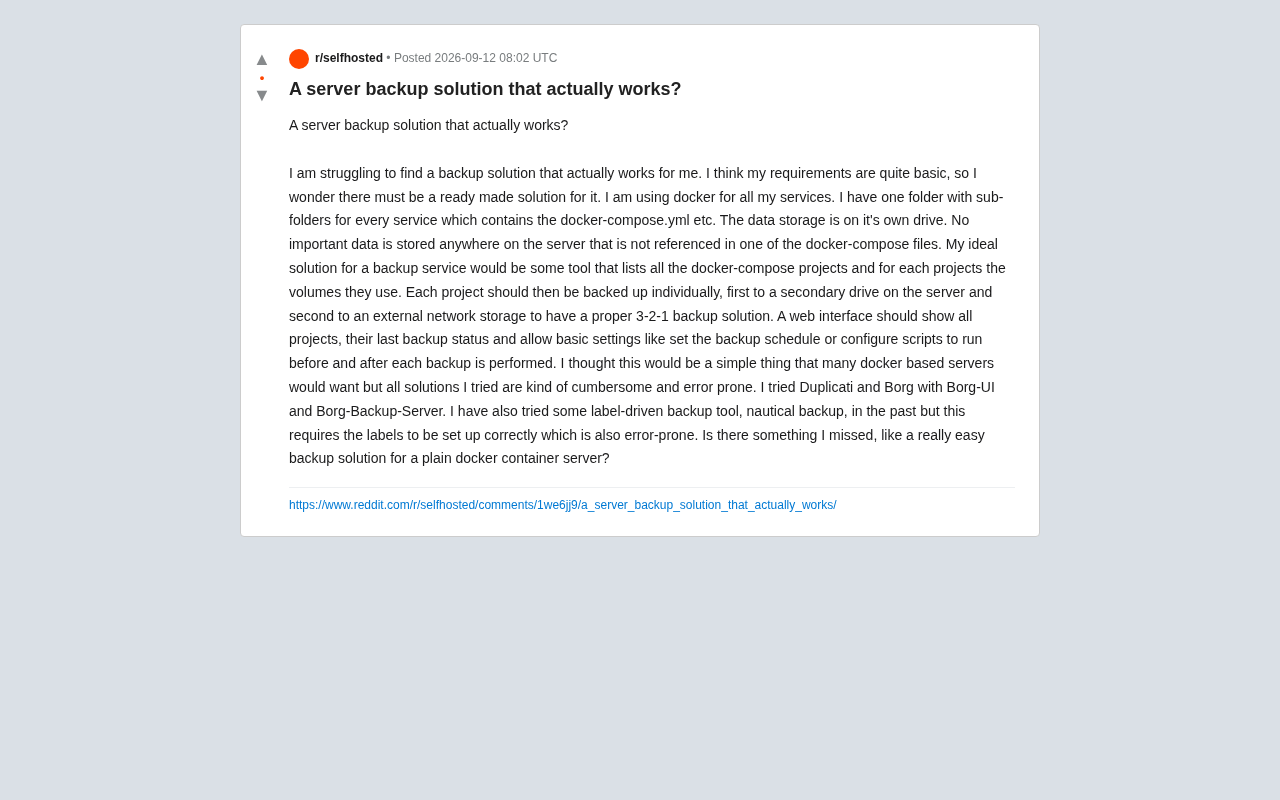
对于自托管(self-hosted)服务器的运维者来说,备份是一个看似简单却始终没有完美答案的问题。一位Reddit用户在社区发帖求助,详细描述了自己在寻找Docker服务器备份方案时遇到的困境——这代表了大量Docker用户的共同痛点。
一个典型的Docker备份需求
这位用户的服务器架构其实相当规整:所有服务都跑在Docker容器里,每个服务对应一个子文件夹,里面放着各自的docker-compose.yml等配置文件;数据存储独立在单独的硬盘上;整个服务器上不存在任何游离于docker-compose引用之外的重要数据。
换句话说,他的理想备份逻辑非常清晰:只要能识别所有docker-compose项目以及它们使用的数据卷(volumes),对每个项目独立打包备份就够了。
他心目中的理想工具应该具备这些能力:
- 自动列出所有docker-compose项目及其关联的数据卷
- 每个项目独立备份,而不是一锅端
- 支持先备份到服务器本地的第二块硬盘,再同步到外部网络存储,符合经典的3-2-1备份原则
- 提供Web界面,展示每个项目的最新备份状态
- 能配置备份计划(schedule),以及在备份前后执行自定义脚本(比如停容器、导出数据库)
这套需求听起来并不奢侈,反而像是绝大多数基于Docker的家庭服务器用户都会想要的基础功能。
为什么现有方案总是差一口气
发帖者坦言,他试遍了主流工具,但每一个都让他感到「繁琐且容易出错」。
Duplicati 是老牌的开源备份工具,带Web界面、支持多种云存储后端,但它面向的是通用文件备份,并不理解「Docker项目」这个概念。用户需要自己手动指定路径,缺乏按项目组织的视角。
Borg(配合Borg-UI、Borg-Backup-Server)以去重和加密著称,备份效率极高,是很多人的心头好。但它本质是命令行工具,即便套上UI,配置门槛依然不低,对于「每个compose项目单独管理」的诉求支持得并不直接。
Nautical Backup 走的是另一条路——标签驱动(label-driven)。它通过读取容器上的标签来决定备份行为。理论上很优雅,但发帖者指出了一个致命弱点:依赖标签配置的正确性。一旦某个容器标签写错或漏配,备份就可能悄无声息地失败,这种「静默出错」恰恰是备份场景最怕的。
这些工具的共性问题在于:它们要么是通用备份工具强行适配Docker,要么把复杂度转嫁给了用户的手动配置。没有一款真正站在「Docker服务器运维者」的视角,把「项目—数据卷—备份目标」这条链路自动串起来。
这暴露了自托管生态的一个缺口
这个帖子之所以值得讨论,是因为它揭示了Docker自托管生态中一个真实存在的空白。
Docker极大地简化了服务的部署和迁移,docker-compose.yml天然就是服务的「声明式清单」。按理说,备份工具完全可以解析这些清单文件,自动发现每个服务挂载的数据卷,进而实现按项目粒度的智能备份。这在技术上并不难,难的是有没有人把它做成一个开箱即用、带友好界面的成熟产品。
现实是,备份这件事处于一个尴尬地带:硬核用户习惯用Borg、Restic写脚本加cron定时任务,他们不需要Web界面;而轻度用户又被现有工具的配置复杂度劝退。中间这块「既要自动化、又要可视化、还要理解Docker语义」的需求,恰恰缺少一个恰到好处的解决方案。
3-2-1原则为何如此重要
发帖者特意强调了3-2-1备份策略,这值得展开说明。3-2-1原则指的是:保留3份数据副本,存储在2种不同介质上,其中1份放在异地(off-site)。
他的方案设计完全契合:原始数据(1)+ 本地第二块硬盘(2)+ 外部网络存储(3),本地盘和网络存储构成两种介质,网络存储提供异地容灾能力。这是一套经过实践检验的可靠策略,也说明这位用户对备份的理解其实相当到位——他缺的只是一个能把这套思路自动化落地的工具。
可能的替代思路
虽然原帖没有给出最终答案,但从社区实践来看,几个方向值得Docker用户参考:
- Restic + 调度封装:Restic在去重、加密和多后端支持上与Borg类似,配合一些封装项目或自写脚本,可以按目录结构实现项目级备份。
- 备份前后钩子(hooks):无论用哪款工具,利用备份前后脚本来停止容器、导出数据库快照(如
mysqldump),能有效避免备份到不一致状态的数据,这是保证备份可用性的关键。 - 接受「配置一次」的成本:现实中或许没有完全零配置的方案,把精力投入到一次性写好一套可靠的备份脚本并做好监控告警,可能比不断试用新工具更划算。
说到底,这位用户的困惑代表了许多自托管玩家的心声:Docker让部署变得简单,但备份的体验还远未跟上部署的便捷程度。在一款真正理解Docker语义、开箱即用的备份产品出现之前,动手组合现有工具、做好监控,仍是当下最务实的选择。
相关推荐

英特尔股价暴跌:AI挤压PC引发政府持股缩水
英特尔股价大幅下跌致政府持股价值缩水约120亿美元。AI行业大量吞噬内存等组件推高PC价格、压制销量,英特尔核心PC业务承压。本文解析这一供应链连锁反应及其对芯片产业格局的影响。
Anthropic IPO后或获高收益垃圾级评级
据RSS报道,AI实验室Anthropic在IPO后预计将获得信用评级机构的高垃圾评级。本文解读高收益垃圾级评级的含义、对融资成本的影响,以及AI公司资本结构的行业背景。

Applebee's应用硬编码数据库密码泄露客户数据
安全研究人员在Applebee's移动应用中发现硬编码的数据库密码,凭据允许不受限制访问客户个人数据。本文分析事件成因、客户端凭据管理的常见缺陷,以及后端代理、短期令牌、发布前密钥扫描等防护实践。