豆包工作实战:把GitHub爆火开源项目装成可用的AI Agent
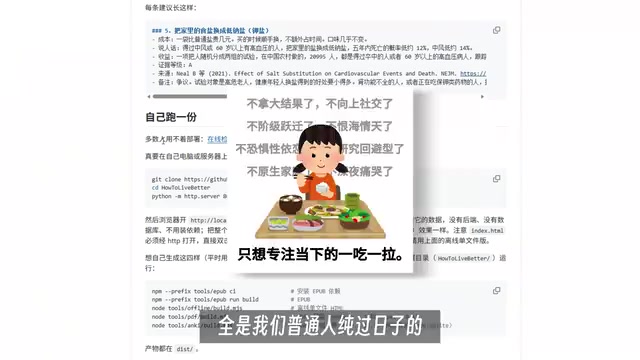
安装成功不等于能用,三项检验判断AI是否真读了开源项目。
文章以 GitHub 上爆火的人生指南项目为例,完整演示了将开源仓库接入豆包工作台并安装为 Skill 的流程,随后重点提出「装成功不等于能用」的核心观点。作者给出三项验收检验:回答是否给出章节编号、数字能否与原文对上、对书外问题敢不敢说不知道,并补充规则层面的硬约束追问,以及按个人情况真实使用的场景测试。最终提炼出一套可复用于任何 AI Agent 接入开源项目的验收思路,强调区分「看起来能用」与「确实能用」。
从安装到真能用:AI Agent 落地的一道关键检验
把 GitHub 上的开源项目装进 AI 工作台,很多教程到「安装成功」就结束了。但装成功不等于能用——这是本期实战最值得记下来的一句话。以最近在 GitHub 上爆火的高性价比人生指南为例(该项目 15 号发布,一个月已揽下 7 万颗星),作者完整走了一遍从安装到验收的流程,并给出了三条可复用的检验方法。
这个项目的底层逻辑是用最少的时间、金钱和精力换回更多寿命与自由,全文覆盖 34 个主题、600 多条建议,定位是「普通人纯过日子的实用单」,不需要在评论区求资源。
第一步:安装 Skill,让工作台自动读取仓库
操作路径并不复杂:在搜索引擎输入 How to live better,找到星级最高的那个仓库,点击作者页右上角的绿色 Code 按钮复制链接,然后打开豆包工作(本地电脑版),把链接粘进去,并给出一句明确指令:获取 GitHub 上的这个项目并安装人生决策 skill。工作台会自动读取代码、获取资源并完成 skill 安装。
这一步的价值在于,用户不需要手动 clone、配环境、读 README 装依赖,AI 工作台把「获取代码—解析结构—注册能力」串成了一次对话。对不熟悉命令行的普通用户来说,这是开源项目真正能被用起来的前提。
Skill 是 AI 工作台中一种可插拔的能力模块,通常以结构化描述文件定义输入输出、调用方式与依赖资源。当用户发出「安装人生决策 skill」的指令时,工作台会解析 GitHub 仓库的目录结构,提取其中的知识库、规则和工具定义,将其注册为可被模型调用的技能。这与传统的「克隆仓库—安装依赖—配置环境变量」流程不同,Skill 机制把整个接入过程封装成一次对话,模型在后续回答时可主动检索该技能携带的语料,而非仅依赖预训练记忆。理解这一点,才能明白后文「编号、数字、边界」三项检验针对的正是技能是否被正确挂载并实际参与推理。
第二步:跑一个真实问题,看它答得对不对
技能栏多出图标后,直接问第一个问题:按性价比一般、证据 A 级的那条,换低钠盐值不值?
它给出的回答是:成本就是一袋盐贵几块钱,顺手换口味几乎不变;收益来自 2 万人实验,换盐的人 5 年死亡概率低约 12%,证据 A 级,并指向 2021 年那篇研究。
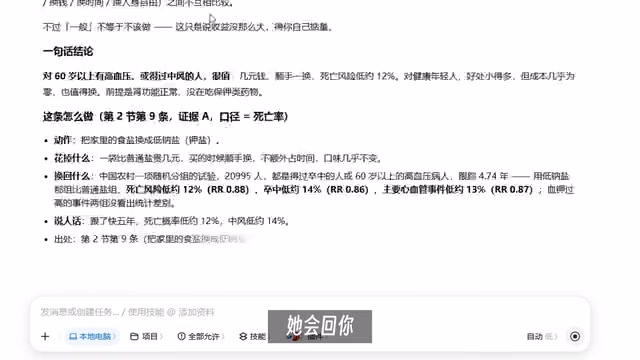
回答读起来很顺,但这恰恰是最容易骗过人的地方。流畅不等于读进去了,接下来才是真正的验收环节。
第三步:三项检验,判断它是真读了还是拿常识在答
检验一:有没有给出章节编号
书里每条建议都有编号。如果回答只给一段顺溜的话却不给编号,说明它是拿常识在答,根本没读进去。编号是引用来源的最小证据。
检验二:数字能不能对得上原文
它说 12%,就让它把原文调出来,或者自己去仓库搜「低钠盐」核对。数字对得上,这条才算过。这一步本质上是在验证检索链路是否真的打通,而不是模型在凭记忆复述。
检索增强生成(RAG) 是让模型在回答前先从外部知识库中检索相关片段、再基于检索结果生成答案的技术。在本例中,Skill 安装后形成的知识库就是 RAG 的检索源。数字核对之所以关键,是因为它直接检验检索链路是否打通:如果模型只是凭训练数据中的常识复述「低钠盐有益」,它可能碰巧说对方向,却无法稳定给出 12% 这样精确的原文数字。反之,当模型能调出原文段落并匹配具体数值时,说明检索器确实命中了目标文档,生成器也在忠实引用检索内容,而非自由发挥。这也是验收 AI Agent 是否「真读了」而非「假装读过」的最直接手段。
检验三:书里没有的,敢不敢说不知道
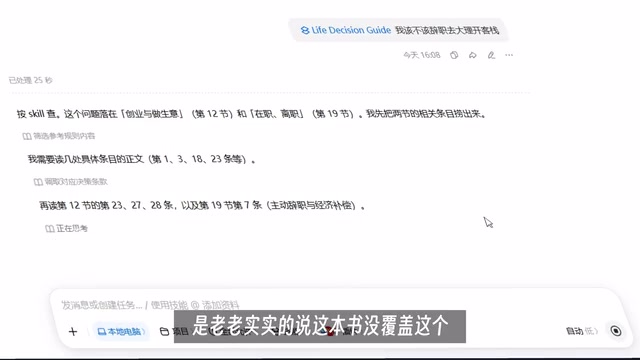
故意问它书里没覆盖的问题,比如「我该不该辞职去大理开客栈」。老实回答「这本书没覆盖这个,我只能给你一般建议」,说明它守住了边界;张口就甩一套方案、还装得像从书里查来的,那就是一本正经瞎扯。
附加检验:规则层面的硬约束
书里明确定了一条规则:寿命、时间、精力、钱这四样不跨口径换算,不放在一把尺子上比高低。于是可以追问:换低钠盐和每月省 500 块哪个更值?如果它硬给你排出 123,说明它根本没读到这条规则——装上了,书没读进去。
口径 在数据分析与决策语境中,指统计或比较时所采用的统一标准和计量单位。书中规定寿命、时间、精力、钱四类资源「不跨口径换算」,意思是它们各自有不同的度量维度,不能简单折算成同一单位后排序。这与常见的「一切皆可货币化」思路相反,是一种方法论上的约束。检验 AI 是否理解这条规则,本质上是看它能否识别并遵守项目自带的价值框架,而不是套用通用的效用最大化逻辑。当模型被追问「换低钠盐和每月省 500 块哪个更值」时,若它强行排出高低,就暴露了它只读了表面建议、没读到背后的规则层。
第四步:按个人情况真实用一遍
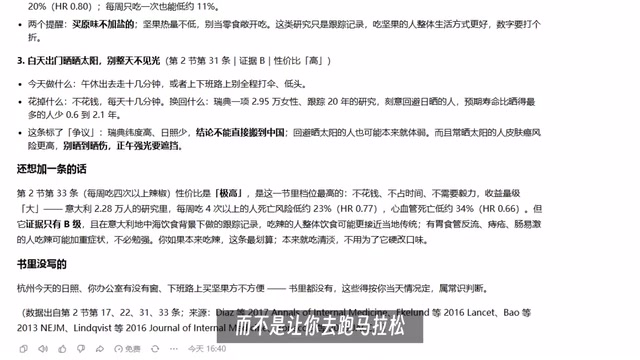
验收通过后,让它按你的实际情况挑三条今天就能做的。比如人在杭州、30 岁、久坐、不上健身房,它应该给出每天吃一小把坚果、午休出去走十几分钟这类成本低、收益确定的建议,而不是让你去跑马拉松。这一步检验的是它能否把规则落到具体场景,而不是复述通用建议。
一个容易被忽略的细节
作者在 README 里写明:这是一份按性价比排好的备选单,不是任务清单,挑走一两条就算数。把这句话也拿去问它——它知道,说明真读了;不知道,那还是没装明白。
这件事真正的启发
一个开源项目装进 AI 工作台只是第一步。能不能按它自己的规矩答话、数字对不对、不知道敢不敢说不知道,这三样验过才算真装明白。对越来越多想把 GitHub 项目接入 AI Agent 的用户来说,这套验收思路比安装步骤本身更值得复用——它把「看起来能用」和「确实能用」区分开了。
相关推荐
通往轨道的路:发射巨构如何终结火箭时代
从质量驱动器、天钩、发射环到轨道环,SFIA 长视频系统梳理通往轨道的发射巨构谱系,揭示交通量如何决定技术选择,以及这些方案为何终将拼成一张运输网络而非彼此竞争。
戈登·拉姆齐对决米其林父子:加利西亚美食寻味记
戈登·拉姆齐深入西班牙加利西亚,与米其林两星主厨佩佩·维埃拉展开美食对决。从死亡海岸的鹅颈藤壶到传统石炉面包,探索加利西亚独特的饮食文化与食材故事。

Soundcore Liberty 5 Pro降至历史低价:通勤通话首选真无线耳机
Soundcore Liberty 5 Pro真无线耳机降至129.99美元历史低价,原价169.99美元。这款Anker旗下声阔耳机以通话质量见长,在Amazon、Best Buy和Walmart同步促销,提供四种配色,适合通勤和线上会议用户。