Dragonfly 2.5解析:P2P如何加速AI大模型分发

Dragonfly用P2P+OCI生态将AI大模型分发从单点瓶颈变为集群协同加速
Dragonfly 是已从 CNCF 毕业的 P2P 文件分发系统,核心价值在于将大规模集群拉取镜像或模型时的源站带宽压力分散到节点之间互传,从而解决"百节点同时回源"的长尾等待问题。2.5 版本在易用性(Injector 自动注入、dfget 直连模型平台)、稳定性(Blocklist 止血、自适应限流)和 AI 场景(OCI 镜像打包模型权重、OCI Image Volume 分离数据与计算)三个维度均有实质推进。面向 AI Agent,新项目 Snapshotter 提供 Sandbox 快照恢复能力,轻量版则降低了中小集群的部署门槛。2.6 版本计划在 12 月底发布,重点引入 Python SDK 与 RDMA 支持,持续深化 AI 场景适配。
Dragonfly:从镜像分发到AI模型加速
在大规模集群场景下,拉取镜像或模型几乎是每个运维团队都遇到过的痛点:当成百上千个节点同时从源站拉取同一个镜像时,源站带宽瞬间被打满,部分节点迅速完成下载,而更多节点陷入长尾等待。Dragonfly 正是为了解决这个问题而生——它是一个基于 P2P 技术的文件分发系统,目前已能加速 OCI 镜像、AI 模型等多种内容的分发。
据博通工程师、Dragonfly Maintainer 张成宇在分享中介绍,该项目去年已从 CNCF 毕业,意味着项目达到了生产成熟可用的阶段。社区贡献者来自蚂蚁集团、阿里云广告、字节等多家公司。与之配套的子项目 Nydus 则基于 RAFS 格式的文件系统,主要用于加速容器冷启动,能将冷启动时间从分钟级压缩到秒级,对 AI 后训练、Agent 等场景帮助显著。
三大核心应用场景
Dragonfly 与 Nydus 覆盖三类典型场景。镜像加速方面有三种组合:直接用 Dragonfly 分发容器镜像,适合大规模集群拉取;Dragonfly 配合 Nydus,兼顾大规模分发与快速冷启动;Nydus 独立部署,适用于只关心冷启动而无分发需求的场景。文件分发是 Dragonfly 的老本行,支持 HTTP、HDFS,以及 S3、OBS、OSS 等兼容 S3 协议的存储。AI 场景则是其紧跟时代的新方向,训练和推理都能从中获得分发提效。
架构拆解:Manager、调度器与 Peer
Dragonfly 的组件并不复杂。Manager 类似 K8s 的 API Server,负责对用户请求做校验和认证;调度器是整个系统的「大脑」,可类比 K8s 调度器,不同的是它调度的是 piece(Dragonfly 的下载粒度),决定某个 piece 应从哪些节点下载;Seed Peer 通常配置为高性能机器负责回源,相当于集群内的 CDN 节点,其他 Peer 节点则从中拉取并互相传输。
下载过程分三种情形:首次下载时集群无缓存,由调度器命令某个 Peer 从源站拉取;二次下载若命中本地 Peer 的 cache,可直接快速拉起;若本地没有但其他 Peer 节点有,则可从多个 Peer 并行下载,避免回源。
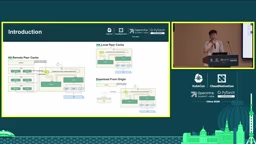
P2P(点对点)文件分发的核心思想是让每个下载节点同时充当上传节点,将文件切分成若干小块(piece)后,各节点之间互相交换不同的块,从而将带宽压力从单一源站分散到整个集群。Dragonfly 的 piece 是调度的最小粒度,默认大小通常在 4MB 左右。调度器在决定"某个 piece 从哪里下"时,会综合考量持有该 piece 的节点数量、各节点的上行带宽余量、网络拓扑(如是否同机房)等因素,尽可能让流量在本地网络内消化,只有在集群内完全没有缓存时才会回源。这种设计使得第 N 个节点的下载速度往往比第 1 个节点更快,因为前序节点已经在集群内积累了大量可供交换的 piece。
2.5 版本的关键更新
2.5 版本带来了一系列面向易用性和稳定性的改进。最直接的是 dfget 命令现在支持从 Hugging Face 和 ModelScope 直接下载模型,用户只需指定模型地址,Dragonfly 会自动读取文件列表(权重、配置文件)并拉取到集群。
Dragonfly Injector 是下半年启动的新项目,专注优化用户体验。过去用户需要手动下载命令行工具或手动挂载 Unix socket,Injector 则通过 sidecar 方式自动注入所需二进制、配置和 socket。其原理基于 K8s 的 webhook admission 机制:识别到 Pod annotation 中的 dragonfly-injector=true 标志后,自动注入 init container,将 dfget 等工具 copy 到共享 volume 并挂载 Unix socket,容器内即可通过 127.0.0.1 访问 Dragonfly。开启只需在安装时打开 injector enable 开关。
Blocklist(黑名单) 针对真实业务中的止血需求。当热点数据或集群过载引发「血崩」效应时,可将占用带宽的任务抓出并配置拦截——GRPC 调用返回 permission denied,HTTP 调用返回 403 Forbidden。该功能同样适用于安全场景,比如禁止下载存在漏洞或遭投毒的文件。除了 Console 和 API 配置,还提供了更 GitOps 友好的 ConfigMap 动态配置方式。
Adaptive Rate Limit(自适应限流) 弥补了静态限流的不足。传统的 upload/download/proxy 限流值是固定的,而自适应限流能基于内存、CPU 等资源配置自动调整,更贴合运行时的实际负载。
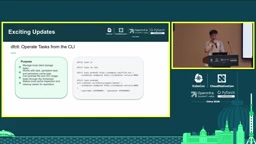
此外,新增的 dfcontrol 工具类似 kubectl,可 list 节点上的 task、删除本地 cache、预热文件或镜像到集群。Proxy 层面新增 proxyAllRegistry 开关,开启后 Dragonfly 可基于 containerd 的 ns 参数自动推断 upstream registry,省去了为每个 registry 单独配置 host.toml 的麻烦。底层还对大文件传输、调度协调机制(parent selector、piece collector)以及 gRPC 参数做了调优。
K8s 的 webhook admission 机制(准入控制器)是 API Server 的一道扩展钩子:当集群收到创建或修改资源的请求时,会先将请求转发给注册的 webhook 服务,由外部逻辑决定是否允许(Validating)或修改(Mutating)该请求,再继续后续流程。Dragonfly Injector 使用的是 Mutating Admission Webhook:在 Pod 被实际调度到节点之前,拦截 Pod 创建请求,检查其 annotation,如果发现 dragonfly-injector=true 便自动向 Pod spec 中追加 init container 和 volume 定义。这种方式的优势是对业务容器完全无侵入——开发者无需修改镜像或部署脚本,只需打一个标签,Dragonfly 的全套工具链便会在 Pod 启动时自动就位。
用 OCI 镜像思路分发 AI 大模型
随着 Kimi K2 等模型规模突破 2TB,推理引擎在 serve 模型时需要下载全部权重,传统的单点下载极其缓慢。Dragonfly 的解法是复用成熟的软件交付范式。
传统流程中,开发者提交代码触发 CI/CD,构建 binary、打包成 OCI 镜像、push 到 registry,再通过 P2P 分发到集群部署。AI 模型场景几乎完全一致,只是把「构建 binary」换成「将模型权重和配置 bundle 成 OCI 镜像」。这样做的最大好处是:只要支持容器镜像的 registry 都能存储模型镜像,并能复用镜像已有的扫描、签名、版本控制、访问权限等能力。

打包时,每个 safetensors 文件打成单独一层,配置文件也各成一层,可用 ModelKit 工具生成 OCI 镜像(Docker 新版本也已支持)。以 Harbor 为例,模型镜像可获得版本化控制(v1/v2/v3)、生命周期管理、跨数据中心 replication、RBAC 访问控制、签名防投毒以及审计等完整能力。
在部署层面,Dragonfly 实现了数据与计算分离。K8s 1.31 引入的 OCI Image Volume 机制可让推理引擎(如 vLLM)与模型解耦——在 Pod 的 volumes 中通过 image 字段的 reference 指向模型地址,K8s 启动时由 containerd 或 CRI-O 下载并挂载。该特性在 1.33 已成为默认开启的 stable 特性(注:原分享口述为「1.36」,此处以 OCI Image Volume 实际演进为准,读者可参考官方文档)。对于无法升级到最新版本的老集群,Dragonfly 还提供 Model CSI Driver 方案,一条命令即可部署。配合 Harbor 的预热策略,模型 push 后可自动触发预热到所有节点,大幅降低首次启动延迟。
OCI(Open Container Initiative)是由 Docker、CoreOS 等公司联合发起的容器标准化组织,负责制定镜像格式(Image Spec)和运行时规范(Runtime Spec)。OCI 镜像本质上是一组按层叠加的 tar 包,每层对应文件系统的一次变更,层与层之间通过 SHA256 摘要链式引用,天然具备内容寻址和去重能力。将 AI 模型权重按文件粒度打成独立层,意味着当模型从 v1 更新到 v2 时,只有真正变化的权重文件层需要重新下载,未变动的层直接复用本地缓存——这对动辄数百 GB 的大模型增量更新尤为关键。safetensors 是 Hugging Face 推出的安全张量序列化格式,相比 pickle 格式的 .bin 文件,它不包含可执行代码,天然防止投毒攻击,因此已成为模型分发的主流格式。
面向 Agent 的 Snapshotter 与轻量版本
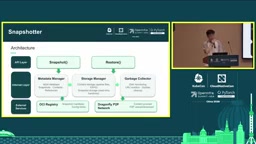
针对 AI Agent 场景,新项目 Snapshotter 用于对 Agent 的 Sandbox 做快照与恢复。它提供 Go SDK,将 Sandbox 内文件打快照存储到 Dragonfly 集群,再利用 P2P 加速其在多个节点上的 restore 速度。对外仅暴露 Snapshot 和 Restore 两个 API,内部负责元数据、存储和 GC 管理。快照数据分两路:元信息存入 OCI Registry,实际数据存入 P2P 网络。Restore 时先检查本地 CAS,未命中则从 P2P 下载还原。
另一项重要更新是轻量版 Dragonfly。此前部署形态组件较多,需要 Manager、MySQL、Redis 等依赖;轻量版移除了数据库等重组件,仅保留调度器、Seed Client 和 Client,通过 K8s Service 机制让 Client 自动发现对应 Scheduler。这显著降低了部署复杂度,适合资源较少的集群或边缘节点,直接 Helm install 即可。代价是功能有所取舍——如需大而全的能力,仍需部署 Redis 与 Manager。
CAS(Content-Addressable Storage,内容寻址存储)是一种以数据内容的哈希值作为唯一标识符来存储和检索数据的机制。与传统的路径寻址(按文件名和目录定位)不同,CAS 能天然实现去重——内容相同的文件无论来自哪个快照,在存储层只保留一份。Dragonfly Snapshotter 在 Restore 时先查本地 CAS,即检查目标节点是否已经存有内容相同的数据块,命中则直接复用,大幅减少 P2P 网络传输量。这对 AI Agent 场景尤为重要:大量相似的 Sandbox 环境(如同一基础镜像上微调的不同 Agent)在快照层面会有极高的重复率,CAS 机制可将实际存储与传输开销压缩到理论最低值。
2.6 版本展望
按计划,2.6 版本的目标发布时间为 12 月 31 日。路线图涵盖多个方向:Manager 继续优化 CPU/内存并增强 UI 体验;调度器持续改进调度算法,追求带宽利用率的极致压缩;Client 端探索带宽感知调度及 RDMA 支持。AI 功能方面将针对模型与数据集分发做优化(如 Direct IO 写、Buffer IO 读),并计划新增 Python SDK(含 Snapshot SDK),探索与 Agent Sandbox、环境工程的配合。质量层面则考虑引入 AI 能力辅助问题排查。
从镜像分发起家,到如今深耕 AI 模型与 Agent 场景,Dragonfly 展示了一个 CNCF 毕业项目在新需求浪潮下的持续演进路径——用成熟的 P2P 与 OCI 生态能力,解决大模型时代的分发瓶颈。
相关推荐

Jev判断模型实战:6类高频应用场景全解析
Jev是全新的AI判断模型,擅长大规模、高速、低成本的瞬间判断。本文梳理Choice、Score、Null三种提问方式,解析数据分析、语义搜索、输入分流、规则检查、加速智能体、即时响应六大真实应用场景,并给出适用判断标准与风险提示。

AI无需超级智能或恶意,也可能引发核战争
AI引发核战争的真正风险不在于超级智能或恶意,而在于误报、自动化偏见和决策时间压缩。本文分析平庸AI在核指挥系统中的隐患,以及人在回路、可解释性等应对之道。

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。