独立开发者如何用Flask打造多语言AI语音聊天应用
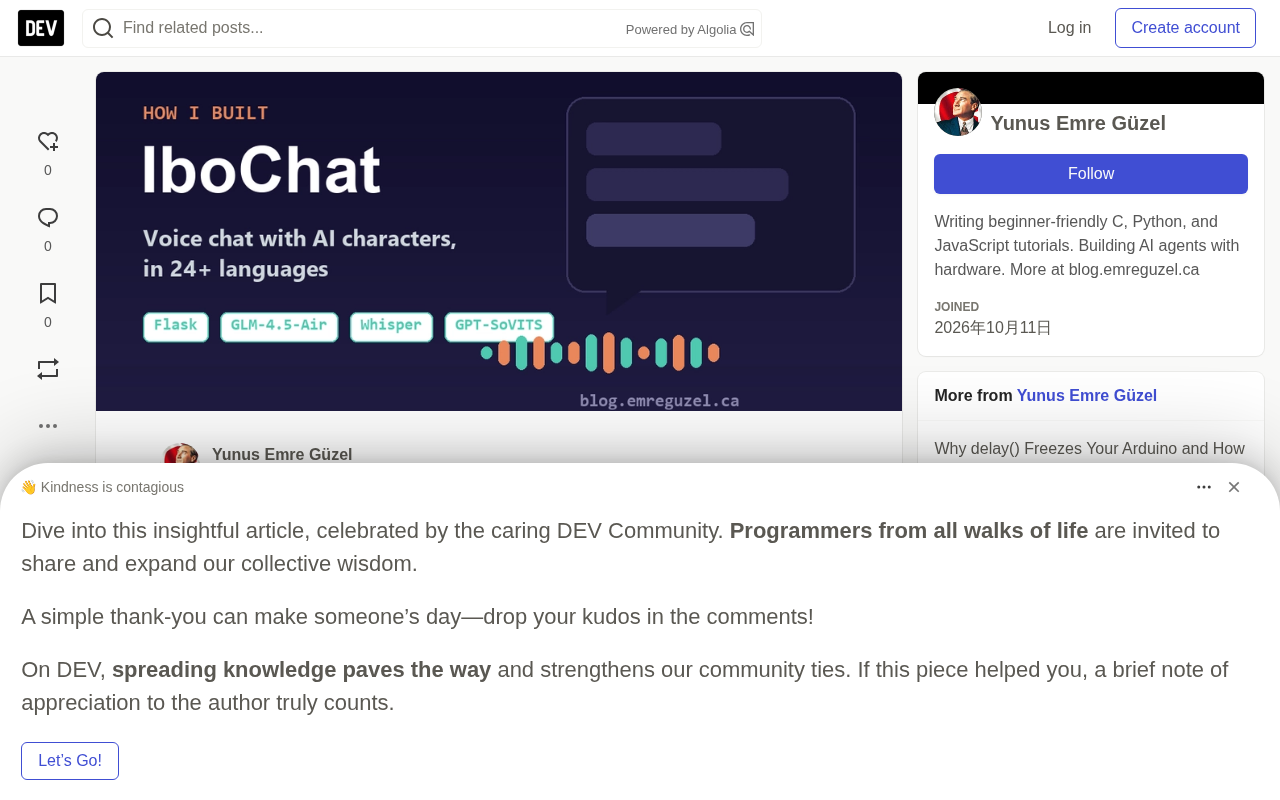
独立开发者在4GB显存下用三级语音降级管线构建多语言角色聊天应用。
文章复盘了独立开发者 Emre Guzel 构建 IboChat 的全过程。该项目用单文件 Flask 整合 GLM 模型、faster-whisper 语音识别和 SQLite 账户系统,刻意避开 React 与微服务以降低维护成本。核心难点在语音:没有任何引擎能同时满足音色克隆、多语言和稳定性,于是设计 GPT-SoVITS、OmniVoice、Edge TTS 三级降级管线。作者还记录了单块 4GB GPU 上两个语音模型争抢显存的 bug,最终靠按需加载、空闲回收和显存清空解决,并强调可用性优先于音质。
为什么一个“会说话”的聊天机器人这么难做?
市面上的聊天机器人大多只能打字。开发者 Emre Guzel 想要的不止于此:角色要听起来像角色本人,在整段对话中保持人设,并且能用用户自己的语言回答。于是他动手构建了 IboChat——一个基于 Flask 的应用,每个角色既能文字回复,也能开口说话,支持 24 种以上语言,用户还能在几分钟内创建自定义角色。
项目已上线(chat.emreguzel.ca),作者在博客中完整复盘了技术栈与踩坑经历。这篇文章值得关注的不是“又做了一个 AI 应用”,而是一个独立开发者如何在单 GPU、4GB 显存的约束下,把语音管线、角色系统和成本控制捏合到一起。
技术选型:刻意保持“无聊”
作者的技术栈可以用朴素来形容:
- Flask,单文件,同时提供页面、JSON API 和音频端点
- GLM(glm-4.5-air) 通过 Z.ai API 作为“大脑”
- faster-whisper 本地运行,负责语音转文字
- SQLite + Werkzeug 哈希 管理账户,启动时自动创建
- Docker 部署在 Cloudflare 之后
没有 React,没有构建步骤,没有微服务。这种选择并非技术能力不足,而是把复杂度留给真正重要的部分——语音管线和角色系统。对于个人项目而言,减少基础设施层意味着更快的迭代速度和更低的维护成本,这个取舍值得很多动辄上微服务的项目反思。
GLM(glm-4.5-air) 是智谱 AI 的大语言模型系列,通过 Z.ai 提供的 OpenAI 兼容 API 调用。所谓“OpenAI 兼容”,是指接口路径、请求体和响应格式与 OpenAI 的 Chat Completions 规范基本一致,开发者可以直接复用现有 SDK 或 HTTP 客户端,只需替换 base URL 和 API Key。glm-4.5-air 属于该系列中定位轻量、低价的档位,适合高频、短回复的对话场景。对个人项目而言,选择兼容端点意味着日后更换模型供应商时改动极小,这也是作者能低成本试错的前提之一。
一条消息的旅程:从输入到“开口”
用户输入文字或语音。如果是语音,faster-whisper 在服务器 CPU 上将其转为文本。后端随后以完全一致的方式构建提示词:角色人格提示、近期历史窗口、用户的语言代码。
这里有一个容易被忽视的工程细节:模型永远不会看到“裸消息”。正是这种提示词构建的纪律性,防止角色在聊天中途漂移成通用的助手腔调。很多角色扮演应用失败的原因,恰恰是提示词组装太随意,导致人格在多轮对话后被模型自身的助手倾向覆盖。
回复以角色身份返回后,真正的挑战才开始:让它说出来。
三级语音管线:没有单一引擎能通吃
作者的需求有三个:听起来像角色、支持任意语言、不能崩溃。没有任何一个引擎能同时满足,于是 /speak 端点按顺序尝试三条路径:
- GPT-SoVITS——克隆音色最佳,合成耗时约 5–18 秒,但仅支持英、中、日、韩四种语言,且加载后永久占用约 3.9GB 显存。
- OmniVoice Studio——支持任意语言,耗时约 30–40 秒,通过 OpenAI 兼容端点调用。
- Edge TTS——微软免费神经语音,无克隆能力,但支持 24 种语言、零延迟、永不失败。
最后一条是安全网,确保应用永远有话可说。这种降级设计思路在语音类产品中尤其重要:用户对“没有响应”的容忍度远低于“音色不够像”。
GPT-SoVITS 是一个开源的少样本语音克隆与合成项目,结合了 GPT 式的自回归建模与 SoVITS 声学模型,只需几秒到几十秒的目标音频即可克隆音色。它的优势是音色相似度高、自然度好,代价是推理时需要加载较大的模型权重,显存占用高、首次加载慢,且官方预训练模型主要覆盖中、英、日、韩等语言。文中“加载后永久占用约 3.9GB 显存”正说明它属于常驻内存型模型,在 4GB 显卡上与另一个语音模型共存几乎不可能,这也是后文生命周期管理问题的根源。
Edge TTS 指调用微软 Edge 浏览器内置的在线神经语音合成服务(常通过 edge-tts 这类非官方客户端库访问)。它无需本地模型、无需 GPU,按文本直接返回音频,因此延迟极低、语言覆盖广,但只提供预设音色,不能克隆用户指定的声音。把它放在管线末端作为“安全网”,本质是用确定可用的兜底方案吸收前两级引擎的加载失败、超时和语言不支持等异常,从而把“无响应”这一最差体验从系统中排除。
三天才解决的 bug:一块 GPU,两个语音模型
GPT-SoVITS 和 OmniVoice 共享同一块 4GB GPU。有一段时间,加载其中一个会导致另一个资源饥饿,音频输出损坏。作者一度以为是 CUDA 安装有问题,重装了两次 PyTorch。
真正的修复不在硬件,而在编排:
- Flask 按需启动 GPT-SoVITS,绝不在启动时加载
- 看门狗线程在空闲 120 秒后将其杀死
- 每次调用 OmniVoice 前清空其显存,避免两个模型互相争抢
这个案例说明,小显存环境下多模型共存的核心矛盾往往不是算力不足,而是生命周期管理缺失。按需加载加空闲回收,比升级硬件更现实。
CUDA 显存是 NVIDIA GPU 上由驱动管理的独立内存池,模型权重、激活值和推理中间张量都要驻留其中。与系统内存不同,CUDA 显存分配后不会自动归还给其他进程,一个进程释放的显存也可能因缓存机制而暂时不可用。当两个模型进程先后申请显存时,先加载者若未显式释放或清空缓存,后来者就会遇到 out of memory 或被迫使用极小的批处理,表现为音频损坏或推理异常。因此文中“清空显存”和“空闲后杀死进程”并非锦上添花,而是多模型共享同一张卡时的必要操作。
冷启动:寂静的死亡
语音模型加载需要约 30–50 秒。如果用户在这个窗口期发消息,请求会挂起。初版实现会一直保持请求打开,用户体验极差。
现在的做法是:服务器先探测模型是否就绪,未就绪则直接降级到下一级语音方案,而不是让用户对着沉默等待。用户听到的是稍逊一筹的音色,而不是超时错误。这个决策背后是对体验优先级的清晰判断——可用性高于音质。
那些小仗:限流、自动播放与语音克隆
- 限流:AI 端点在负载下会触发速率限制。作者使用指数退避重试,话多的用户只会感觉到停顿,不会看到报错。
- 移动端自动播放:浏览器在用户触碰页面前拒绝自动播放音频,所以第一条回复要等首次点击后才播放。烦人,但无解,只能接受。
- 从 YouTube 克隆语音:流程已自动化——yt-dlp 抓取干净片段,ffmpeg 裁剪,OmniVoice 生成声纹,按角色缓存。难点在于找到“足够干净”的片段,作者为此花了一整晚。
- 端点仍叫
/api/gemini:早期版本用 Google Gemini,现在代理到 Z.ai。名字没改,因为改了会破坏自己的前端,也算架构演进的一块墓碑。
成本:LLM 是零头,语音几乎免费
对于想预算类似项目的人,作者给了一个务实的结论:用便宜模型(glm-4.5-air 级别)且每条消息只回文字,对话的 LLM 成本只是“舍入误差”。语音方面,Edge TTS 免费,两个 GPU 模型消耗的是电费。
这意味着 AI 语音聊天应用的门槛比想象中低。真正的成本不在 API 账单,而在工程复杂度——如何让多个语音引擎在有限显存下协调工作。
下一步与开放问题
IboChat 目前将角色明确标注为 AI 戏仿。作者计划加入跨会话长期记忆和更好的对话中途语言切换。
他还在文末抛出一个开放问题:如果你也做过语音 + AI 的项目,如何解决“一块 GPU 两个模型”的冲突?这个问题对独立开发者社区有实际价值——大厂方案通常假设充足算力,而个人项目必须在约束中找路径。
从 Flask 单文件到三级语音降级,IboChat 的构建过程展示了一种务实的 AI 应用开发哲学:不追求架构上的先进,而是把可靠性设计进每一个失败路径。
相关推荐

Product Hunt 推出可视化发布编辑器,告别繁琐填写
Product Hunt 推出可视化发布编辑器,支持点击原位编辑名称、标语、画廊和 maker 信息,自动保存草稿,并用检查清单引导创作者完成发布。本文解析其编辑逻辑与对发布体验的影响。

泽连斯基亲述:俄军2000万人压境,我们如何守住基辅
泽连斯基访谈回顾俄乌战争初期:俄军200,000兵力直扑基辅,乌军主力却在东部。他讲述动员如何将军队从200,000扩张到800,000,以及基辅州、切尔尼戈夫州如何被收复。

Ovren Live Preview:用自然语言实时预览产品改动
Ovren Live Preview 是一款用自然语言描述改动、在真实页面上实时预览的 AI 开发工具。了解其核心功能、工作流、市场定位与潜在挑战。