读研必备两个科研AI工具:文献管理+自动化科研Agent

读研真正离不开的只有两个工具:Zotero 管文献,Closco Science 替你跑代码。
文章提出,研究生阶段真正高频使用的科研工具其实只有两类:一类管理文献,一类执行代码与分析。文献侧以 Zotero 为代表,通过浏览器插件一键入库、滑词翻译配合「问题—方法—结论—局限」四行笔记、Word/WPS 插件自动生成参考文献,把散乱的 PDF 变成可检索、可引用的知识库。代码侧以 Closco Science 为代表,为每个任务分配预装好 Python、R、Latex 的云服务器,能自主写代码、运行、纠错,并支持云端异步执行,合上电脑任务仍在跑。文章最后强调,工具省下的是机械劳动时间,提出好问题、做出判断仍依赖研究者自身。
读研之后你会发现,真正让人疲惫的往往不是课题本身的难度,而是那些看不见尽头的机械劳动——在一堆命名为「Full Text Download 3」的PDF里翻找上周读过的那篇论文,或者花一整天折腾Python环境却始终跑不通别人的代码。工具清单动辄列出几十个,全装上光是切换窗口就够忙一天。B站UP主在视频中给出了一个更务实的思路:读研真正离不开的其实就两个工具,一个管你读过的文献,一个替你动手跑代码、分析数据。
Zotero:让文献从混乱到有序
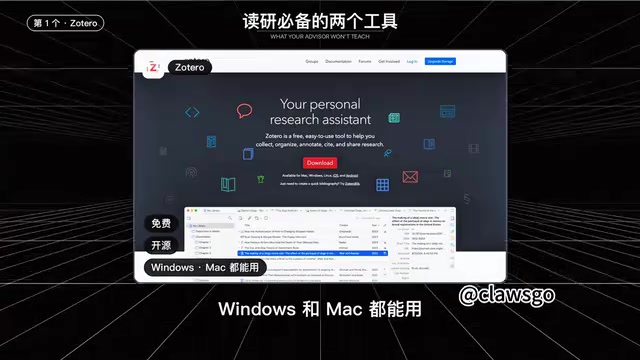
研一开学三个月,电脑里攒了上百个PDF,想找上周读过的那一篇翻了20分钟也没找到,参考文献一条一条手敲格式还是被导师打回来——这种场景对研究生来说并不陌生。Zotero解决的正是这个问题。它免费、开源,Windows和Mac都能用,核心功能可以拆成三件事。
收集:一键存入期刊信息
装上浏览器插件Zotero Connector之后,在期刊页面点一下,标题、作者、期刊、年份就自动存进库里,能拿到PDF的也会一起抓取。中文文献则需要额外装一个茉莉花插件来补全知网信息。这一步的价值在于,文献入库时就已经结构化,后续检索和引用都省去了手动录入的麻烦。
Zotero Connector 是怎么识别文献的? 它并不只是抓取页面上的文字,而是通过读取期刊网站提供的元数据(metadata)来识别文献类型——比如 DOI、PubMed ID、arXiv ID 等唯一标识符。当你点击插件图标时,Zotero 会向这些标识符对应的数据库发起查询,拉回标题、作者、期刊、卷期、页码等结构化字段,再存入本地库。如果网站没有提供标准元数据(部分中文数据库就是如此),插件就会退化为「网页快照」模式,此时才需要茉莉花等第三方插件来补全知网信息。理解这一点有助于排查「为什么有的页面一键能存、有的不行」——关键在于源网站是否暴露了机器可读的元数据。
阅读:滑词翻译与结构化笔记
在Zotero自带的阅读器里装上Translate for Zotero插件,滑词就能看到译文。UP主特别提到一个习惯:每篇读完写四行笔记——问题、方法、结论、局限。笔记跟PDF绑定在一起,以后写论文要找依据,搜一下就能调出来。这个做法把「读过的文献」真正变成了「可复用的知识」。
为什么强调「四行笔记」而不是随便写? 认知心理学里有一个「生成效应」:人在用自己的话重新组织信息时,记忆和理解都明显优于单纯划线或复制。问题、方法、结论、局限这四行,恰好覆盖了一篇论文的论证骨架——它逼着你从「读过了」转成「读懂它在做什么、凭什么成立、哪里可能有问题」。这四行也是后续写文献综述时最好用的检索维度:想找「用某种方法解决某类问题」的论文,直接搜方法或结论那一行即可。把笔记与 PDF 绑定,则保证了任何一条判断都能回溯到原文,避免写论文时出现「我记得有人说过」却找不到出处的情况。
引用:换样式不用逐条改
装好Word或WPS的引用插件后,写到哪里就在哪里插入引用,文末自动生成参考文献。期刊要求的格式不同,换一个引用样式就能全文一次改好,国标GBT7714也有现成的样式可用。
Closco Science:让代码真正跑起来
文献管理只解决了输入端的问题。读研迟早要写代码、处理数据,而找到论文和代码往往只是第一步。真正耗时间的是让它跑起来——版本对不上一开始就装不上,跑到一半报错,好不容易跑通了数字又和论文对不上。
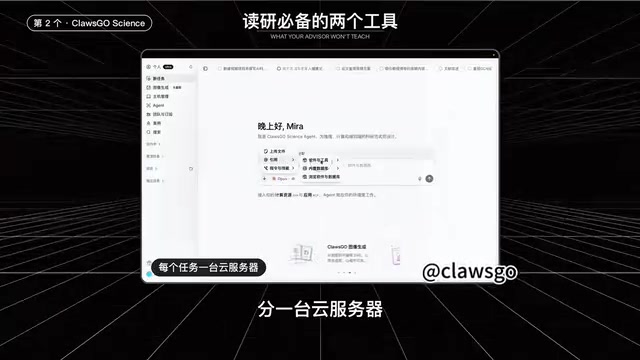
Closco Science是UP主团队这一年正在做的科研Agent,思路是给每个任务分配一台云服务器。
环境预配置,省去本地折腾
系统是Ubuntu,Python、R、Latex和常用的科学计算环境都已经装好,不需要在自己的电脑上配环境。这一步直接消灭了科研复现中最常见的卡点——环境配置。
为什么科研复现最大的敌人是环境? 一篇论文的代码能否跑通,往往不取决于算法本身,而取决于一串看不见的依赖:Python 是 3.8 还是 3.11、numpy 是 1.x 还是 2.x、CUDA 版本是否匹配显卡驱动、有没有某个只在特定系统上编译成功的 C 扩展。这些依赖之间互相约束,形成一个「版本地狱」,本地改一个就可能引发另一个报错。云端预配置的思路是把这套环境固化成一个镜像,每个任务启动时都从完全相同的状态开始,既省去本地折腾,也让复现结果具备可重复性——别人拿到的是同一套环境,而不是「在我电脑上能跑」。
自主写代码、运行、纠错
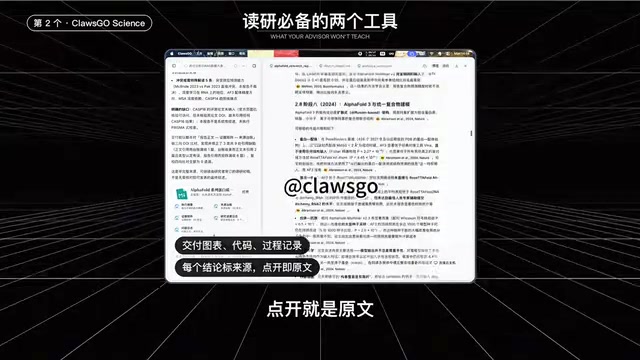
把数据和问题交给它之后,它会自己写代码并真正去运行,报错了就改完接着跑,直到结果正确。需要查资料时,它会打开真实的浏览器去期刊页面查找。你可以在旁边实时观察整个过程。最终交回来的是图表、代码和一份过程记录,每个结论都标了来源,点开就是原文。
Agent 的「自主纠错」意味着什么? 传统脚本一旦报错就停在那里,需要人去看 traceback、改代码、再运行。科研 Agent 的差别在于它把「写—运行—读报错—改—再运行」做成了一个闭环:报错信息本身被当作新的输入,驱动它调整代码,直到程序正常结束。这并不等于结果一定正确——程序跑通和结论正确是两件事,所以「每个结论标来源、点开是原文」这一步很关键:它让使用者能反向验证数字究竟来自哪段计算或哪篇文献。当前这类系统擅长处理边界清晰、可自动验证的任务,对需要判断「这个问题值不值得做」的环节仍然无能为力。
云端异步执行,不占用本地
一次分析可能要跑好几个小时。布置好任务之后可以直接合上电脑,任务在云端继续,用手机就能看进度,跑完会收到通知。
工具之外,判断力仍然是核心
一个负责文献,一个负责动手,读研要做的事基本都能落到这两个工具里。但UP主也给出了一个清醒的提醒:工具省下的是机械劳动的时间,提出好问题、做出判断还是要靠你自己。这其实点出了科研AI工具当前的能力边界——它们擅长执行明确的指令、处理重复性的流程,但问题的定义、方向的取舍、结论的解读,仍然需要研究者本人来完成。
研一的同学可以从现在开始,先去Zotero官网免费下载,Closco Science注册就能领取一台免费云服务器。把机械劳动交给工具,把精力留给真正需要思考的部分。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。