短语级投机解码:冻结目标模型上的新突破

绕开BPE分词约束,用短语级草稿词表实现即插即用的大模型推理加速。
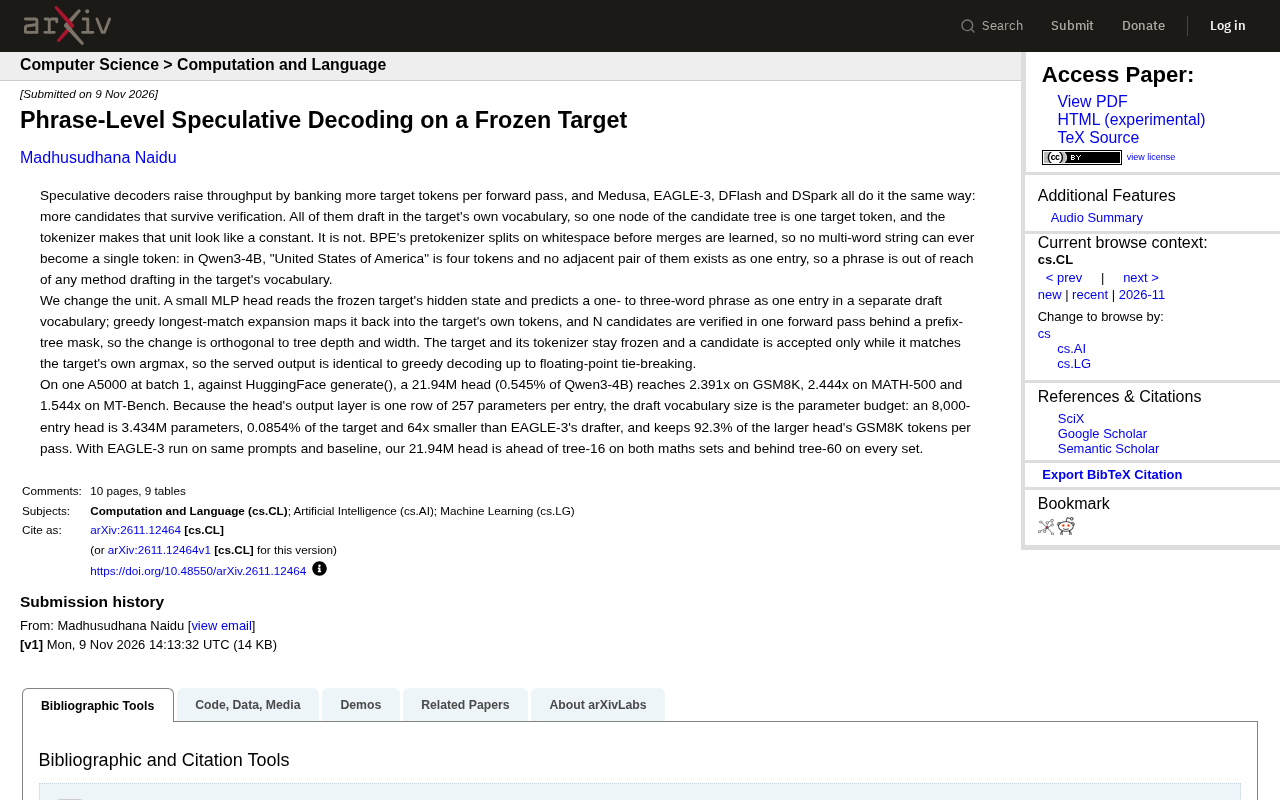
文章指出,Medusa、EAGLE-3 等主流投机解码方案都默认在目标模型词表内生成候选 token,而 BPE 分词器的预分词按空白切分,使多词短语无法成为单个 token,这构成了性能天花板的结构性约束。研究团队引入独立草稿词表,每个条目对应一到三词短语,由小型 MLP 头读取冻结目标模型的隐藏状态直接预测短语,再展开为目标 token 序列,并用前缀树掩码一次验证 N 个候选。目标模型与分词器全程冻结,输出与贪心解码一致。一个 21.94M 参数(占 Qwen3-4B 的 0.545%)的草稿头在 GSM8K 上加速 2.391 倍、MATH-500 上 2.444 倍、MT-Bench 上 1.544 倍;8,000 条目的头仅 3.434M 参数,比 EAGLE-3 草稿器小 64 倍,仍保留 92.3% 的每轮接受 token 数。局限在于仅在 batch size 为 1 下验证,且落后于 tree-60 配置。
投机解码(Speculative Decoding)是提升大模型推理吞吐的主流手段之一,Medusa、EAGLE-3、DFlash、DSpark 等方案的核心思路一致:让草稿模型提出更多候选 token,再通过一次前向验证尽可能多地接受它们。但这些方法都默认在目标模型自身的词表内工作,候选树的每个节点对应一个目标 token。这个看似理所当然的设定,实际上正是性能的天花板所在。
词表约束:多词短语为何无法成为单个 token
BPE 分词器的预分词步骤会先按空白切分,再学习合并规则,因此任何包含空格的词组都不可能成为单个 token。以 Qwen3-4B 为例,"United States of America" 会被拆成四个 token,而且任意相邻两个 token 的组合也不存在于词表中。这意味着,所有在目标词表内进行草稿的方法,都无法直接生成跨词的短语单元。
这个限制并非实现细节,而是分词机制带来的结构性约束。既然短语无法在目标词表中表示,那么要突破这一限制,就必须更换草稿的单元。
BPE(Byte Pair Encoding,字节对编码)是现代大语言模型最常用的子词分词算法。其训练流程大致为:先将语料按空白和标点做预分词(pre-tokenization),把文本切成语素级别的初始单元,再统计相邻单元对的共现频率,反复合并频率最高的一对,直到词表达到预设大小。关键之处在于合并只发生在预分词边界之内——预分词阶段已经用空格把 "United"、"States"、"of"、"America" 切成了独立片段,后续合并规则再怎样学习,也无法跨越这些边界把带空格的整段短语粘合成一个词表条目。因此词表中可能出现 " United"(带前导空格)这类形式,却不会出现 "United States"。这一约束对所有基于 BPE 及其变体(如 WordPiece、Unigram)的分词器同样成立,是子词分词范式的结构性特征,而非某个模型实现上的疏漏。
更换单元:从 token 到短语
研究团队的做法是引入一个独立的草稿词表,其中每个条目对应一个一到三词的短语。一个小型 MLP 头读取冻结目标模型的隐藏状态,直接预测短语条目,再通过贪心最长匹配将短语展开为目标模型自身的 token 序列。N 个候选短语在一次前向传播中、借助前缀树掩码完成验证,因此这一改动与树的深度和宽度正交,不会与现有树状验证方法冲突。
整个过程中,目标模型及其分词器始终保持冻结。候选只有在与目标模型自身的 argmax 匹配时才会被接受,因此最终服务输出与贪心解码完全一致(仅存在浮点平局打破的差异)。这保证了输出质量不受影响,同时获得了速度提升。
前缀树掩码(prefix-tree mask)是树状投机解码中实现并行验证的核心机制。当草稿模型一次性提出多个候选序列时,这些序列往往共享相同的前缀,把它们组织成一棵前缀树可以避免重复计算。验证时,目标模型对所有树节点做一次前向传播,但注意力掩码被设计为只允许每个节点关注其祖先路径上的节点,从而保证每个位置的隐藏状态等价于该路径单独前向的结果。随后按树结构逐层比对目标模型的 argmax 与候选 token,沿最长可接受路径截断,一次性接受多个 token。这里的短语级方案把树的每个节点换成一个短语条目,掩码逻辑不变,因此能与深度、宽度等现有调参维度自由组合。
实测性能:小头大收益
在单张 A5000、batch size 为 1 的条件下,与 HuggingFace generate() 对比,一个 21.94M 参数的草稿头(仅占 Qwen3-4B 的 0.545%)在 GSM8K 上达到 2.391 倍加速,MATH-500 上为 2.444 倍,MT-Bench 上为 1.544 倍。数学类任务上的加速比更高,说明短语级草稿在结构化推理场景中更具优势。
由于草稿头的输出层每个条目仅需一行 257 个参数,草稿词表的大小直接决定了参数预算。一个 8,000 条目的头只有 3.434M 参数,占目标模型的 0.0854%,比 EAGLE-3 的草稿器小 64 倍,同时仍保留了较大头在 GSM8K 上 92.3% 的每轮接受 token 数。这意味着在参数预算极为紧张的场景下,短语级方法依然能提供可观的加速。
与 EAGLE-3 在相同提示和基线上的对比显示,21.94M 的草稿头在两个数学数据集上领先 tree-16,但在所有数据集上落后于 tree-60。这说明短语级方法在中等规模草稿配置下具有竞争力,但在极端追求接受长度的配置下仍有提升空间。
EAGLE-3 是当前最具代表性的投机解码方案之一,它通过特征级草稿(在目标模型隐藏状态层面做自回归预测)和多层特征融合来提升接受率,其草稿器通常包含数十到上百兆参数,并依赖训练阶段的对齐。文中提到的 tree-16 与 tree-60 指验证时候选树的节点规模配置:树越大,单轮可接受的 token 上限越高,但验证前向的计算与显存开销也随之增加。因此"小头落后 tree-60"并不单纯是模型容量问题,而是候选覆盖广度与验证成本之间的权衡——短语级方法用极小的参数预算换取了较高的单位参数收益,但在追求极致接受长度的场景下,其单轮候选空间仍受限于短语词表规模。
意义与局限
这项工作最值得关注的地方在于它跳出了"在目标词表内做草稿"的思维定式。分词器的预分词规则是一个长期被忽视的约束,而短语级草稿直接绕开了它。由于目标模型完全冻结、输出与贪心解码一致,这种方法可以作为一种即插即用的加速层叠加到现有服务栈上,不需要重新训练目标模型。
局限同样明显:目前仅在 batch size 为 1 的场景下验证,尚未涉及批量推理下的表现;与 tree-60 的差距表明,在追求极致接受率时,短语级草稿的候选覆盖可能不如大规模树状草稿。此外,短语词表的构建方式、跨语言和跨领域的泛化能力,原文未做充分讨论。
对于需要在有限显存下部署大模型、又不想牺牲输出确定性的团队来说,短语级投机解码提供了一个值得关注的新方向。它把"单元"这个被当作常量的设计变量重新打开,而这往往正是系统级优化的突破口。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。