对比集替代单一假设:让AI科研智能体从同一证据中解出更多科学问题
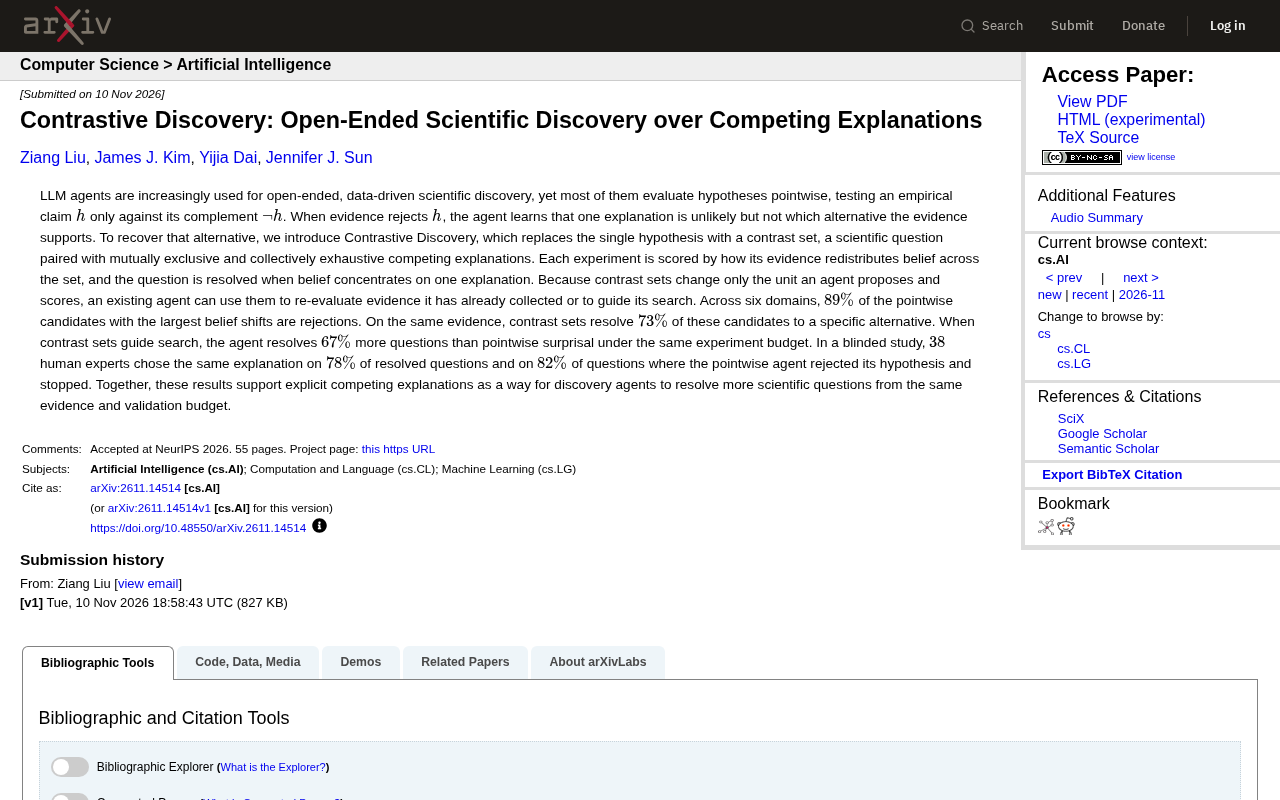
对比式发现用互斥穷尽的解释集合替换单一假设,让LLM科研智能体在否定假设后仍能指向具体替代解释。
文章介绍arXiv新工作Contrastive Discovery,指出当前LLM科研智能体普遍采用逐点式假设评估,只能否定单一假设而无法指出证据支持哪个替代解释,这是结构性盲区。对比式发现将问题单元改为互斥且穷尽的竞争解释集合,并按证据对整组解释的信念重分配幅度为实验打分,而非依赖惊讶度。六个领域实验显示,逐点式认为最有信息量的候选大多是拒绝型,而对比集能把其中大部分归结到具体替代解释。方法不触及底层模型,现有智能体可直接复用,在相同预算下解决更多问题。人类专家盲评显示,对比集判定已解决的问题与专家解释高度一致,包括逐点式智能体已放弃的部分。文章也指出解释集合完整性是落地瓶颈。
大语言模型智能体正被大量投入到开放式、数据驱动的科学发现任务中。但一个被忽视的方法论缺陷正在限制它们的产出:绝大多数智能体采用「逐点式」假设评估——提出一个经验性论断 h,然后用实验去检验 h 与它的补集 ¬h。一旦证据拒绝了 h,智能体只学到「这个解释不太可能」,却不知道证据究竟支持哪一个替代解释。
来自 arXiv 的新工作 Contrastive Discovery(对比式发现) 直接指向这个问题:把单一假设替换为「对比集」(contrast set),即一个科学问题搭配一组互斥且穷尽的竞争性解释。每个实验按其对整组解释的信念重分配程度打分,当信念集中到某一个解释上时,问题即被认为得到解答。
逐点假设的结构性盲区
逐点式评估的吸引力在于简单:一个假设、一个否定、一个统计检验。但它丢失了科学推理中真正有价值的信息——证据的区分力。
当 p 值不显著或证据与预测相悖时,智能体的推理链条就在这里终止。它无法回答「那么是哪一个」这个科学家真正关心的问题。作者指出,这种设定下的智能体在拒绝假设后往往直接停止,把一次本可以继续收敛的实验浪费掉了。
对比集的设计改变了这个单元:不再是「h 还是 ¬h」,而是「A、B、C 三者中哪一个」。这要求研究者在提问阶段就枚举出互斥且穷尽的解释集合,看似增加了人工成本,但它把智能体的每一次实验都锚定在一个可收敛的目标上。
互斥且穷尽(mutually exclusive and exhaustive)是构建对比集的两个核心约束。互斥指任意两个解释不能同时为真,例如「酶活性下降源于抑制剂结合」与「源于转录水平下调」在机制上不能并存;穷尽则要求候选解释覆盖所有可能的真实原因,至少不遗漏主要竞争项。这两个条件共同保证了信念重分配可以被度量:如果解释集合不互斥,概率质量会在重叠的解释间模糊流动;如果不穷尽,真实解释可能根本不在集合中,智能体的收敛会指向错误方向。在统计假设检验的语境下,逐点式的 h 与 ¬h 天然构成一个最简单的二元对比集,但 ¬h 是一个笼统的补集而非具体机制,因此它无法提供「哪一个替换 h」的信息。
实验评分从「惊讶度」转向「信念重分配」
方法层面最关键的改动在打分函数。逐点式智能体通常用惊讶度(surprisal)来挑选下一个实验:哪个结果最出乎意料就做哪个。对比集则按证据对整组解释的信念重分配幅度来评分,优先选择那些能把概率质量在不同解释之间显著搬移的实验。
据论文报告,在六个领域的实验中,逐点式候选里信念偏移最大的那一批,绝大多数属于「拒绝」类型——也就是说,逐点智能体认为最有信息量的实验,实际上往往只是推翻了原假设,而没有指向任何具体替代方案。
同样的证据交给对比集处理时,其中大部分候选能够被归结到一个具体的替代解释上。这个对比说明:被逐点式框架丢弃的证据并非没有区分力,而是缺少一个能承接这种区分力的表示结构。
惊讶度(surprisal)在信息论中定义为 −log p(x),即观测到结果 x 时概率越小、惊讶度越高。逐点式智能体据此挑选「最出乎意料」的实验,直觉上这能最大化信息增益,但这一直觉隐含了一个假设:惊讶度高的结果对应着对假设空间的有效排除。问题在于,二元假设空间下高惊讶度几乎等价于「否定 h」,而否定本身并不携带方向性信息。对比集下的信念重分配则不同:它度量的是实验前后概率分布在整组解释上的移动幅度,例如用 KL 散度或熵减来衡量。一个实验如果只把概率从 h 移向 ¬h 的某个笼统补集,在对比集评分下得分很低;只有当证据把质量从解释 A 明显搬到解释 B 或 C 上时,才被认定为高信息量。这正是两种评分策略产生分歧的根源。
兼容现有智能体,无需重新训练
对比集的一个实用优势是它只改变智能体「提出什么」和「如何评分」这两个环节,不触及底层模型能力。这意味着已有的发现智能体可以直接复用:
- 回溯已收集的证据:把历史实验结果重新放进对比集框架,看它们能否支持某个具体解释
- 指导后续搜索:在实验预算受限时,优先做那些能在竞争解释之间拉开差距的实验
在相同实验预算下,由对比集引导搜索的智能体解决的科学问题数量显著多于逐点式惊讶度策略。这一增益不来自更多实验或更强模型,而纯粹来自问题表示方式的改变。
人类专家盲评给出的信号
论文做了一项盲测:让人类专家在已解决的问题上独立选择解释。在对比集判定为已解决的那些问题上,专家选择与智能体一致的比例相当高;更你可能没注意到,在逐点式智能体已经拒绝假设并停止的那批问题上,专家仍然能给出明确解释,且与对比集框架的结论高度吻合。
这构成了一个双向验证:一方面说明对比集的收敛结果具备领域可接受性,另一方面也揭示出逐点式智能体在拒绝假设时放弃了多少本可以继续推进的空间。不过需要说明,这里的一致率来自该论文的单一实验设置,不同学科的专家共识难度差异较大,结论的普适性仍需更多领域的独立复现。
盲评(blind evaluation)在此处指专家在不知道智能体结论的前提下独立判断每个问题最可能的解释,从而避免确认偏差。这种评估方式在自动化科研领域逐渐成为标配,因为它能区分「智能体自认为解决」与「领域内可接受」。需要注意的是,专家一致率高并不等同于解释正确,它只说明结论落在领域共识的可接受范围内。此外,涉及专家标注的研究通常样本量有限,不同学科的解释空间复杂度差异很大——例如分子机制类问题往往有较清晰的候选机制集,而生态或社会科学问题的解释边界模糊得多。因此论文中报告的一致率应被理解为该方法在其选定领域内的可行性证据,而非跨领域的普适保证。
对AI科研工具设计的启示
这项工作的价值不止于一个方法改进,它提示了一个更普遍的设计原则:智能体的推理能力受限于它被要求回答的问题形式。
当前的自动化科研流水线大多沿用统计假设检验的脚手架,这在可复现性和严谨性上有优势,但也在结构上把「发现替代解释」这件事排除在外。对比集提供了一条低成本路径——不换模型、不加预算,只换提问方式。
落地时的现实约束同样明显:构造互斥且穷尽的解释集合需要领域知识,对于解释空间本身尚不清晰的开放问题,这一步可能就是瓶颈。论文的六个领域实验尚不能回答这个问题,如何在解释集合不完整时保持框架的鲁棒性,会是后续研究的关键方向。
常见问题
对比集与传统假设检验冲突吗? 不冲突。对比集是在假设检验之上增加的一层表示,逐点检验仍可作为筛选手段,对比集负责在拒绝之后继续推进。
需要为每个问题手工列出所有解释吗? 论文强调互斥且穷尽,实践中可以先用智能体生成候选解释再由研究者审核,但完整性问题仍是开放挑战。
这套方法对实验预算敏感吗? 论文报告的增益是在相同实验预算下测得的,说明它提升的是单位实验的信息效率,而非依赖更多实验。
相关推荐

美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
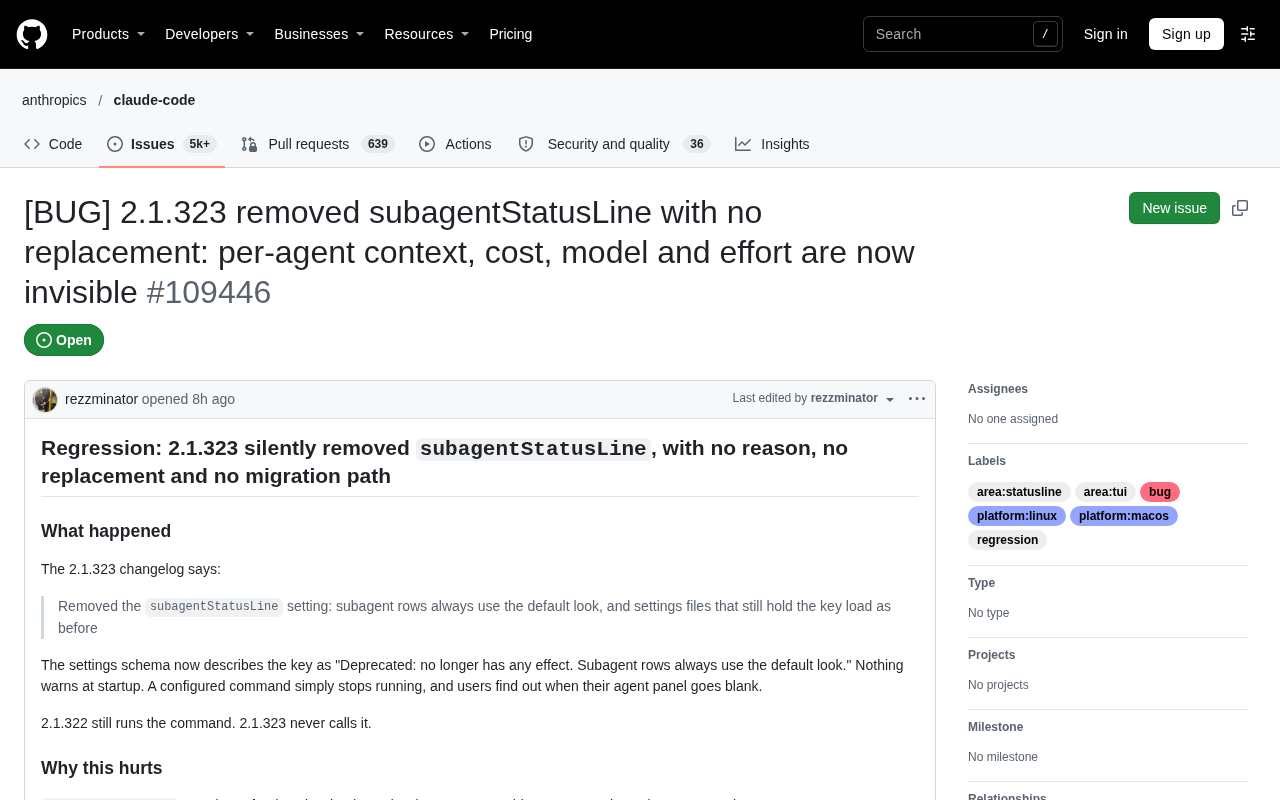
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
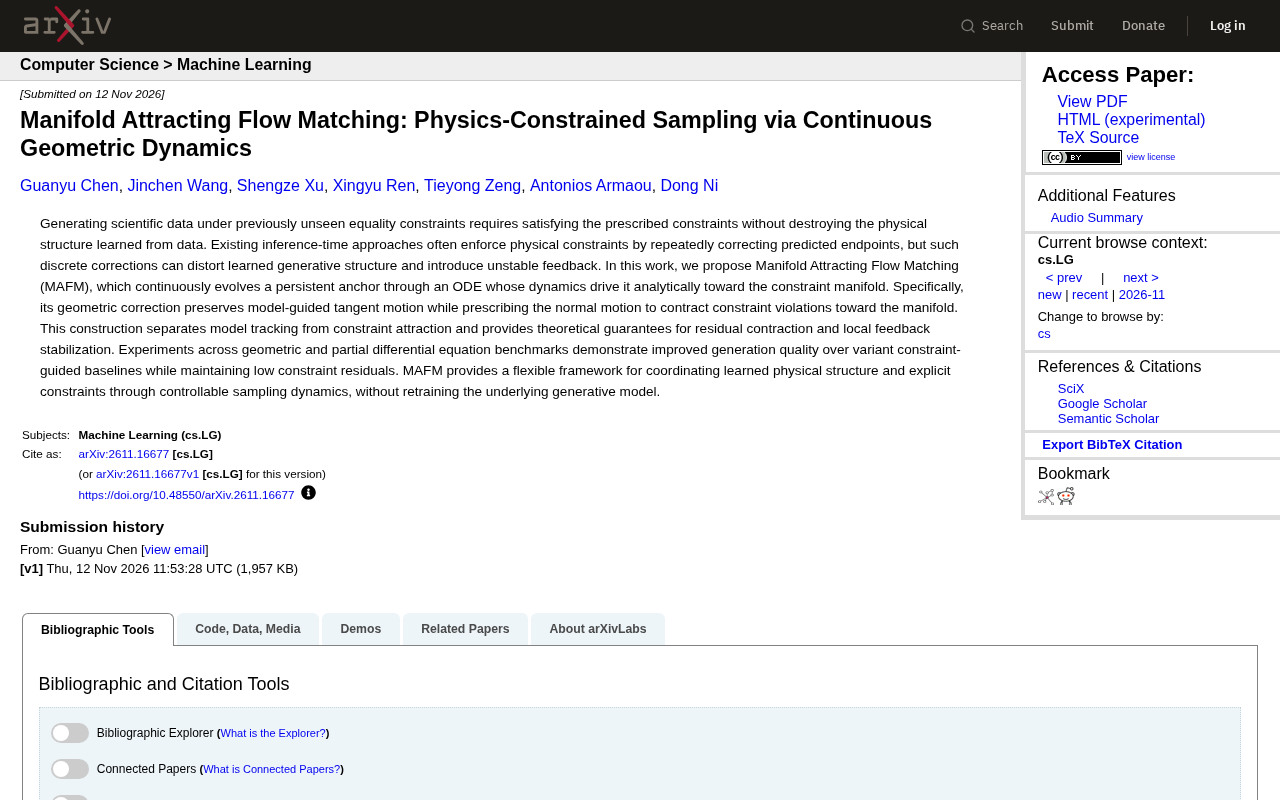
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。