对话式AI的真实瓶颈:模型能力还是训练数据质量?

AI在实验室很聪明,在现实却很笨拙
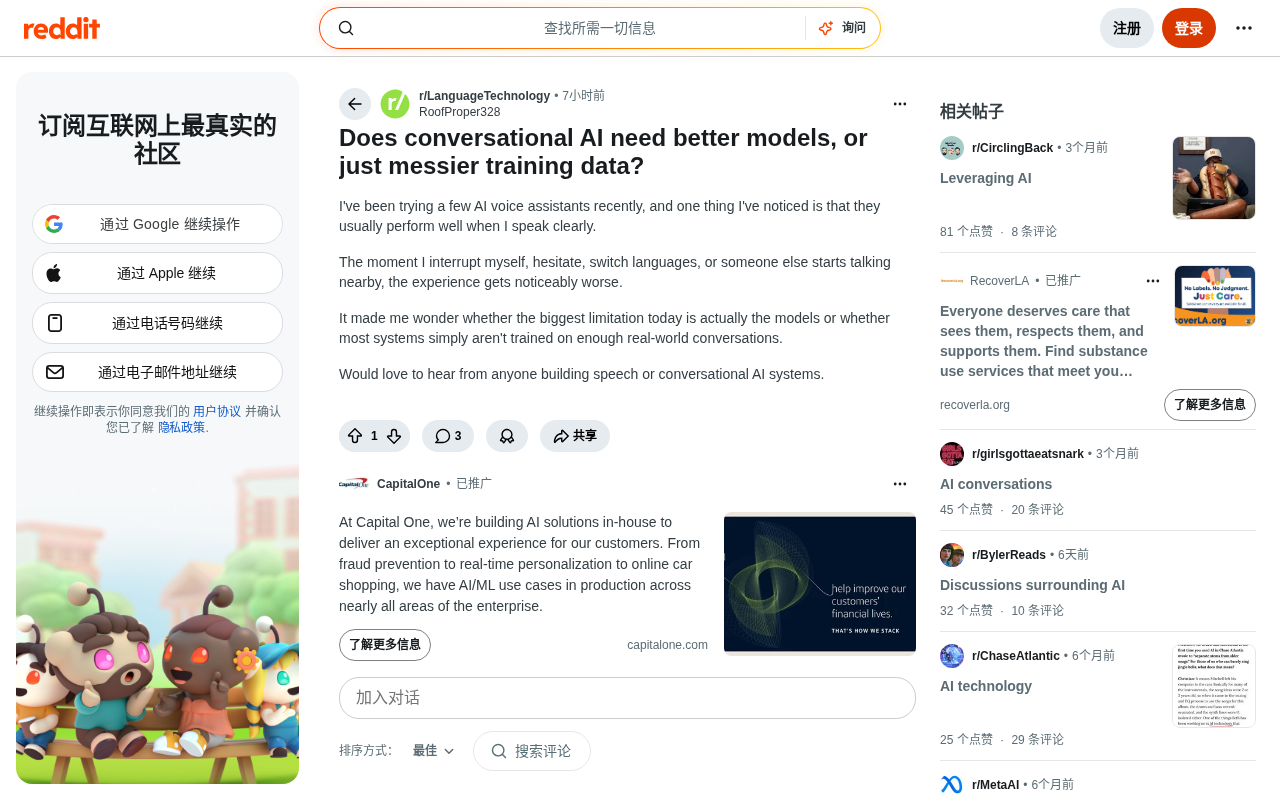
最近在 Reddit 上,一位开发者提出了一个直击行业痛点的问题:对话式 AI 到底需要更好的模型,还是仅仅需要更「混乱」的训练数据?
他分享了自己使用多款 AI 语音助手的体验:当他清晰、缓慢地说话时,这些系统表现得相当出色;但只要他中途打断自己、犹豫停顿、切换语言,或是旁边有人开始说话,整个交互体验就会明显下降。这个观察看似简单,却揭示了当前对话式 AI 落地应用中最核心的矛盾。
这个问题之所以值得深挖,是因为它触及了 AI 系统「纸面能力」与「真实世界能力」之间的巨大鸿沟。在标准化测试集上,今天的语音识别和对话模型准确率已经逼近甚至超越人类;但一旦进入嘈杂、随意、非理想化的真实对话场景,性能就会断崖式下跌。
现实对话的「混乱」远超训练数据
人类对话本身就是不完美的
真实的人类对话充满了机器难以处理的「噪声」:
- 自我打断与重启:「我想要——不,等等,其实我想要的是……」
- 填充词与犹豫:「嗯……那个……你知道的」
- 语言混用:在多语言环境中,人们常常在一句话里切换两三种语言
- 重叠说话:多人同时开口,背景对话交织
- 不完整句子:说到一半突然改变主意
这些现象在日常对话中无处不在,但在大多数训练数据集里却被系统性地「清洗」掉了。研究者和工程师往往倾向于使用干净、标注良好、结构完整的语料来训练模型,因为这样更容易获得漂亮的评测指标。
值得注意的是,文中提到的「语言混用」在语言学上有专门术语:代码切换(Code-Switching),指双语或多语者在单次对话中流畅切换两种或多种语言的现象,在东南亚、南亚、非洲及海外华人社区极为普遍。例如新加坡的「Singlish」中英夹杂,印度的 Hinglish(Hindi+English)均是典型案例。代码切换对 ASR 系统构成根本性挑战:传统单语声学模型无法处理音素层面的语言切换,而语言模型的词表和语法假设也会在切换边界处失效。目前主流应对方案包括:训练多语言联合模型(如 OpenAI Whisper 支持99种语言)、专门构建代码切换语料库(如 SEAME 数据集),以及通过语言识别模块动态切换解码策略。
数据「洁癖」造就了脆弱的模型
问题恰恰出在这里。当模型主要在「理想化」的干净数据上训练时,它学到的是一个被过度简化的世界。一旦遇到训练分布之外的真实混乱,模型的泛化能力便会急剧衰减。这就是为什么那位 Reddit 用户会发现——只要他不「配合」系统,体验就会立刻崩塌。
这一现象在机器学习领域有专业术语:分布偏移(Distribution Shift)。当模型的训练数据分布与实际部署环境的数据分布存在显著差异时,模型性能会系统性下降。对话式 AI 领域的分布偏移尤为严峻:主流语音识别训练集(如 LibriSpeech、CommonVoice)大多来自朗读录音或受控环境,信噪比高、语速均匀、句子完整;而真实部署场景中的**自发语音(Spontaneous Speech)**在语言学特征上与朗读语音有本质区别——自发语音充满非流利性标记(Disfluency),包括填充停顿、自我修正、句子碎片等,这些特征在现有主流训练集中严重欠表达。
换句话说,很多时候不是模型不够聪明,而是它从未见过真正的现实。
模型 vs 数据:这可能是个伪命题
两者深度耦合,难以割裂
将问题框定为「要么改进模型,要么改进数据」本身可能就是一种误导。这两个维度深度耦合,相互制约:
支持「数据是瓶颈」的观点认为:现代大模型的架构已经足够强大,Transformer 及其变体在容量上远未饱和。真正限制它们的是没有见过足够多样、足够混乱的真实对话样本。纳入更多包含打断、犹豫、多语言、重叠语音的数据,性能自然会提升。
支持「模型是瓶颈」的观点则认为:即便有了混乱的数据,当前模型架构在处理实时推理、上下文记忆、说话人分离、意图理解等方面仍有根本性局限。例如,实时打断处理需要低延迟的流式推理能力——这正是标准 Transformer 架构的固有短板。标准 Transformer 的 Self-Attention 机制需要对整个输入序列做全局计算,天然不适合「边输入边处理」的流式场景。为此,业界发展出了多种变体方案:流式 Transformer 通过滑动窗口限制注意力范围;Mamba 等基于**状态空间模型(SSM)**的架构则以线性复杂度实现序列建模,更适合实时推理;端到端的语音语言模型(Speech LLM)则尝试绕过 ASR+NLU 的串联管线,直接从音频特征建模语义,从架构层面缩短延迟链路。这更多是架构和工程问题,而非单纯的数据问题。
更可能的答案:系统级管线问题
对话式 AI 的挑战往往不出在单一环节,而是一个系统级的管线问题。一个完整的语音助手通常包含:
- 语音活动检测(VAD):判断谁在说话、何时说话
- 自动语音识别(ASR):将语音转为文本
- 说话人分离:区分多个声源
- 自然语言理解(NLU):理解用户意图
- 对话管理:维护上下文与状态
- 语音合成(TTS):生成回应
其中,「说话人分离(Speaker Diarization)」是多人对话场景中的关键难题,其任务是回答「谁在什么时间说了什么」。现代说话人分离系统通常结合**声纹嵌入(Speaker Embedding,如 d-vector、x-vector)**与聚类算法,将音频流切分并标注到不同说话人。然而在实际场景中,说话人重叠(Overlap)区段往往导致分离精度大幅下降——而人类对话中重叠比例可高达20%以上。近年来,端到端神经网络分离方案(如 EEND)开始将分离与识别联合优化,但在超过4人同时发言的场景中仍面临显著挑战,这也是多人会议转录产品体验参差不齐的根本原因之一。
任何一个环节在真实场景下失效,整体体验就会崩溃。用户感知到的「AI 变笨了」,很可能只是 VAD 在嘈杂环境下误判,或是 ASR 在语言切换时出错,与核心语言模型的智能水平并无直接关联。
给开发者的实践建议
主动拥抱「脏数据」
对于正在构建语音或对话系统的团队,这个讨论指向了明确的方向:不要过度清洗训练数据。有意识地纳入真实世界的混乱样本——包含背景噪声、多人对话、口误、语言混用的语料,能显著提升模型在部署环境中的鲁棒性。
端到端评测比单点指标更重要
不要只盯着 ASR 字错率(WER)这类单点指标。**字错率(Word Error Rate,WER)**的计算方式为(替换错误+删除错误+插入错误)/参考词总数,但它存在明显局限:对所有词一视同仁,无法区分关键词错误与语气词错误的影响差异;更重要的是,WER 与用户真实满意度的相关性在嘈杂场景下会显著下降——有研究表明,在自发语音场景下 WER 从5%提升到8%,用户感知的任务完成率可能下降超过30%。这促使业界转向「语义错误率(SER)」「任务完成率(Task Completion Rate)」等更贴近用户体验的评测维度。应在真实、嘈杂、非合作式的场景下做端到端评测,重点衡量用户真正关心的「任务完成率」与「交互流畅度」。
流式与实时能力是核心差异化
支持随时打断、动态插话的能力,正在成为高质量语音助手的分水岭。这既需要模型层面的流式推理支持,也需要对话管理层面的动态状态更新——模型能力与系统工程必须协同进化。
结语:不是二选一,而是全面升级
回到最初的问题:对话式 AI 需要更好的模型,还是更混乱的训练数据?答案很可能是——两者都需要,而且还需要更扎实的系统工程。
当前对话式 AI 最大的短板,恰恰在于它被优化去应对一个不存在的、过于整洁的世界。要让 AI 真正融入人们杂乱、随性、真实的日常对话,行业需要放下对「干净指标」的执念,转而拥抱现实的复杂性。谁能率先在混乱中保持稳定,谁就能赢得下一代语音交互的用户。
核心要点
相关推荐

n8n实战全教程:从零构建可扩展的AI自动化系统
n8n实战全教程详解:从基础概念到AI Agent、知识库、记忆系统、多Agent协作,再到事件驱动、人机协同与生产级监控,系统掌握可扩展AI自动化工作流的构建方法。

当AI一天解出372道数学难题:数学家为何愤怒而非欢呼
OpenAI 的大语言模型一天解出 372 个开放数学问题,陶哲轩等数学家却集体抵制。本文解析数学家愤怒背后的两大理由、装箱问题与整数乘法下界的争议,以及AI对数学与软件工程人才培养的深远冲击。

决策模型对决LLM:4.8倍速度、7.4倍成本的实测启示
开发者在1000条真实招聘数据上实测决策模型(Jev)与大模型(Gemini):速度快4.8倍、成本低7.4倍、准确率仅差1.6个百分点。最优解并非替换LLM,而是决策模型加置信度检查再由LLM兜底的分层架构。