对抗长视频画质退化:H3一镜到底的双阶段精修实验
开发者基于H3模型提出双阶段潜空间精修方案,试图缓解长视频生成中的持续画质退化问题。
一位开发者在Stable Diffusion社区分享了针对长视频生成画质退化问题的实验性方案:在H3模型的「一镜到底」工作流中新增第二精修阶段,通过向潜空间注入噪声与干净条件信息、再将结果混合回原始latent,来阻断误差随时间累积放大的过程。测试在极低质量参数(10步基础采样+4步精修)下生成了10段共约80秒的视频,结果显示精修阶段确实改善了退化,但对比度衰减与背景溶解问题仍未根除。作者坦率说明了方案局限,并向社区公开征集tapered noise、selfLift等技术方向的验证意见,体现了开源生态中务实的协作探索精神。
在长时长 AI 视频生成领域,画质退化(degradation)始终是个绕不开的难题。一位 Reddit 用户在 r/StableDiffusion 社区分享了他对抗这一问题的最新实验——基于 H3 模型的「一镜到底、无剪辑」(One-Shot-No-Cuts)方案。这不是一套花哨的导演级工具,而是一个用最少节点搭建的朴素工作流,核心目标只有一个:让长视频在连续生成中尽量不「越跑越糊」。
长视频生成的退化困境
所谓画质退化,指的是在生成较长视频序列时,随着时间推移,画面质量逐渐劣化的现象。对比度失衡、细节丢失、背景出现诡异的溶解(dissolve)效果,都是典型症状。这种问题在依赖运动上下文(motion-context)连续推理的长视频生成中尤为明显——每一段都在前一段的基础上延续,误差会不断累积放大。
作者坦言自己「还在和退化问题死磕」,并明确表示这套方案「有明显的局限和缺点」。他没有把它包装成一个成熟的 AIO(All-In-One)工具,而是以工作流(Workflow)的思路,验证一种可行的缓解手段。这种务实的态度,恰恰是社区技术探索最真实的样貌。
从技术根源来看,退化问题与自回归式视频生成的「上下文传递机制」密切相关。以 H3 等基于扩散模型的视频生成架构为例,生成长视频时通常采用滑动窗口或分段续接的方式:每一段新视频以前一段末尾的若干帧(或其潜空间表示)作为运动上下文(motion-context)输入,模型在此基础上推断后续画面。这种设计虽保证了时序连贯性,却也导致误差像滚雪球一样累积——每次采样引入的微小偏差会被下一段「继承」并放大。对比度偏移是最早显现的症状之一,因为扩散模型在多次迭代后倾向于向训练数据的均值回归,导致高光压缩、暗部抬升;而背景区域因运动幅度小、被反复渲染,更容易出现像素级的「溶解」模糊。这与传统视频编解码中的「漂移误差」(drift error)现象在机制上有一定类比性。
核心思路:第二阶段精修注入
方案的技术核心在于新增一个「精修阶段」(refinement stage)。具体做法是:向潜空间(latent space)注入噪声与干净的条件信息(clean conditioning),以此阻止画面持续恶化,再将处理后的结果混合(blend)回原始 latent。
简单理解,就是在原生运动上下文生成的基础上,叠加一次「纠偏」采样。作者的测试对比很直观:左侧是纯原生 motion-context 的输出,右侧是加入 refine sample 后的结果。从他的描述看,精修后的画面在退化控制上确实有所改善,但问题并未根除——「对比度依然会随时间变差,这正是我现在要对付的东西」,同时背景中仍会出现奇怪的溶解现象。
「潜空间(latent space)注入噪声」这一操作背后,借鉴的是扩散模型中的 SDEdit 思想:对已有的干净 latent 加入受控量的高斯噪声,再以较少的去噪步数重新采样,从而在保留整体结构的前提下「刷新」细节。加入干净条件信息(clean conditioning)则起到锚定作用——向模型提供当前期望的画面状态,防止重采样时偏离太远。最终将精修结果与原始 latent 按权重混合(blend),是一种在「保真度」与「纠偏力度」之间取得平衡的常见做法:混合比例越高,纠偏越强,但也越容易破坏前后帧的运动连贯性。这套逻辑与图像领域的 img2img 精修流程高度相似,只是被扩展到了时序维度,需要额外考量帧间一致性的代价。
测试参数与真实局限
这次测试的配置颇具参考价值:使用 1 张角色参考图配合 ref2va,生成 10 段、每段 8 秒的视频(合计约 80 秒),采样步数刻意压低——基础 10 步 + 精修 4 步。作者特意强调这是「相当低质量」的设定,目的是在极端条件下暴露退化问题,而非追求最终成片效果。他也提醒观众忽略视频内容本身与「完全煮糊了」的音频,只聚焦技术议题。
这种低步数、长时长的压力测试思路值得肯定。在最苛刻的参数下都能观察到改善,说明方法本身具备一定普适性;而残留的对比度衰减和背景溶解,则清晰界定了当前方案的边界。
社区智慧:还有哪些方向可试
作者自谦「不是专家」,但提到听说 tapered noise(渐变噪声)和 selfLift 等技术可能对缓解退化有帮助,只是尚未有时间深入研究,并公开向社区征集更好的思路。这种开放协作的姿态,正是开源生成式 AI 社区持续进步的动力。
值得一提的是,他还引用了一段 SeeDance 2.5 的「长一镜到底」视频作为参照,并表达了信心:「我相信用 H3 也能做到这样。」这透露出一个更大的行业趋势——长时长、无剪辑、高连贯性的 AI 视频生成,正成为各家模型竞相攻克的下一个高地。
作者提及的 tapered noise(渐变噪声)是一种在视频续接时对运动上下文帧施加「递减噪声」的策略:越靠近当前生成窗口的历史帧,添加的噪声越少,以此保持近端连贯性;而较早的帧则允许更大幅度的噪声扰动,减少远端误差的持续影响。这与课程学习(curriculum learning)中「由难到易」的渐进思路有异曲同工之处。selfLift 则是社区中流传的一种自举式精修技巧,核心是用当前生成结果的局部统计特性(如亮度均值、对比度分布)来动态调整采样参数,相当于让模型以自身输出为参照进行自我校正,无需额外的参考图或人工干预。两者均属于无需修改模型权重、仅在推理阶段介入的「即插即用」方案,这也是开源社区探索此类技巧的主要动力。
写在最后
这篇实验记录的价值,不在于它给出了完美答案,而在于它诚实地展示了一个真实的技术攻坚过程:明确的问题定义、可复现的方法思路、坦率的局限说明,以及开放的求助姿态。对于关注 AI 视频生成、尤其是长视频连贯性问题的开发者而言,双阶段精修注入的思路提供了一个值得动手验证的起点。感兴趣的读者可以查阅作者早前的帖子及评论区,获取工作流的更多细节。
相关推荐
Cursor性价比实测:20美元套餐送云端电脑与海量额度
一位B站UP主实测Cursor性价比:20美元套餐附赠128GB云端电脑,内置模型额度耐用、每周刷新,但外部模型消耗极快。本文客观分析其功能亮点与需谨慎看待之处。
Grok Bot上手实测:把AI智能体变成你的员工团队
xAI推出的Grok Bot以即时通讯式界面让用户像管理员工一样使用AI智能体。本文基于B站UP主实测,解析其对话式配置、云端虚拟电脑、多机器人协作等核心功能,以及每月300美元的使用门槛。
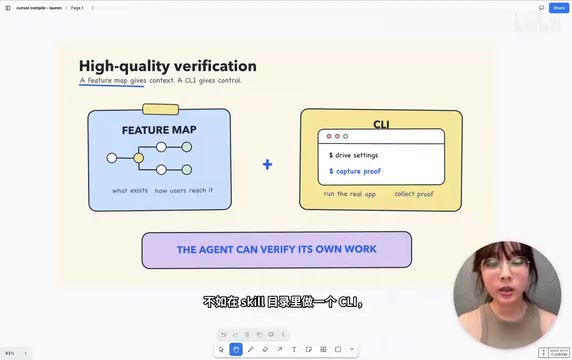
Cursor大神实战:如何用Grok Bot一月合入2000个PR
SpaceX AI 的 GrokBot 工程师 Poteto 分享如何一个月合入 2000 个 PR:通过验证技能、Agent 友好框架 DUNE、信任阶梯与 GrokBot 外循环,构建可信任的 AI Agent 工作流。