对抗推测推理:让长周期智能体更可靠的解码新思路

推测解码在长周期智能体中会因验证噪声改变推理轨迹,可通过训练草稿模型主动被拒绝来提升精度。
文章重新审视推测解码的定位:它并非中性的加速技术。在长周期智能体任务中,验证窗口内的数值噪声会随推理步数累积,约30步后可能改变目标模型的输出分布,使推理走向不同方向,因此单纯优化草稿接受率并不足以保障成功率。研究者提出对抗推测推理:识别关键推理决策点,训练草稿模型在这些点上形成对抗性偏好、主动触发拒绝,让关键 token 由目标模型在低噪声条件下重新采样。该方法不改动目标模型,仅训练占托管参数0.06%至0.28%的草稿模型,在智能体编程基准上提升了端到端成功率,把推测解码从加速器转变为上下文精度的主动分配器。
从“加速器”到“精度分配器”:重新理解推测解码
推测解码(Speculative Decoding)长期以来被视为一种纯系统层面的优化技术:通过一个更小、更快的草稿模型(draft model)预先猜测多个 token,再由目标模型(target model)一次性并行验证,从而在不改变输出分布的前提下加速大模型解码。围绕这项技术的研究,几乎都聚焦于一个指标——草稿接受率(acceptance rate)。
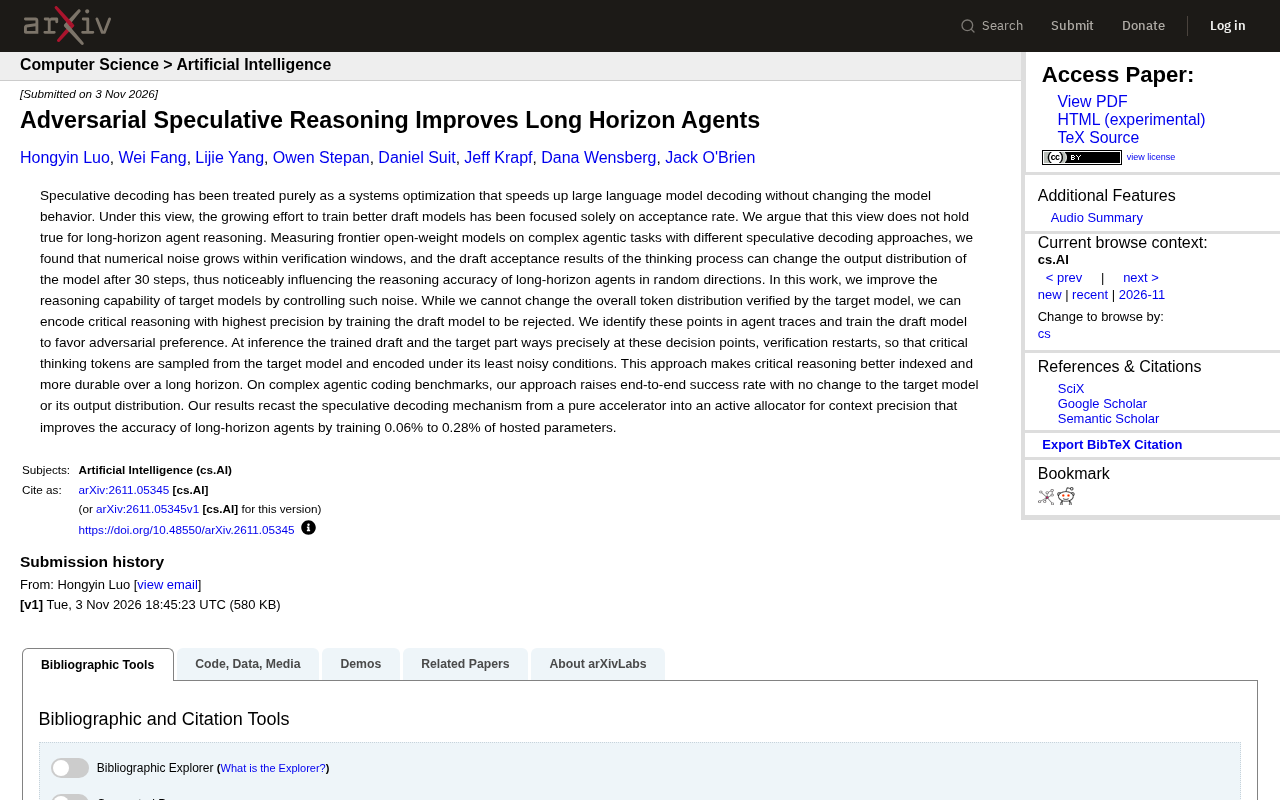
但一项来自 RSS 的研究提出了不同看法:在长周期智能体(long-horizon agent)的复杂推理任务上,这种“加速器”视角并不成立。研究者测量了前沿开源权重模型在不同推测解码方案下的表现,发现数值噪声会在验证窗口内累积,思考过程的草稿接受结果可能在 30 步之后改变模型的输出分布,从而以随机方向显著影响长周期智能体的推理准确率。
这意味着,推测解码不只是快慢问题,它实际上在悄悄重塑模型的推理轨迹。
草稿接受率(acceptance rate) 是推测解码的核心度量,指草稿模型生成的候选 token 中被目标模型验证通过的比例。在标准推测解码中,目标模型对候选序列做并行校验,接受则保留、拒绝则从修正后的分布重新采样,理论上保证输出分布与目标模型单独解码一致。接受率越高,单位时间内被“免费”验证的 token 越多,加速比越大。因此早期研究多以提高接受率为目标,例如让草稿模型与目标模型分布更接近、采用多草稿模型或树状候选结构。但接受率只刻画“有多少 token 被接受”,并不刻画“哪些 token 被接受”以及验证过程中数值误差如何影响后续采样,这正是它在长周期推理场景下暴露局限的原因。
验证窗口内的噪声如何“带偏”长周期推理
要理解这个问题,需要先看清推测解码的机制细节。在标准的推测解码流程中,草稿模型连续生成若干 token,形成候选序列,目标模型随后在一个验证窗口内并行校验这些候选。理想情况下,验证会完全接受或拒绝整段候选,输出分布保持不变。
然而研究指出,在长周期智能体任务中,验证窗口内的数值噪声会逐步增长。当推理链条拉长到几十步之后,这种噪声不再可以忽略:草稿接受的结果会在不经意间改变目标模型的输出分布。对于一个需要连续做出数十次决策的智能体来说,任何一步的微小偏移都可能被后续步骤放大,最终让推理走向截然不同的方向。
这也是为什么传统的接受率优化思路在智能体场景下失效——接受率再高,如果关键推理步骤在验证窗口内被“噪声化”,长周期的整体成功率依然会受损。
验证窗口(verification window) 指推测解码中目标模型一次性并行校验的候选 token 区间,其长度通常由草稿步数决定。窗口内目标模型对每个位置计算条件概率并与草稿分布比较,按接受-拒绝规则决定保留哪些 token。由于浮点运算顺序、批处理归约和并行计算的非确定性,窗口内各位置的 logits 会带有微小数值噪声;当窗口较长或模型较大时,这种噪声可能改变接受/拒绝的边界判定,使实际采样分布与理论分布产生偏差。在单轮生成中该偏差通常可忽略,但在需要连续数十步决策的智能体任务中,它会沿推理链累积并被放大。
反其道而行:训练草稿模型“被拒绝”
研究团队给出的解法颇有逆向思维的味道:既然无法改变目标模型所验证的总体 token 分布,那就换一个角度——通过训练草稿模型,让它在关键推理节点上主动“被拒绝”。
具体做法是,先在智能体的推理轨迹中识别出那些对结果至关重要的决策点,然后训练草稿模型形成对抗性偏好(adversarial preference):在这些关键点上,草稿模型的输出会与目标模型产生分歧,从而触发验证重启。这样一来,关键思维 token 就由目标模型在噪声最小的条件下重新采样和编码,而不是被草稿模型的猜测“带过”。
用研究者的话说,这种方法让关键推理“被更好地索引,并在长周期中更持久”。它不是去追求更高的接受率,而是把推测解码机制变成了一个上下文精度的主动分配器。
对抗性偏好(adversarial preference) 在这里指一种训练目标:让草稿模型在关键决策点上的输出分布刻意偏离目标模型,从而更容易触发验证拒绝与重采样。常规偏好优化让草稿模型靠近目标模型以提高接受率,而对抗性偏好反其道而行,把“被拒绝”当作信号,使关键位置的 token 交由目标模型在噪声更小的条件下重新生成。实现上通常需要先定位关键推理节点(如涉及中间结论、工具调用参数或分支判断的 token),再构造偏好对进行训练。其代价是整体接受率下降、解码变慢,但换来的是关键上下文由目标模型高精度编码。
不改目标模型,端到端成功率提升
这种对抗推测推理方法的一个关键优势是:目标模型本身及其输出分布完全不需要改动。所有改动都集中在草稿模型的训练上,且训练参数量仅占托管参数的 0.06% 到 0.28%。
在复杂的智能体编程基准上,该方法提升了端到端成功率。这一点值得关注,因为它意味着团队找到了一条“以小博大”的路径——不需要重新训练或微调大模型,只靠一个极小的草稿模型,就能改善长周期智能体的推理准确性。
对于实际部署智能体的团队来说,这提供了一种成本可控的优化选项:与其等待更大更强的目标模型,不如重新审视草稿模型的训练目标,把接受率之外的因素纳入优化范畴。
托管参数(hosted parameters) 指部署时由服务方托管、推理时实际加载的目标模型参数。研究中“训练参数量仅占托管参数的 0.06% 到 0.28%”意味着只训练一个极小的草稿模型或适配模块,而不触碰目标模型权重。这使得方法可以即插即用地应用于现有开源权重模型:目标模型及其输出分布保持不变,部署方只需替换或附加草稿模型,训练与存储成本都远低于全量微调。不过,草稿模型仍需与目标模型的 tokenizer 和词表对齐,且其对抗性偏好需要针对具体任务分布重新训练,泛化性取决于关键决策点识别的准确性。
对智能体工程的启示
这项研究带来的启示不止于推测解码本身。它提醒我们,长周期智能体的可靠性是一个系统工程问题,解码层面的细节同样会影响最终结果。当智能体需要连续执行数十步甚至更多决策时,推理链路中的每一个环节——包括看似中性的解码加速技术——都可能成为误差来源。
另一个值得思考的方向是“精度分配”:不是所有 token 都同等重要,关键决策点值得用更高的精度、更少的噪声来处理。对抗推测推理正是这一思路的具体实现,它把算力从“均匀加速”转向“关键处精细采样”。
当然,这一方法目前仍局限于特定基准上的验证,其在更广泛智能体任务中的通用性还有待观察。但它至少打开了一个新的问题空间:推测解码的参数,除了接受率,还有哪些值得优化的维度?
相关推荐

B站爆款Pi Agent实战课:零基础搭建智能体全解析
深度解析B站Pi Agent实战课:梳理Pi Agent从早期积累到加速增长的四阶段发展脉络,探讨其与Claude Code、Codex等AI编程工具的差异化定位,零基础学习智能体开发的核心要点。

Vibe Coding零基础入门:AI开发全链路实战指南
B站80集Vibe Coding零基础教程解析:从指挥AI写代码到全链路产品落地,涵盖需求分析、UI设计、前后端开发、数据库、测试部署及AI自动化运营,助你掌握一人公司所需的全栈AI开发能力。

B站保姆级Codex攻略:从安装到实战,一期精通
B站保姆级Codex攻略全解析:从GPT账号注册、桌面端安装、登录验证与网络报错修复,到.env文件解决重新连接5次、PLUS额度机制与Pro升级,附实战使用心法。