多Agent上下文传递:面试官必问的有损压缩问题

多Agent系统的核心难题是上下文传递,而非单个Agent能力。
文章围绕多Agent系统中上下文传递这一高频面试题展开。伯克利分析1600多条真实轨迹发现,近四成失败源于Agent间信息没对齐而非单个Agent能力不足。文章按token成本从高到低梳理四种策略:全量传递、结构化brief、共享黑板、消息传递加无状态子Agent,并指出结构化brief是多数生产系统的默认选择。随后提炼出“外置、精选、压缩、隔离”四字原则,给出摘要应包含的七个字段清单,强调写摘要时应站在“下一个Agent需要什么”的视角。最后总结三个反模式:无脑转发完整历史、散文式交接无schema、线性流程硬拆多Agent。
多Agent系统正成为大模型应用的热点,但很多开发者在面试中栽在上下文传递问题上。B站UP主彭宇的系统课程中,专门拆解了这道高频硬题:多Agent之间如何传递上下文?这篇文章将带你理解背后的工程逻辑。
为什么多Agent上下文传递是核心难题
在多Agent系统中,每个Agent都有自己的上下文窗口,当任务需要在多个Agent之间流转时,上下文如何传递就成了关键。彭宇指出,很多人第一反应是把完整历史一股脑塞给下一个Agent,但这恰恰是问题的开始。
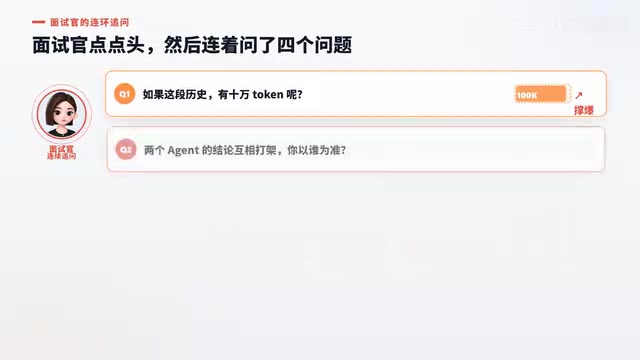
加州伯克利分析过1600多条真实执行轨迹,发现接近四成的失败并非单个Agent能力不足,而是Agent之间信息没对齐——交接时信息丢失,或者各方抱着互相矛盾的假设继续执行。这个数据说明,单个Agent好不好造是次要问题,上下文怎么在它们之间流动才是主问题。
上下文窗口(Context Window) 是大模型单次推理能处理的最大 token 数量,包括输入 prompt 与已生成内容。它决定了 Agent 一次能“看到”多少信息,也直接约束了多 Agent 交接时能传递的信息量上限。不同模型的窗口大小差异很大(从几千到上百万 token 不等),但即便窗口足够大,把完整历史塞进去也会带来成本、延迟和“中间信息丢失”(lost-in-the-middle)问题。因此,上下文窗口不是免费的仓库,而是一种需要精打细算的稀缺资源,这正是多 Agent 上下文传递必须工程化的根本原因。
四种主流传递策略:从全量到隔离
彭宇按token成本从高到低梳理了四种主流玩法,每种都有适用场景和代价。
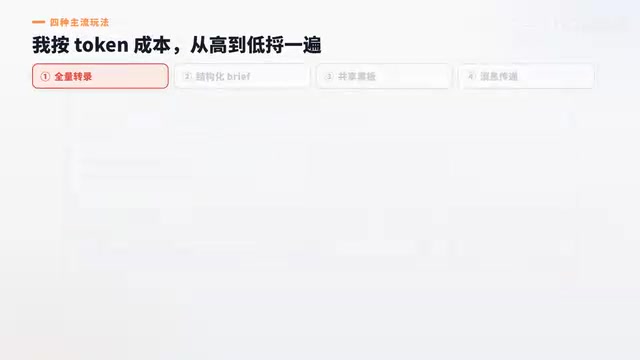
全量传递:整段历史原样搬过去,成本高且每跳都在膨胀,但信息损失最小。适合两跳以内、对准确性要求极高的短链场景。
结构化brief:不传历史,传一个字段定义好的摘要对象。成本恒定,而且逼着发送方想清楚什么才是重要的。这是绝大多数生产系统的默认选择。
共享黑板状态:把状态放在对话外的公共空间,谁需要谁去读。代价是它成了一个被随机过程共享的全局变量——一个Agent写错,另一个当真理读,错误就被洗白了。真要使用,必须只追加、带署名、写清谁写的、基于什么、置信度多少,让它像审计日志而不是谣言墙。
消息传递加无状态子Agent:每次只给对方需要的那几个字段,多一个都不给。微软有团队在A2A协议上做过对比,最后选的就是这种——领域Agent完全无状态,协调方把压缩过的历史直接嵌进消息发过去。好处是“谁能看到什么”变成可控的治理问题。
A2A 协议(Agent-to-Agent Protocol) 是一类面向多 Agent 协作的通信规范,旨在让不同框架、不同厂商构建的 Agent 能够互相发现、协商并交换任务信息。它通常定义消息格式、能力描述(Agent Card)、任务生命周期等要素,使 Agent 之间的交接不再依赖硬编码。微软团队在 A2A 上的对比实验,本质上是在评估:在标准协议之上,选择“传递完整对话历史”还是“传递压缩后的结构化消息”对系统可靠性和成本的影响。理解 A2A 有助于把上下文传递问题从“单机内部实现”提升到“跨 Agent 互操作”的层面。
四个字原则:外置、精选、压缩、隔离
机制说完了,面试官真正想听的是背后的设计思想。彭宇提炼为四个字:外置、精选、压缩、隔离。
外置:大对象别塞进prompt,写进文件只留引用。
精选:别指望一次把资料备齐,要用的时候再去取。
压缩:边界处一定要做摘要。Anthropic的研究系统中,子Agent探索几万token,给主Agent的只有1000到2000token的浓缩结论。
隔离:每个子Agent一个干净窗口,只装自己那份活。彭宇把它比作“上下文防火墙”——脏活累活它吸收掉,只把蒸馏完的答案递回来,主窗口保持清爽。
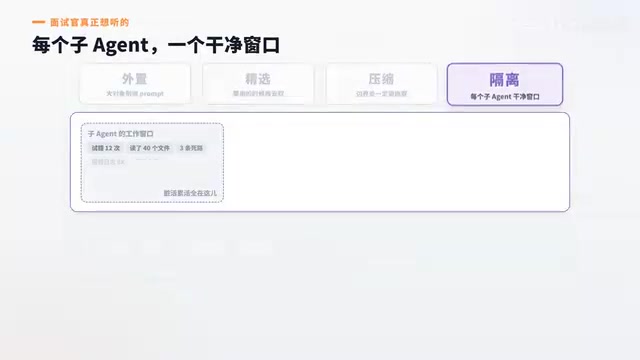
子 Agent(Sub-agent) 是由主 Agent(或称协调方、Orchestrator)派生出来执行特定子任务的 Agent 实例。它通常拥有独立的上下文窗口,只接收与子任务相关的输入,完成后把结果返回给主 Agent。子 Agent 的价值在于把复杂任务拆解为可并行或可隔离处理的单元,同时通过“干净窗口”避免主上下文被中间过程污染。Anthropic 的多 Agent 研究系统中,子 Agent 探索数万 token 后只回传 1000-2000 token 的结论,正是子 Agent 作为“上下文防火墙”的典型用法。
摘要该写什么:七个字段清单
摘要不是随便写写,彭宇给了一份可直接使用的字段清单:任务(用发送方自己的理解重写)、已发现的约束(比如“这块代码不许动”)、已锁定的决策(带上理由)、试过但失败的路径、结论(每条带来源标签:工具实测、模型推断还是上游继承)、置信度和完成度、指向原始上下文的指针。
其中“试过但失败的路径”性价比特别高——没有它,下游一定会把死路再走一遍。而“指向原始上下文的指针”提醒我们:摘要是缓存不是替代品,不够用随时能回溯。
写摘要时有一个容易踩的坑:视角应该是“下一个Agent需要什么”,而不是“我刚才做了什么”。这两个视角写出来的东西完全不同。
三个反模式与一句话总结
彭宇还总结了面试中说出就能加分的三个反模式:无脑转发完整历史还美其名曰“信息不丢”;拿一段散文当交接没有schema,重要的东西悄悄消失;把线性流程硬拆成多Agent——那不叫多Agent,那叫函数调用。
如果只能记一句话:多Agent的难点从来不是把单个Agent造出来,而是设计上下文怎么在它们之间流动。每一次交接都是一次有损压缩,你把它当成一等公民去工程化边界,这就是系统本身。
对于正在准备大模型岗位面试的开发者,这道题值得反复咀嚼。它考察的不是背诵概念,而是对系统边界和工程权衡的真实理解。
相关推荐
AGI领袖的隐秘信仰:人类没有特殊之处?
Vergecast播客揭示AGI领袖圈内的隐秘信念:人类没有特殊之处,意识只是计算。探讨计算功能主义如何影响技术精英的世界观与AI未来。
通用汽车转向混动:从纯电押注到务实并行的战略调整
通用汽车此前跳过混动直接押注纯电,如今计划为SUV产品线推出混合动力版本,本文解析这一战略调整的原因、对SUV品类的意义以及对消费者的实际影响。
Discord公开服务器将可被搜索引擎收录,用户隐私引担忧
Discord宣布从12月起将公开可发现服务器的消息纳入搜索引擎结果,引发用户对隐私和语境坍塌的担忧。本文分析这一变化对用户、社区运营者和平台信任的影响。