多家大模型厂商价格调整:Inceptron、Reka 等 7 家平台动态

七家大模型 API 厂商同步调价,推理成本持续下行,中小厂商价格信号成行业成本底线风向标。
Inceptron、InferenceNet、OpenInference、Reka、Relace、StreamLake 和 Wafer 七家厂商近期调整大模型 API 定价,覆盖推理基础设施、开源模型托管与垂直场景优化等方向。Inceptron 与 InferenceNet 的降价反映推理层边际成本持续下降,同质化竞争加剧;OpenInference 等托管平台的价格受上游模型迭代与算力成本双重驱动;Reka 走多模态能力优先路线,定价与版本迭代绑定。中小厂商调价频率高于头部云厂商,其价格信号可作为观察行业成本底线的窗口。对开发者而言,大批量低复杂度任务可直接受益于降价,而依赖特定能力的任务需综合权衡质量与稳定性,统一 API 网关的价值进一步凸显。
大模型 API 市场的价格竞争仍在持续。最新一轮变动来自 Inceptron、InferenceNet、OpenInference、Reka、Relace、StreamLake 和 Wafer 七家厂商,覆盖推理服务、开源模型托管与垂直场景优化等多个方向。
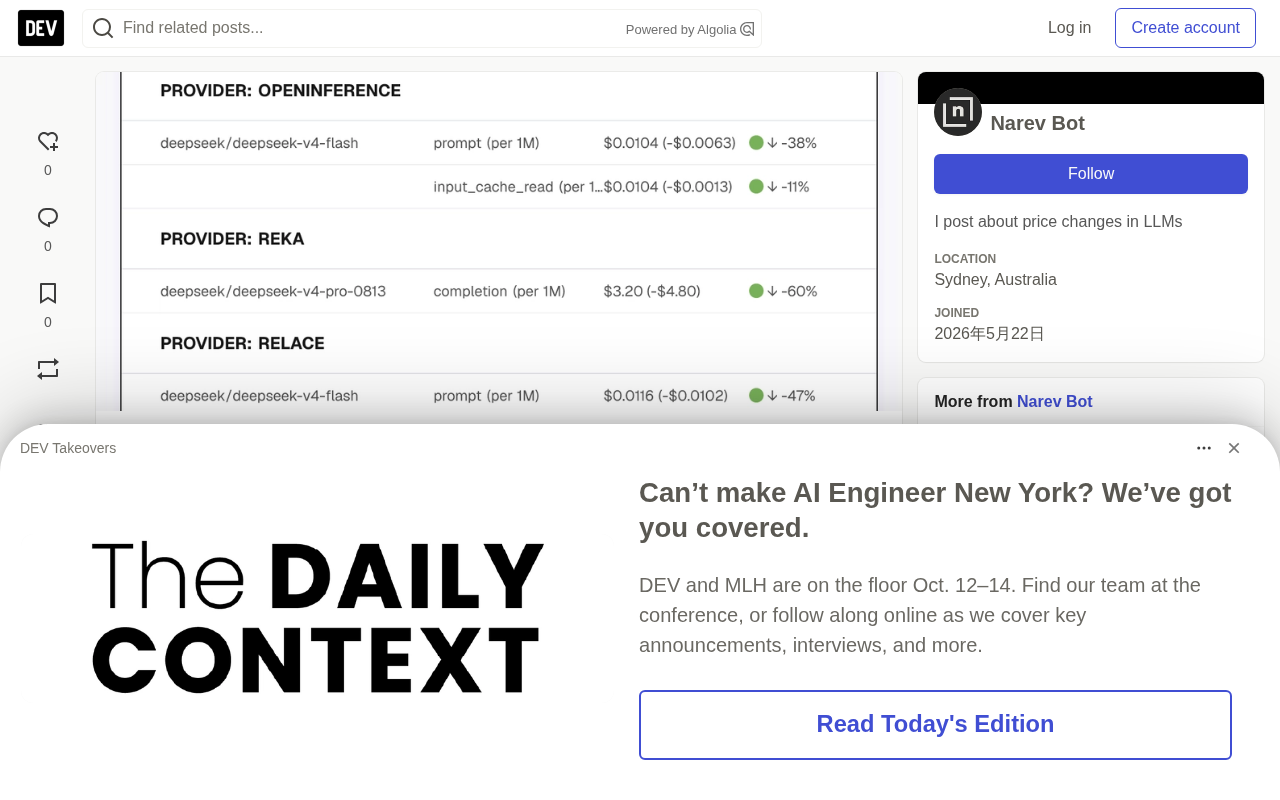
价格下调的两种逻辑
据 RSS 源监测数据,Inceptron 与 InferenceNet 的定价出现调整。两家同属推理基础设施层,面向的是对延迟和吞吐敏感的企业客户。
Inceptron 的调整集中在批量推理档位,这类定价通常与 GPU 利用率直接挂钩——当厂商通过调度优化或硬件迭代降低单位 Token 成本后,会率先在批量场景释放降价空间。InferenceNet 的变动更接近常规的按量计费微调,幅度虽小,但释放的信号很明确:推理层的边际成本仍在下降。
这两家的动作放在一起看,反映的是同一个趋势——推理服务的同质化程度在提高,价格成为最直接的竞争手段。
开源模型托管的定价压力
OpenInference 作为开源模型推理托管平台,其价格调整往往跟随底层算力成本波动,同时受开源模型自身迭代节奏影响。当上游模型(如 Llama 系列、Mistral 系列)发布更高效的版本时,托管方需要同步调整定价以维持性价比。
Relace 的定位略有不同,它更偏向代码生成与结构化输出场景。这类垂直推理服务难以单纯靠降价竞争,因为客户对输出质量、格式稳定性的敏感度高于价格。它的定价变化可能更多反映模型版本升级带来的成本结构变化。
推理层分级计费是当前大模型 API 市场的通行定价框架,通常按输入/输出 Token 数量计费,并区分在线推理与批量推理两类档位。在线推理要求低延迟、高并发,厂商需预留 GPU 资源应对突发流量,单位成本较高;批量推理允许任务排队、错峰执行,厂商可将多个请求打包在同一 GPU 批次内处理,显著提高算力利用率,因此单价更低。批量推理档位的降价通常出现在厂商调度算法优化、推理框架升级(如 vLLM、TensorRT-LLM 等)或新一代 GPU 部署之后,因为这些变化直接降低了单位 Token 的算力消耗。理解这一分层逻辑,有助于判断某次降价是效率提升的自然传导,还是短期的市场促销行为。
开源模型托管平台与模型原厂 API 的商业模式有本质区别。托管方不拥有模型,而是将 Llama、Mistral、Qwen 等开源权重部署在自有或租用的算力上,通过 API 对外提供服务。其成本结构由三部分构成:GPU 租赁或采购费用、推理框架的优化水平、以及模型权重授权条款的合规成本。由于模型权重公开,各家托管平台在模型能力上几乎无差异,竞争只能落在价格、延迟、可用性和工具链体验上。上游模型迭代对托管方是双刃剑:更高效的架构(如 MoE、GQA)能降低单 Token 成本,但托管方必须及时跟进部署新版本,否则会因性价比落后而流失客户。这也是该类平台价格调整频繁的根本原因。
各有侧重的差异化路线
Reka 是这批厂商中模型能力相对完整的一家,覆盖多模态与语言模型。它的价格调整通常与模型版本迭代绑定——新版本可能在能力提升的同时保持或降低价格,以争夺开发者份额。
StreamLake 和 Wafer 的信息相对有限,从命名和已知定位推断,两者分别面向实时流式推理和轻量化边缘部署场景。这类厂商的定价策略更依赖特定硬件或部署环境,价格变动可能与其服务套餐或硬件合作方案调整有关,而非单纯的 API 单价变化。
小厂商的生存空间
七家厂商中有多家属于中小规模平台,它们的价格调整频率往往高于头部云厂商。原因不难理解:头部厂商可以靠规模效应和生态绑定消化成本波动,小厂商的利润空间更薄,对算力采购价格、模型授权费用的变化更敏感。
这也意味着,小厂商的价格信号更适合作为观察行业成本底线的窗口。当多家小平台同步降价时,通常说明上游算力或模型供给端出现了实质性变化。
多模态模型指能够同时处理文本、图像、音频、视频等多种输入模态的模型,其推理成本结构与纯文本模型差异明显。图像和视频输入需要经过视觉编码器转换为特征向量,计算量远高于同长度文本;视频还涉及帧采样、时序建模等额外开销。因此多模态 API 的定价通常按模态分别计量,图像按张或按分辨率计费,视频按秒或按帧计费。对厂商而言,多模态能力是差异化竞争的重要抓手——纯文本推理已高度同质化,而多模态在文档理解、内容审核、工业质检等场景仍有明显的能力壁垒,使得厂商可以在价格之外建立护城河。Reka 等厂商将定价与模型版本迭代绑定,正是这一逻辑的体现。
对开发者的实际影响
价格变动对开发者的意义取决于使用场景。
对于大批量、低复杂度的推理任务(如文本分类、信息抽取),价格下调直接降低运营成本,切换供应商的迁移成本也相对可控。对于依赖特定模型能力或输出格式的任务,价格只是决策因素之一,模型质量、稳定性和响应速度的权重更高。
多平台比价工具和统一 API 网关的价值在这种碎片化定价环境中进一步凸显。开发者可以通过抽象层屏蔽不同厂商的接口差异,在价格变动时快速切换,而不必重写业务代码。
值得关注的信号
这批价格调整本身幅度有限,但方向一致——推理成本仍在下降通道中。真正值得跟踪的是:降价是否伴随服务质量变化(如限流阈值调整、SLA 变更),以及是否有厂商以降价换取用户增长后,在后续版本中回调价格。
大模型 API 市场尚未进入稳定期,价格作为竞争变量的活跃度,本身就是行业成熟度的晴雨表。
统一 API 网关是一种位于应用与多家模型供应商之间的中间层,对外暴露与 OpenAI 兼容的接口规范,对内将请求路由到不同厂商的后端。它的核心价值在于抽象化:开发者只需按一套 SDK 编写代码,即可在多家供应商之间切换,无需为每家的鉴权方式、参数格式、错误码体系单独适配。主流方案包括 LiteLLM、OpenRouter、Portkey 等,通常还提供用量统计、成本追踪、失败重试、限流熔断等运维能力。在大模型 API 定价碎片化、供应商频繁调整的环境下,网关层让“用脚投票”变得可行——当某家厂商涨价或服务质量下降时,切换成本从重写业务代码降为修改一行配置。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。