多流形聚类新突破:MiniMax率与谱收敛改进

新论文建立多流形聚类中Laplace-Beltrami算子特征对估计的极小极大率,并将流形无关图拉普拉斯估计器的谱收敛速度提升至n^{-1/(2.5d-1)}。
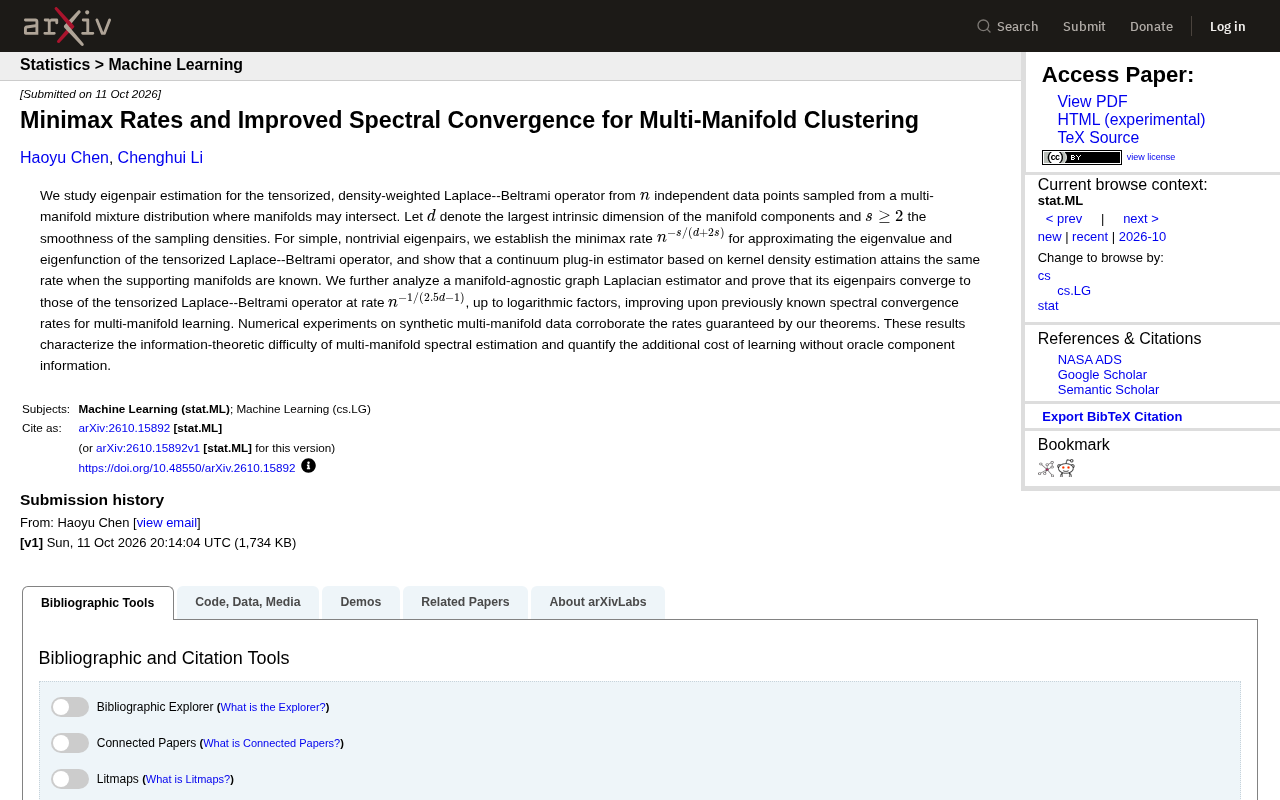
这篇论文研究多流形混合分布下的谱结构估计问题,其中数据分布在多个可能相交的低维流形上。作者首先建立了张量化密度加权Laplace-Beltrami算子特征对估计的极小极大率n^{-s/(d+2s)},其中d为最大内在维度、s为密度光滑度,并证明基于核密度估计的plug-in估计器在流形已知时达到该最优速率。随后,论文分析了实际中更常用的流形无关图拉普拉斯估计器,证明其收敛率为n^{-1/(2.5d-1)},显著改进了此前多流形学习的谱收敛速度。论文还量化了无流形信息的额外代价:速率指数从s/(d+2s)退化到约1/(2.5d)。合成数据实验验证了理论速率,为多流形聚类和谱估计提供了坚实的理论基础和性能基准。
多流形聚类是机器学习中一个基础而棘手的问题:当数据分布在多个可能相交的低维流形上时,我们能否准确地估计出描述这些流形的谱结构?一篇新论文《Minimax Rates and Improved Spectral Convergence for Multi-Manifold Clustering》给出了理论上的回答,不仅建立了张量化密度加权Laplace-Beltrami算子特征对估计的极小极大率,还改进了流形无关图拉普拉斯估计器的谱收敛速度。
问题设定:从多流形混合分布中估计谱
论文考虑从多流形混合分布中独立采样 n 个数据点,其中流形可能相交。设 d 为流形成分的最大内在维度,s ≥ 2 为采样密度的光滑度。目标是估计张量化、密度加权的 Laplace-Beltrami 算子的特征对,这等价于捕捉每个流形上的扩散几何结构。
这一设定与经典的单流形学习不同:相交流形意味着局部邻域可能混合来自不同流形的点,给谱估计带来了本质困难。论文聚焦于简单非平凡特征对,并首次给出了该问题的极小极大下界,从而刻画了信息论意义上的统计难度。
Laplace-Beltrami 算子是定义在黎曼流形上的二阶椭圆微分算子,可视为欧氏空间中拉普拉斯算子在弯曲空间上的推广。在流形学习中,它刻画了流形上的热扩散过程,其特征函数构成流形上的一组正交基,因而能捕捉数据的"扩散几何"结构——即任意两点间的扩散距离。对多流形混合分布而言,每个流形成分都对应一个 Laplace-Beltrami 算子,其谱结构(特征值与特征函数)反映了该流形自身的几何形态。"张量化"(tensorized)一词在此指将这些算子组合成块对角形式,使得联合谱包含了各流形成分的信息;"密度加权"则是因为数据按某一密度采样,算子需要按采样密度进行调整,否则谱估计会偏向高密度区域。
**极小极大率(minimax rate)**是统计估计理论中的核心概念,用于刻画在所有可能的数据生成分布上、所有估计器中能达到的最优收敛速度。具体地,极小极大风险定义为在所有参数上取上确界、在所有估计器上取下确界所得到的最优误差。极小极大下界说明不存在任何估计器能比该速率更快地收敛,而上界则说明存在达到该速率的估计器。因此,极小极大率同时给出了问题的统计难度基准与最优算法的性能标准。在多流形聚类问题中,n^{-s/(d+2s)} 这一速率揭示了一个重要现象:估计精度随样本量 n 增大而提高,但提高的速度受内在维度 d 和密度光滑度 s 共同制约。
核心结果:极小极大率与 plug-in 估计器
对于简单非平凡特征对,论文建立了特征值和特征函数逼近的极小极大率 n^{-s/(d+2s)}。这个速率反映了光滑度 s 和内在维度 d 之间的权衡:维度越高、密度越粗糙,估计越困难。
更关键的是,论文证明了一个基于核密度估计的连续 plug-in 估计器在支撑流形已知时可以达到相同的速率。这意味着,如果拥有“上帝视角”知道每个流形的位置,那么从统计角度看,这个速率是最优的。
这一结果为多流形谱估计设立了基准:任何实际算法(不知道流形结构)的性能差距,都可以用这个最优速率来衡量。
plug-in 估计器是一类经典的统计推断方法:先用数据估计出模型中的未知量(如密度),再将估计值直接代入目标泛函的表达式中,从而得到目标量的估计。在本论文中,plug-in 估计器先用核密度估计方法估计采样密度,再将密度估计代入密度加权的 Laplace-Beltrami 算子的连续表达式中,最后对该算子做特征分解以获得特征对的估计。该估计器被称为"连续"的,因为它不依赖于构造图或离散化,而是直接作用于连续算子。plug-in 方法的优势在于其理论分析较为直接,且当密度估计达到最优速率时,目标泛函的估计也能继承良好的收敛性质。
**核密度估计(KDE)**是最经典的非参数密度估计方法:在每个数据点处放置一个核函数(通常是对称的概率密度函数,如高斯核),然后将所有核函数叠加并归一化,得到密度的估计。核密度估计的收敛速率由带宽参数决定:带宽过大则估计过度光滑、偏差大,带宽过小则估计方差大。最优带宽下,核密度估计在光滑度为 s 的密度上达到 n^{-s/(2s+1)} 的收敛速率。这篇论文中,plug-in 估计器所达到的极小极大率 n^{-s/(d+2s)} 与此一脉相承,但额外体现了内在维度 d 的影响。
流形无关估计器:收敛率提升至 n^{-1/(2.5d-1)}
实际场景中我们并不知道流形信息,因此论文进一步分析了流形无关的图拉普拉斯估计器。作者证明,该估计器的特征对收敛到张量化 Laplace-Beltrami 算子的速率为 n^{-1/(2.5d-1)}(忽略对数因子)。
相比此前已知的多流形学习谱收敛速率,这是一个显著的改进。例如,早期结果通常给出更慢的速率,尤其是在 d 较大时。新速率表明,即使没有流形成分信息,图拉普拉斯方法仍能以相对可控的代价逼近理想谱。
论文还量化了“学习流形结构”的额外代价:与已知流形的最优 plug-in 估计器相比,流形无关方法的速率指数从 s/(d+2s) 退化到约 1/(2.5d),体现了维度灾难在无监督几何学习中的具体形式。
**图拉普拉斯(graph Laplacian)**是基于数据点构造的离散算子,是流形学习中最常用的工具之一。给定 n 个数据点,先根据某种相似度度量(如高斯核)构造一个加权图,然后定义图拉普拉斯矩阵 L = D - W(或归一化版本),其中 W 是权重矩阵、D 是度矩阵。图拉普拉斯矩阵的特征值和特征向量在样本量趋于无穷时收敛到流形上 Laplace-Beltrami 算子的谱。这一收敛性质是谱聚类、扩散映射、拉普拉斯特征映射等算法的理论基础。
**流形无关(manifold-agnostic)**意味着算法不假设已知流形的数量、维度或位置,而是直接从数据中构造图并计算谱。这与 plug-in 估计器形成对比:后者需要"上帝视角"地知道每个流形的位置。流形无关方法的实际优势在于可操作性强,但由于必须从数据中同时学习流形结构和谱,其收敛速率会不可避免地慢于已知流形的情形。论文所证明的 n^{-1/(2.5d-1)} 速率,正是对这种"结构学习代价"的精确刻画。
谱收敛是指图拉普拉斯矩阵的离散特征对(特征值、特征向量)随样本量增大而收敛到连续 Laplace-Beltrami 算子特征对的过程。这一概念是理解论文改进的核心:早期多流形学习结果通常给出较慢的收敛速率,而本文通过更精细的分析将速率指数提升至 1/(2.5d-1),在 d 较大时改进尤为显著。
数值实验验证理论速率
作者在合成多流形数据上进行了数值实验,结果与理论保证的速率一致。实验覆盖了不同内在维度、光滑度和流形相交程度的设置,验证了有限样本下估计误差随 n 的衰减趋势。
这些实验不仅支持了理论结论,也提示了实际应用中样本量的需求:当 d 较大时,需要指数级更多的样本才能达到相同精度,这与极小极大率的下界一致。
意义与展望
这项工作为多流形聚类和谱估计提供了坚实的理论基础:一方面给出了信息论下界,另一方面改进了实用算法的收敛保证,并明确了无需流形知识的额外代价。
未来可能的方向包括:将分析扩展到更复杂的特征对(如重特征值)、考虑流形相交处的奇异性、以及设计达到极小极大率且计算可行的流形无关算法。对于从事聚类、降维和几何深度学习的读者,这篇论文的速率结果值得作为基准参考。
相关推荐

当Outside Xbox遇上血染钟楼:Minecraft里的军团对局
Outside Xbox嘉宾Ellen和Mike做客Minecraft版《血染钟楼》,迎战军团恶魔局。三名好人如何在信息噪音中对抗多数邪恶?本文解析军团机制、信息角色博弈与终局逆转。

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。