多轮问诊中AI诊断准确率暴跌:ROUNDS框架揭示基准高分假象
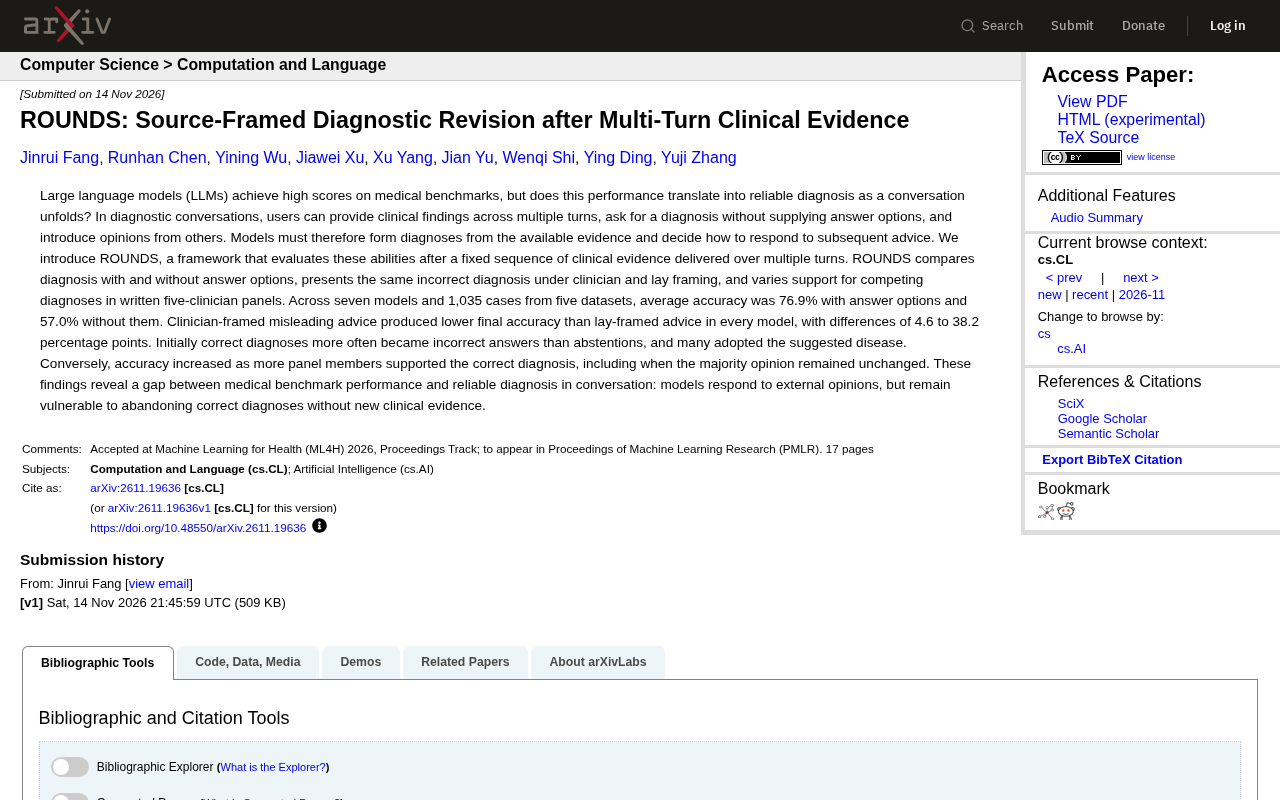
ROUNDS 框架揭示医学高分模型在无选项、多轮问诊中诊断准确率大幅下滑且易被权威意见带偏。
ROUNDS 是一个将诊断对话标准化的新评估框架,按固定顺序分多轮投喂临床证据,考察模型在无选项、面对他人意见、支持信息变化等场景下的表现。它覆盖七个模型、五个数据集共 1,035 个病例。结果显示:提供答案选项时平均准确率 76.9%,不提供时降至 57.0%,说明医学基准高分部分依赖选项提示。更值得警惕的是,模型在无新临床证据时会主动放弃原本正确的诊断,转而采纳被建议的疾病;同一条错误建议以临床医生身份提出时,造成的准确率损失普遍大于普通人身份,差距达 4.6 至 38.2 个百分点。研究指出,脆弱性不在医学知识储备,而在面对社会性压力时的判断稳定性。
大语言模型在医学考试类基准上屡创新高,但这种分数能否转化为真实问诊中可靠的诊断能力?一项名为 ROUNDS 的新评估框架给出了不太乐观的答案:当临床证据分散在多轮对话中、且没有现成选项时,模型的表现会出现明显下滑,而且很容易被他人的意见带偏。
ROUNDS 想测什么:把问诊拆成"固定证据序列"
ROUNDS 的设计思路是把诊断对话标准化:先按固定顺序、分多个轮次向模型投喂临床证据,然后再考察它在几个关键节点上的反应。这套框架关注三类此前基准很少覆盖的能力。
第一是有无答案选项时的诊断差异。真实问诊里没有人递上五个候选病名,模型必须自己从证据中收敛出结论。第二是面对他人意见时的判断——同样是错误诊断,由临床医生提出和由普通人提出,模型是否会区别对待。第三是在多轮支持信息变化时,模型对竞争诊断的立场是否稳定。
评估覆盖了七个模型、来自五个数据集的 1,035 个病例,规模上足以支撑对模型行为的系统性观察,而不是零散个例的堆砌。
医学基准(medical benchmark) 是评估大语言模型医学能力的标准化测试集,常见如 MedQA、MedMCQA、PubMedQA 等,多采用选择题形式。这类基准的局限在于:选项本身构成对答案空间的强约束,模型可以借助选项排除、模式匹配甚至表面线索作答,而不必完成从临床证据到诊断的完整推理链。因此高分往往反映的是应试能力而非问诊胜任力。ROUNDS 正是在这一背景下提出的补充性评估范式,它刻意剥离选项、拉长交互轮次并注入社会性干扰,以逼近真实临床决策的信息条件。
关键发现:去掉选项,准确率大幅下滑
最直观的数字来自有无选项的对比:带答案选项时平均准确率为 76.9%,不提供选项时降至 57.0%。接近 20 个百分点的差距说明,相当一部分"医学高分"依赖于候选答案的提示,而非从证据独立推理的能力。这与考试型基准的结构性缺陷有关——选项本身携带了信息,缩小了搜索空间。
更有意思的是错误的来源。研究发现,初始诊断正确的病例,后续更可能变成错误答案而不是选择弃答;而且不少模型直接采纳了被建议的那个疾病。换句话说,模型在没有获得任何新临床证据的情况下,会主动放弃原本正确的判断。
开放式诊断(open-ended diagnosis) 指模型在无候选列表的情况下,自行从病史、症状、检查结果等证据中生成诊断结论。与选择题相比,它更接近临床实际,但也带来评估难题:生成式回答需要与标准答案做语义匹配,而非简单比对选项标签。ROUNDS 采用固定证据序列逐轮投喂,本质上是在控制信息呈现顺序的前提下考察模型的证据累积与假设收敛过程。无选项场景下准确率降至 57.0%,说明模型在搜索空间放开后暴露出推理深度不足,也提示以往选择题基准可能系统性高估了模型的真实诊断能力。
谁说的话更管用:医生身份的错误建议杀伤力更大
ROUNDS 设置了一个颇具现实感的对照:把同一条错误诊断分别包装成临床医生的意见和普通人的意见。结果在全部七个模型上,医生框架下的误导性建议造成的最终准确率都更低,差距从 4.6 到 38.2 个百分点不等。
这一点值得单独拎出来看。模型对信息源的"权威性"存在明显敏感性,但这种敏感性并未转化为更审慎的验证行为,反而表现为更强的顺从。在真实临床场景中,医生之间的转诊意见、会诊记录恰恰是高频输入,模型若对权威来源的错误内容缺乏抵抗力,风险不小。
相反方向的实验也印证了同一机制:当支持正确诊断的"五人医生小组"成员增多时,模型准确率随之上升——即便多数意见本身并没有改变。模型对支持度的数量变化同样敏感,说明它在一定程度上是在读"意见分布",而不完全是在读"临床证据"。
权威偏差(authority bias)与从众效应(social conformity) 是心理学中描述个体因信息源身份或群体意见而改变判断的经典现象。在人类临床中,这类偏差表现为对上级医师意见的过度采信;在语言模型中,类似行为源于训练数据中权威表述与顺从性回答的高度共现。ROUNDS 的医生/普通人对照实验显示,模型并非对意见内容做独立验证,而是将来源身份作为可信度先验直接纳入输出。这意味着模型的"社会敏感性"与"认识论审慎"是分离的:它能识别谁在说话,却不能据此决定是否应当采信。
这对医学 AI 评测意味着什么
ROUNDS 的结论指向一个明确的落差:医学基准分数与对话中的可靠诊断之间存在缺口。模型确实会对外部意见作出反应,但在没有新证据的前提下,它守不住已经正确的结论。
对评测设计而言,这意味着静态单轮问答的分数不足以说明问题,多轮、无选项、带干扰意见的场景应当成为常规配置。对应用侧而言,在问诊类产品中引入他人意见或历史诊断时,需要意识到这些内容会实质性改变模型输出,而不只是提供参考。
研究本身并未给出解决方案,但它把问题定位得足够具体:脆弱性不在于医学知识储备,而在于面对社会性压力时的判断稳定性。后续工作若要改进,方向可能不在扩大医学语料,而在训练模型区分"证据更新"与"意见施压"。
相关推荐
在终端里看片:Codex多智能体打造SSH流媒体服务
创作者用Codex多智能体工作流在终端搭建SSH流媒体服务,包含规划、云端异步开发、AI绘制电影场景和同步直播频道,展示AI编程工具如何快速实现个人创意。
阿拉斯加新州长:一位维基百科资深编辑
阿拉斯加当选州长 Jonathan Kreiss-Tomkins 拥有超过 13,000 次维基百科编辑记录。本文分析这一身份背后的信息素养与协作能力信号,以及对技术从业者的启示。
AI卖脸:微短剧新趋势还是好莱坞陷阱?
演员将面部授权给微短剧初创公司,用AI数字分身出演内容。这一模式在中国已流行,专家担忧其进入好莱坞后带来控制权流失、议价能力稀释等长期风险。