多模态推理的「指称鸿沟」:视觉标记能修复什么?

多模态模型推理失败常源于语言未绑定到正确视觉实体的「指称鸿沟」。
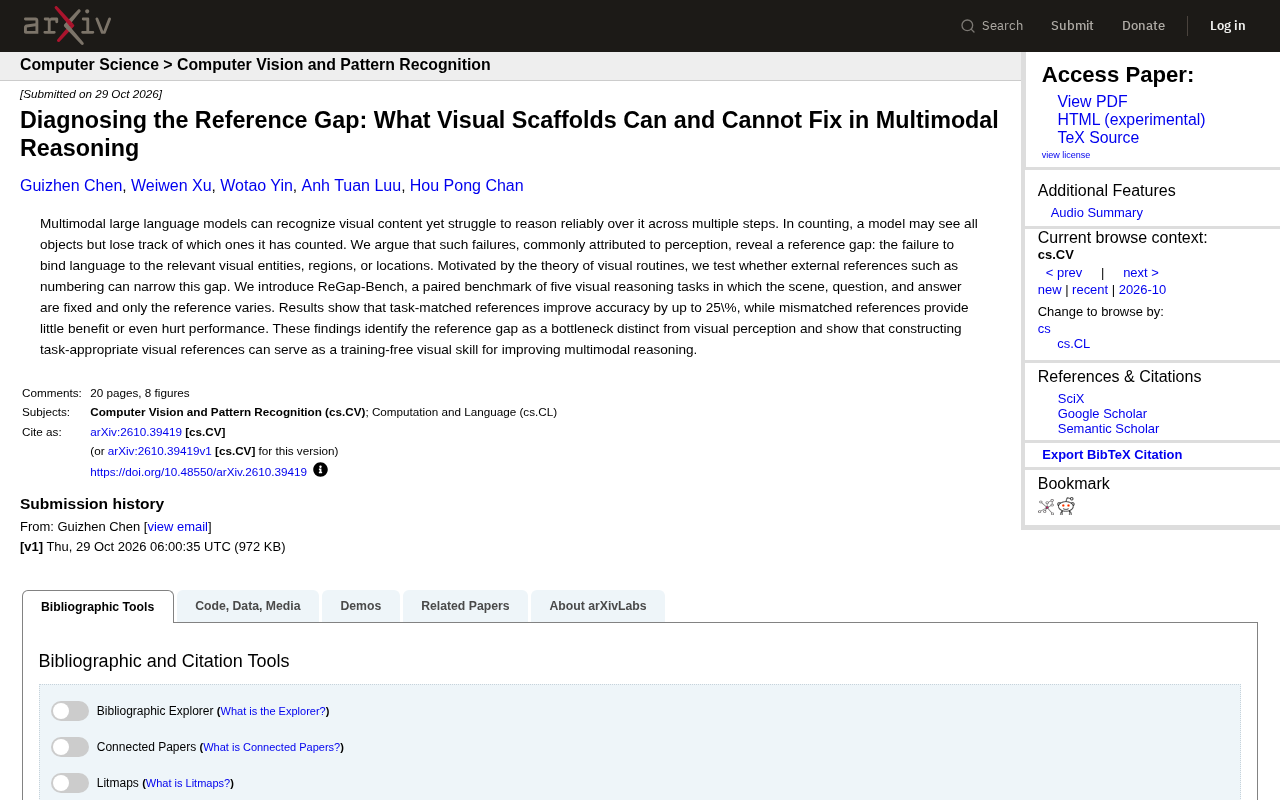
多模态大语言模型能识别视觉内容,但在多步视觉推理中可靠性下降,常被误归因于感知不足。新研究提出「指称鸿沟」概念:语言未被正确绑定到相关视觉实体、区域或位置。受视觉常规理论启发,研究者构建 ReGap-Bench,固定场景、问题与答案,仅改变指称方式(如编号),以隔离指称变量。实验发现,与任务匹配的指称可提升准确率最高25%,不匹配则收益甚微甚至有害。这表明指称是独立于感知的瓶颈,且构造任务适配的指称可作为一种免训练的视觉技能来提升推理表现。
为什么模型「看得见」却「想不明白」?
多模态大语言模型在识别视觉内容上已经相当成熟,但一旦需要在多个步骤之间对视觉信息进行推理,可靠性就明显下降。一个典型场景是计数:模型能看见画面里的所有物体,却在计数过程中丢失了「哪些已经数过」的状态。这类错误常被归因于感知能力不足,但一篇新研究提出了不同的解释——问题出在指称环节。
研究者将这种失败模式定义为「指称鸿沟」(reference gap):语言没有被正确绑定到相关的视觉实体、区域或位置上。换句话说,模型并不是没看到,而是没把「它」和画面中的「那一个」对应起来。
视觉常规理论:用外部标记缩短指称距离
研究受到「视觉常规」(visual routines)理论的启发。该理论认为,复杂的视觉任务可以被分解为一系列基础操作,而这些操作需要依赖对画面中特定位置的显式指涉。
顺着这个思路,研究者测试了一个简单假设:如果给画面加上外部指称(例如编号),模型能否更稳定地把语言和视觉对象对应起来?为此他们构建了 ReGap-Bench,一个包含五类视觉推理任务的配对基准。
这个基准的设计是控制变量的关键:同一道题,场景、问题和答案完全固定,唯一变化的是指称方式。这样一来,任何准确率的差异都可以归因于指称,而不是感知难度或题目本身。
「视觉常规」由心理学家 Shimon Ullman 在 1980 年代提出,用来解释人类如何完成那些无法靠单次注视解决的视觉任务。其核心观点是:视觉系统并非一次性解析整幅图像,而是调用一组可组合的「基础操作」——如移动注意力焦点、标记某个位置、比较两个区域的特征——按顺序执行,从而逐步构建出对场景的理解。这些操作的关键在于能够对画面中的特定位置建立显式指涉,即「先记住这里,再回到这里」。这一理论后来被广泛用于解释视觉搜索、连线追踪、计数等任务的认知机制,也为计算模型如何组织多步视觉推理提供了概念框架。
核心发现:匹配才有用,不匹配反而有害
实验结果给出了清晰的结论:
- 与任务匹配的指称方式,可将准确率提升最高达 25%;
- 指称方式与任务不匹配时,收益微乎其微,甚至会让表现变差。
这组对比说明,指称不是「加了就好」的通用增强,而是一种需要与任务结构对齐的干预。编号对计数任务有效,是因为它天然提供了「已数/未数」的区分;但如果任务需要的是空间关系或区域定位,同一套编号可能引入干扰。
因此,指称鸿沟是一个独立于视觉感知的瓶颈——它解释了一部分此前被误判为「看不清」的错误。
在多模态模型中,「指称」通常通过文本 token 与视觉 token 之间的注意力对齐来实现。模型需要把「第三个」「左边那个」「已经数过的」这类语言表达映射到图像中的特定区域或对象上。当语言指称与视觉特征之间的对应关系模糊时,注意力可能分散到多个候选对象上,导致状态跟踪失败。外部编号的作用在于它把这种隐式的、需要模型自行推断的对应关系,转化为显式的、可直接匹配的符号对应,从而降低了语言到视觉的绑定难度。这也解释了为何指称的效果高度依赖任务结构:编号提供了序数信息,但无法替代空间关系或区域边界的表达。
训练无关的「视觉技能」
这项研究更实用的启示在于:构造任务适配的视觉指称,本身就可以作为一种免训练的视觉技能来提升多模态推理。
不需要微调模型,也不需要额外的感知模块,只需在输入侧改变指称的组织方式。这对实际应用有直接价值——在需要多步视觉推理的场景里,如何呈现视觉信息,可能和模型本身同样重要。
当然,研究也留下了开放问题:如何自动为任意任务生成合适的指称?指称的粒度如何选择?这些都需要后续工作来回答。
「免训练」在此类研究中通常指不更新模型参数、不引入额外可学习模块,仅通过改变输入的组织方式来影响模型行为。这与提示工程、上下文学习同属推理时干预的范畴,但区别在于它作用于视觉输入的结构,而非仅调整文本指令。其优势是即插即用、成本低、可解释性强;局限则是效果受限于模型已有的指称能力,且需要针对任务手工设计指称方案。对于需要多步视觉推理的实际应用,这意味着在模型选型之外,输入呈现方式本身就是一个值得优化的设计维度。
要点回顾
指称鸿沟把我们熟悉的「感知 vs 推理」二分法撕开了一个口子:模型的失败有时既不是看不见,也不是不会想,而是没把语言锚定到正确的视觉对象上。ReGap-Bench 的配对设计让这一变量被单独测量,而「匹配才有效」的结论提醒我们,视觉增强不是通用补丁,而是需要与任务结构对齐的设计决策。
相关推荐
WorkBuddy实战:腾讯AI Agent如何让大模型真正动手干活
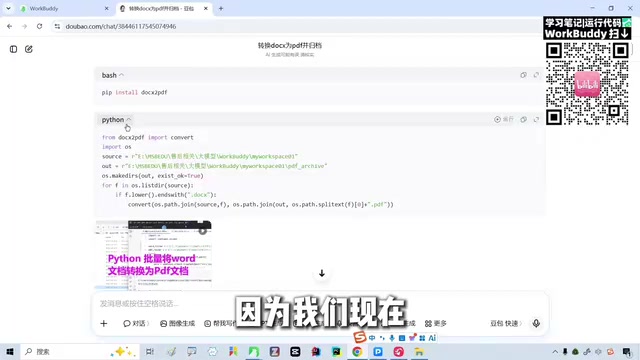
WorkBuddy是腾讯推出的办公场景AI Agent工具,能理解自然语言需求并直接操作电脑完成任务。本文通过文件转换实战演示,对比豆包等聊天大模型与Agent的核心差异,分析WorkBuddy与CodeX的能力差距及适用场景。
Vibe Coding保姆级教程:3步上手AI编程
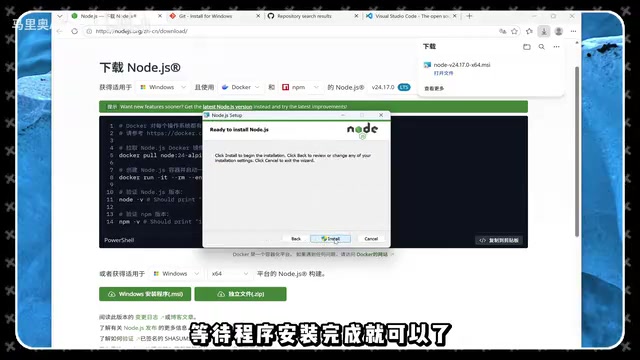
一篇面向零基础用户的Vibe Coding保姆级教程,分三步讲解Claude Code安装、DeepSeek API接入与编辑器调度配置,附常见报错解决方法和踩坑提醒。
Instagram放任名人AI深伪内容泛滥?
一张AI生成的Mia Goth照片经Instagram蓝V认证账号发布后全网疯传,Google AI Overview将其当作真实信息摘要。Taylor Swift和Lionel Messi的AI视频播放量达百万级,Meta却不要求AI照片标注,平台治理面临失效质疑。