多任务模型准确率卡在0.40?社区求助与诊断思路

葡萄牙开发者多任务模型准确率卡在0.40,社区建议从基线、预训练与损失平衡系统排查。
一位葡萄牙语开发者在 Reddit 求助,其多任务模型准确率长期停留在 0.40 左右,怀疑是模型容量不足或缺乏预训练。文章分析认为,多任务学习的准确率停滞通常源于四类原因:模型容量与任务复杂度不匹配、缺乏预训练导致从零训练数据不足、损失权重失衡使某个任务主导梯度、以及数据质量与标签一致性问题。针对这些可能,文章建议社区从建立单任务基线、对比 Hard/Soft Parameter Sharing 或 MMoE 等架构、引入预训练编码器、调整学习率与优化器四个方向提供帮助,并给出了一份可执行的五步排查清单。核心结论是:0.40 本身需结合任务类别数判断是否接近随机水平,而基线对比和损失监控是多任务调试中不可省略的步骤,求助时补充任务类型、数据规模和损失曲线能显著提高获得有效建议的概率。
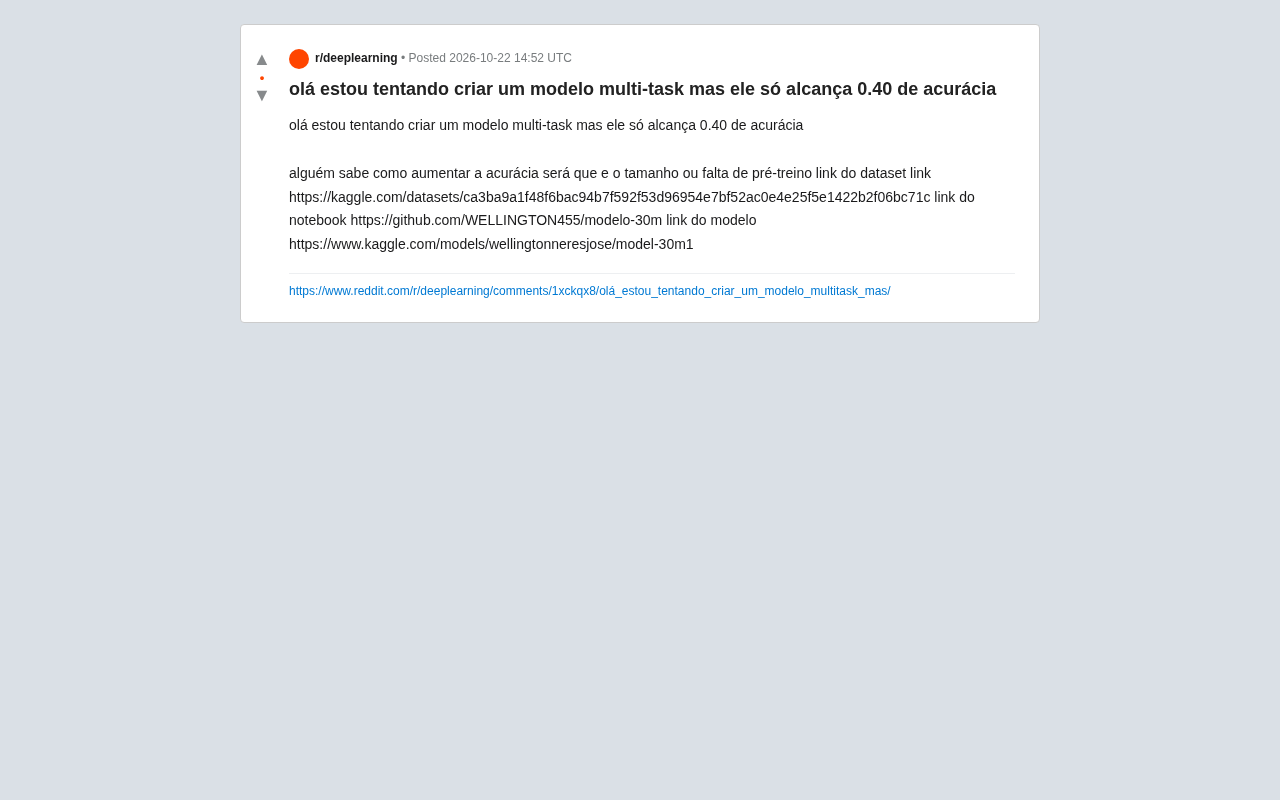
一位葡萄牙语开发者在 Reddit 上发帖求助:他正在训练一个多任务模型,但准确率始终卡在 0.40 左右,无法进一步提升。他怀疑是模型尺寸不足或缺乏预训练,并附上了数据集、Notebook 和模型的链接,希望社区能帮忙诊断。
问题背景:多任务学习为何难提升
多任务学习(Multi-task Learning)的核心思想是让一个模型同时学习多个相关任务,通过共享表示来提升泛化能力。然而,任务之间的冲突、数据不平衡、损失函数权重分配不当等问题,都可能导致模型在某个任务上表现不佳,甚至整体准确率停滞。
这位开发者提到准确率只有 0.40,这个数字本身需要结合具体任务来判断——如果任务是三分类或四分类,0.40 可能接近随机水平;如果是更细粒度的分类,则需要进一步分析基线。
Hard Parameter Sharing 与 Soft Parameter Sharing 是多任务学习中最基础的两种参数共享范式。Hard Parameter Sharing 让所有任务共用同一个底层编码器,只在输出端保留各自的任务头,参数量最省、过拟合风险最低,但当任务差异较大时容易互相干扰。Soft Parameter Sharing 则为每个任务维护独立的网络分支,并通过正则项(如 L2 距离)或跨任务注意力约束各分支参数保持接近,灵活性更高但参数和调优成本也更大。实践中还有折中方案,例如在共享层之上再堆叠任务特定层,或使用 MMoE 这类门控专家结构让不同任务自适应地选择共享子网络。
MMoE(Multi-gate Mixture-of-Experts) 由 Google 在 2018 年提出,核心是在共享层放置多个“专家”子网络,每个任务拥有独立的门控网络,用于对专家输出进行加权组合。这样不同任务可以按需复用不同专家,缓解任务冲突,同时保留参数共享带来的泛化收益。相比 Hard Parameter Sharing,MMoE 在多任务相关性较弱时通常表现更稳,但结构更复杂、训练成本更高,且门控权重需要足够数据才能学好。
可能的原因分析
1. 模型容量与任务复杂度不匹配
开发者自己怀疑“模型太小”。这确实是一个常见原因:多任务模型需要足够的容量来同时捕捉多个任务的模式。如果共享层过窄,不同任务的特征会相互挤压,导致每个任务都学不好。可以尝试增加共享层的宽度或深度,或者采用更灵活的结构(如为每个任务保留独立的头部,甚至部分独立层)。
2. 缺乏预训练
从零开始训练多任务模型通常需要大量数据。如果数据集规模有限,预训练(例如使用在大规模语料上训练好的编码器)可以显著提升效果。开发者提到“falta de pré-treino”(缺乏预训练),这很可能是关键因素之一。使用预训练语言模型或视觉骨干网络作为起点,再微调多任务头,往往比从头训练更稳定。
3. 损失权重与任务平衡
多任务学习中,不同任务的损失量级可能差异很大。如果简单地将损失相加,某个任务可能主导梯度更新,导致其他任务欠拟合。需要检查损失权重设置,尝试动态调整权重(如不确定性加权)或手动调参。
不确定性加权(Uncertainty Weighting) 是 Kendall 等人在 2018 年提出的一种多任务损失平衡方法。它把每个任务的损失视为一个带噪声的观测,并为每个任务引入一个可学习的对数方差参数 σ²,最终总损失写成各任务损失除以 2σ² 再加上 log σ 的形式。训练过程中模型会自动降低噪声大、难以学习的任务的权重,从而避免手动调参。实现上通常对 σ² 取对数以保证数值稳定,并需注意该项会让总损失量级随训练变化,监控各任务有效权重比(1/2σ²)是排查“某任务主导梯度”的直接手段。
另一种常见做法是 GradNorm 或 PCGrad 等梯度层面的平衡策略:前者动态调整各任务损失权重使梯度范数趋于一致,后者在梯度方向冲突时做投影消解。相比只调损失系数,这类方法直接作用于反向传播,能更细粒度地缓解任务间的梯度拉扯,但实现和调试成本更高,适合在简单加权无效后再尝试。
4. 数据质量与标注一致性
数据集是否存在标签噪声?多任务标签是否对齐?开发者提供了 Kaggle 数据集链接,但未说明数据规模。建议先检查每个任务的类别分布,确认是否存在严重不平衡。
社区可提供的帮助方向
由于帖子信息有限,社区成员可以从以下几个角度提供建议:
- 检查基线:先分别训练单任务模型,看看每个任务单独能达到什么准确率。如果单任务也只有 0.40,问题可能出在数据或特征上,而非多任务结构。
- 调整模型结构:尝试 Hard Parameter Sharing 与 Soft Parameter Sharing 的对比,或者使用 MMoE(Multi-gate Mixture-of-Experts)等更先进的多任务架构。
- 引入预训练:使用 Hugging Face 上的预训练模型作为编码器,冻结部分层后微调。
- 学习率与优化器:多任务训练对学习率敏感,可以尝试更小的学习率、warmup 或分层学习率。
单任务基线(Single-task Baseline) 是多任务调试中最重要的对照实验。做法是保持数据划分、预处理和评估指标完全一致,为每个任务单独训练一个同规模或更小的模型,记录其验证集准确率。若某任务单任务也仅 0.40,说明瓶颈在数据质量、特征表达或标签定义,继续调多任务结构收益有限;若单任务明显更高,则问题更可能出在共享层的任务冲突或损失权重上。基线还能帮助判断 0.40 是否接近随机水平——例如三分类随机约为 0.33、四分类为 0.25,只有相对随机水平的提升幅度才能反映模型是否真正学到了东西。
给开发者的具体建议
基于现有信息,可以给出以下行动清单:
- 先跑单任务基线,确认数据本身可学习。
- 检查损失权重,打印每个任务的损失值,观察是否有一个任务主导。
- 尝试加载预训练权重(即使是在类似数据上预训练的模型)。
- 增加模型容量,但注意过拟合。
- 如果任务之间相关性弱,考虑减少共享层,增加任务特定层。
开发者提供的 Notebook 和模型链接可以让社区更直接地复现问题。如果能在帖子中补充任务类型、数据规模、损失曲线等信息,会更容易获得针对性帮助。
总结
多任务模型准确率停滞在 0.40 并非罕见问题,通常需要从数据、模型结构、预训练和损失平衡四个维度系统排查。这位开发者的求助帖提供了一个典型的调试场景,也提醒我们在多任务学习中,基线对比和损失监控是不可省略的步骤。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。