多语言语音识别扩展:源感知适配与模型合并策略
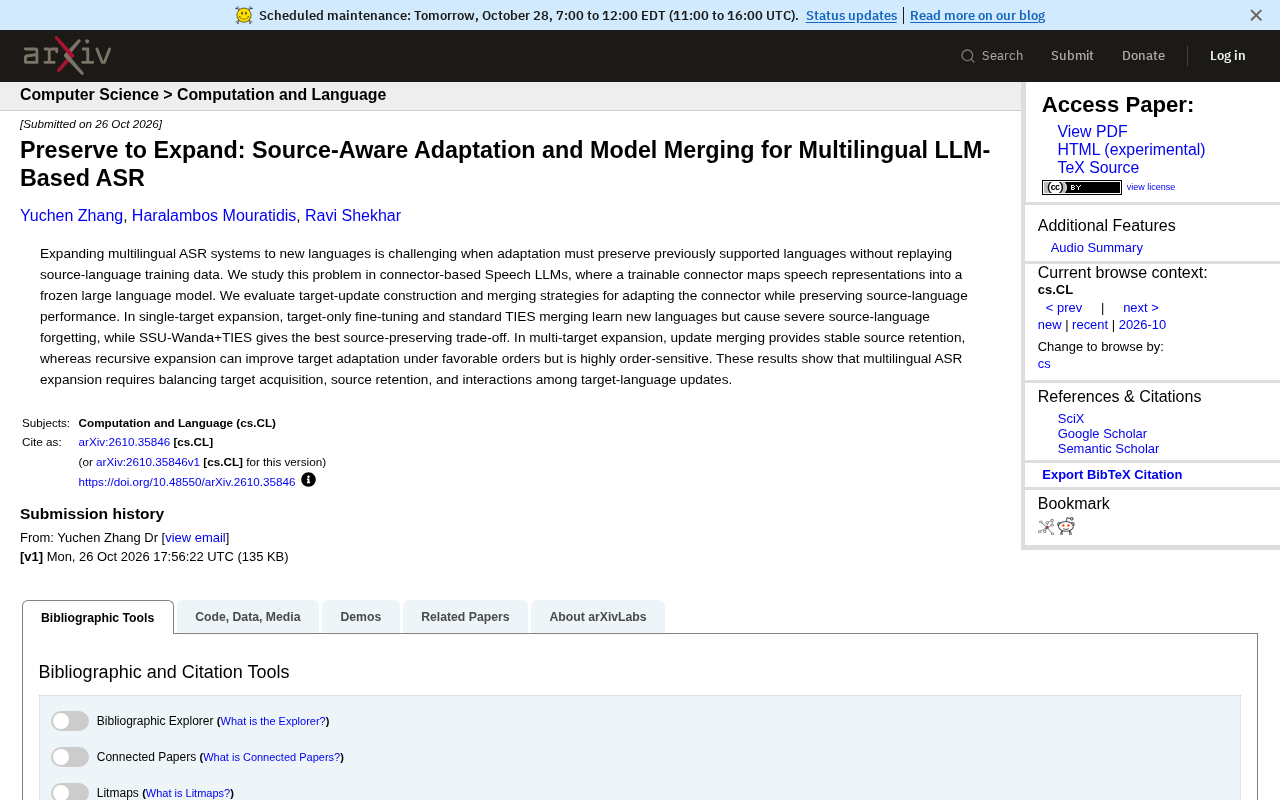
研究提出SSU-Wanda+TIES合并策略,解决多语言语音LLM扩展中的灾难性遗忘。
本文研究基于连接器的语音大语言模型在多语言扩展中的灾难性遗忘问题:仅微调连接器学习新语言会导致源语言性能严重下降。作者系统评估了多种更新构造与模型合并策略,在单目标扩展中发现SSU-Wanda+TIES在源语言保留与目标语言习得间取得最佳平衡;在多目标扩展中发现更新合并能稳定保留源语言,而递归扩展虽可能提升目标适配却对语言顺序高度敏感。研究揭示了目标习得、源保留与更新交互之间的权衡,为免源数据的多语言ASR持续扩展提供了实用指导。
多语言语音识别(ASR)系统向新语言扩展时,常面临一个两难:如何在不重放源语言训练数据的前提下,既学会新语言,又不遗忘已支持的语言?一篇来自rss的研究《Preserve to Expand: Source-Aware Adaptation and Model Merging for Multilingual LLM-Based ASR》深入探讨了这一问题,并提出了基于连接器(connector)的语音大语言模型(Speech LLM)的解决方案。
问题背景:连接器适配中的灾难性遗忘
在基于连接器的语音大语言模型中,一个可训练的连接器将语音表示映射到冻结的大语言模型(LLM)中。这种架构的好处是LLM本身无需微调,只需训练连接器即可实现语音识别。然而,当系统需要扩展新语言时,仅对连接器进行微调(target-only fine-tuning)虽然能让模型学会新语言,却会导致源语言性能严重下降——即灾难性遗忘。
研究团队聚焦于两个核心问题:如何构建目标语言的更新,以及如何通过模型合并策略在适配新语言的同时保留源语言能力。他们评估了多种更新构造与合并策略,并在单目标扩展和多目标扩展两种场景下进行了实验。
灾难性遗忘(Catastrophic Forgetting) 是神经网络持续学习中的经典问题:当模型在新任务上训练时,参数更新会覆盖或干扰先前任务学到的知识,导致旧任务性能急剧下降。在连接器-based语音LLM中,由于LLM本身冻结、仅连接器可训练,遗忘集中发生在连接器参数上——新语言微调会大幅改变连接器对源语言语音特征的映射方式。缓解策略通常包括参数正则化(如EWC)、数据重放(需源数据)、参数隔离与模型合并等。本文探索的免源数据路径属于参数隔离与合并的范畴,即分别获得目标语言更新后,再与源模型合并以恢复源语言能力。
连接器(Connector) 是连接语音编码器与冻结大语言模型的中间模块,通常是一个轻量适配器(如线性层、MLP或Q-Former),负责将语音编码器输出的声学表示映射为LLM可理解的嵌入序列。由于LLM参数完全冻结,连接器成为唯一可训练部分,参数量远小于LLM,因此微调成本低、不易破坏LLM的语义能力。但在多语言扩展中,连接器容量有限,新语言的学习容易挤占源语言的映射空间,这正是本文选择连接器作为适配与合并对象的架构背景。
单目标扩展:SSU-Wanda+TIES 表现最佳
在单目标扩展场景中,研究者比较了三种方法:仅目标语言微调(target-only fine-tuning)、标准的TIES合并,以及SSU-Wanda+TIES。结果显示,仅目标微调和标准TIES合并虽然能学习新语言,但都造成了严重的源语言遗忘。而SSU-Wanda+TIES在源语言保留与目标语言习得之间取得了最佳平衡。
SSU-Wanda+TIES 结合了两种技术:SSU-Wanda 用于选择对源语言重要的参数进行保护,TIES 则通过合并多个更新来减少干扰。这种组合策略有效缓解了遗忘问题,同时保持了新语言的学习效果。
TIES(Trim, Elect Sign, Merge) 是一种模型合并方法,用于将多个微调更新合并回基础模型而不显著损失性能。其流程分三步:先对每个更新向量进行裁剪(Trim),只保留幅度最大的部分参数以降低噪声;再对冲突参数进行符号选举(Elect Sign),按多数更新方向决定最终符号;最后只合并与选举符号一致的参数(Merge)。TIES能有效减少多个更新之间的参数干扰,在本文中被用于合并源语言保护后的更新与目标语言更新。
Wanda 是一种基于权重与激活幅度的稀疏化/重要性评分方法,通过 |权重| × ||激活|| 衡量参数重要性。本文的 SSU-Wanda 在此基础上引入源语言(Source-Specific Update)信息,识别对源语言性能关键的参数并加以保护,从而在合并时优先保留源语言知识。两者结合形成 SSU-Wanda+TIES 策略。
多目标扩展:更新合并稳定,递归扩展依赖顺序
在多目标扩展场景中,研究者发现更新合并(update merging)能够提供稳定的源语言保留效果,但递归扩展(recursive expansion)在有利的顺序下可以提升目标语言适配,却对顺序高度敏感。这意味着,当需要同时扩展多个语言时,合并策略比递归策略更可靠,而递归策略虽然潜力更大,但需要精心设计语言扩展的顺序。
这一发现揭示了多语言ASR扩展中的一个关键权衡:目标语言习得、源语言保留以及目标语言更新之间的相互作用。研究结果表明,没有一种策略能在所有场景下胜出,实际部署时需要根据具体需求(如语言数量、顺序重要性)进行选择。
更新合并(Update Merging) 与 递归扩展(Recursive Expansion) 是多目标场景下的两种策略。更新合并指为每个目标语言独立计算相对于源模型的参数更新,再一次性或分批合并到源模型中,各语言更新互不干扰,因此源语言保留稳定。递归扩展指按顺序逐个添加语言:每学完一种语言,以其结果为起点继续学下一种,前序语言的知识会被后续更新覆盖或干扰,因此对语言顺序高度敏感——有利顺序可借助正迁移提升效果,不利顺序则加剧遗忘。这一区别解释了文中“合并稳定、递归敏感”的结论。
启示与展望
该研究为基于LLM的多语言ASR系统扩展提供了实用指导。对于希望添加新语言而不影响现有语言性能的开发者,SSU-Wanda+TIES 是一种值得尝试的方案;而对于需要同时扩展多种语言的情况,更新合并比递归扩展更稳健。未来,如何自动优化扩展顺序、进一步减少对源语言数据的依赖,仍是值得探索的方向。
总体而言,这项工作强调了在多语言ASR扩展中平衡目标习得、源保留和更新间交互的重要性,为语音大语言模型的持续学习提供了新思路。
相关推荐
CodeMode:让AI代理写代码代替调用工具,token成本直降90%
探索CodeMode如何让AI代理通过编写代码在沙箱中执行,替代传统逐个调用工具的方式,从而减少token消耗高达90%,并分析其实现要点与适用场景。
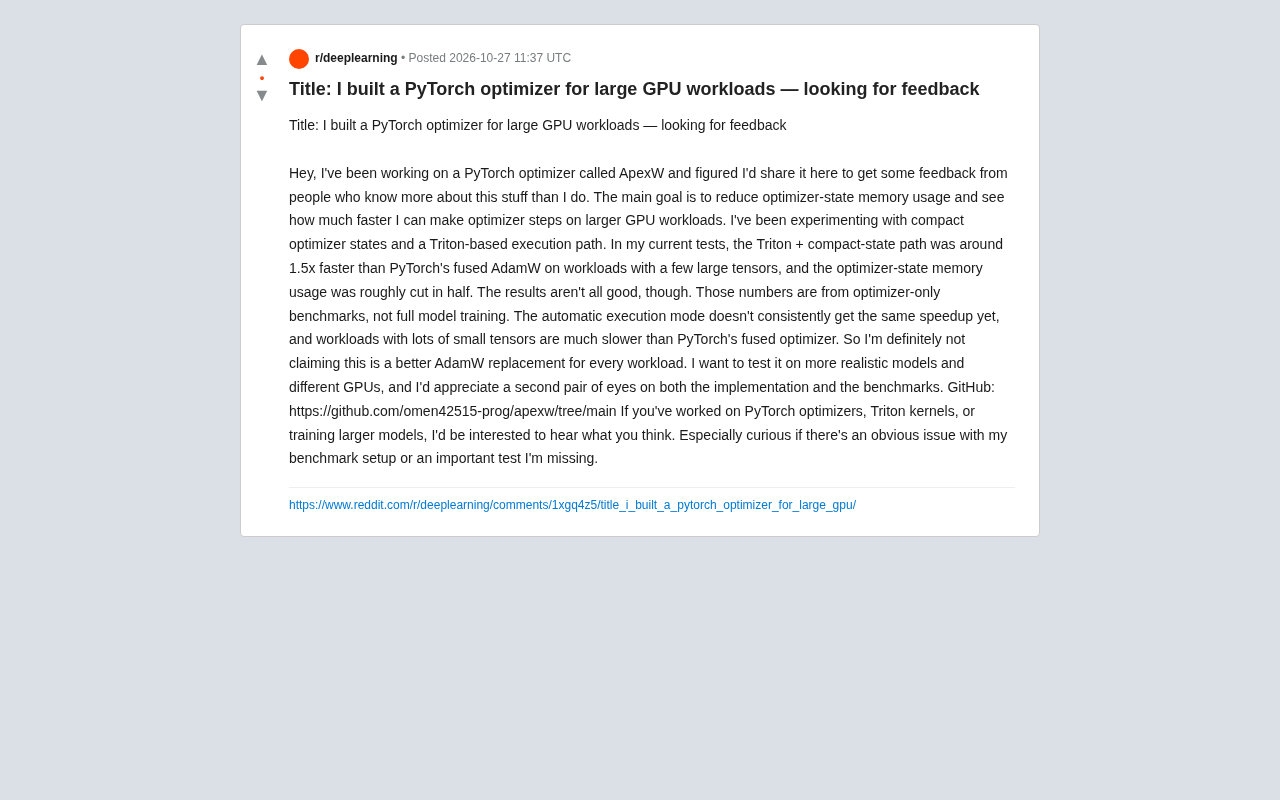
开发者自研PyTorch优化器ApexW:显存减半、提速1.5倍
开发者发布PyTorch优化器ApexW,采用紧凑优化器状态与Triton执行路径,在仅优化器基准中比fused AdamW快约1.5倍、状态显存约减半,但小张量与自动模式仍有明显短板,作者公开征集基准与实现反馈。
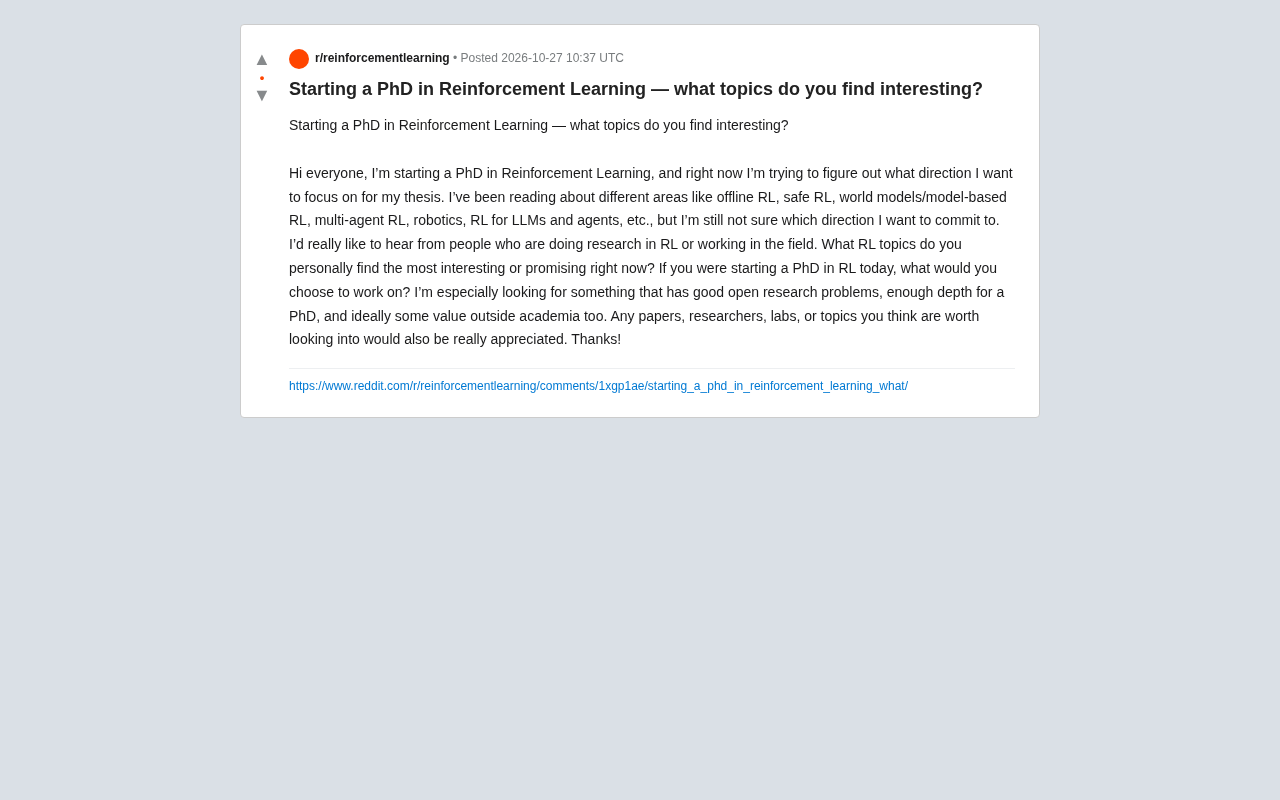
RL博士研究方向怎么选?六大前沿领域深度解析
RL博士研究方向怎么选?本文深度解析RL for LLMs、离线RL、安全RL、世界模型、多智能体RL和机器人RL六大前沿方向的开放问题、优势与风险,并提供兴趣匹配、产业价值平衡、导师匹配和技能可迁移性四个选择框架,帮助博士生做出明智决策。