多元代理:用AI代表放大公众政策参与

多元代理让AI替个体参与政策审议,实验证明有效但影响力受提示词左右。
文章介绍了一项关于「多元代理」的研究:这类 AI 代理代表具体个体参与 AI 政策审议,旨在把远多于少数专家所能覆盖的多元视角带入讨论,尤其适用于需要专业训练或依赖私有信息、公众难以直接参与的议题。实验表明,代理能可靠地把政策推向其所代表人设偏好的方向,但影响力大小对提示词风格高度敏感——被指示更啰嗦或更不配合时影响力更大,这构成方法本身的风险面。在 746 人的预注册研究中,参与者普遍认为代理有用且公平,并更偏好代理方案而非向单一 AI 模型提供输入的基线;但多数人仍更愿意亲自参与,代理分别回收了 68% 的满意度差距和 82% 的公平性差距。研究者因此建议谨慎探索,将代理定位为人类输入的放大器而非替代品。
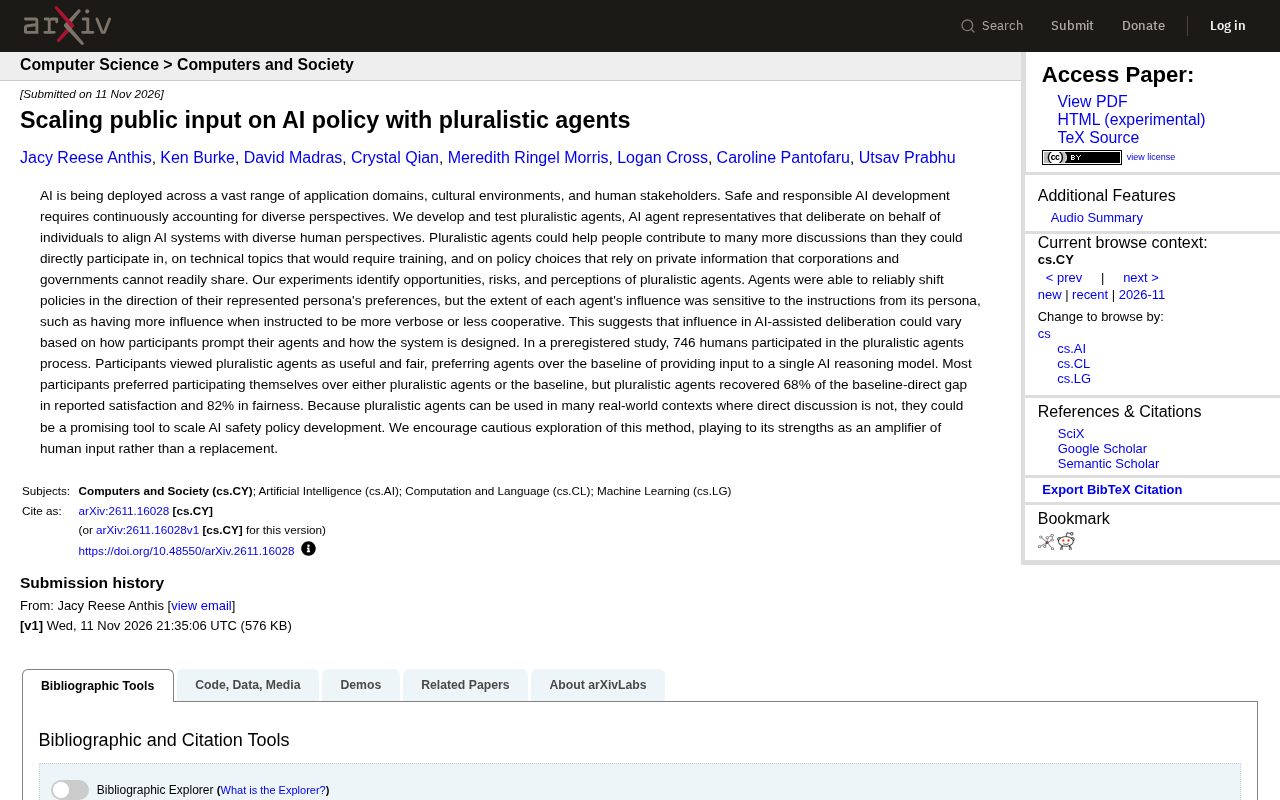
AI 正被部署到五花八门的应用领域、文化环境和利益相关者之中。要让 AI 安全、负责任地发展,就必须持续纳入多元视角。但现实是,公众很难直接参与每一场关于技术细节或政策取舍的讨论——有些话题需要专业训练,有些决策依赖企业和政府无法轻易公开的私有信息。一项新研究提出的「多元代理」(pluralistic agents)试图弥合这个缺口:让 AI 代理代表个体参与审议,把更多人的偏好带进 AI 政策讨论。
多元代理是什么,为什么需要它
多元代理是一类 AI 代理代表,它替某个具体的人参与讨论,目标是把 AI 系统对齐到多元的人类视角上。研究团队在论文中写道,这类代理可以帮助人们参与远多于自己所能直接参加的讨论,包括需要专业训练的技术话题,以及依赖私有信息的政策选择。
这背后的判断很直接:AI 的影响面太广,靠少数专家或单一模型拍板,很难反映真实世界的多样性。如果每个人都能有一个按自己偏好行事的代理去「代议」,公众输入的规模就有机会被放大。
预注册研究(Preregistration) 是指在数据收集和分析之前,研究者公开登记研究假设、方法、样本量和分析计划的科研规范。它的核心目的是防止「事后编故事」——即在看到结果后调整假设或筛选数据以得到显著结论(p-hacking、HARKing)。预注册研究通常会在独立平台(如 OSF、AsPredicted)留下带时间戳的记录,使审稿人和读者能核验研究是否按计划执行。本文的 746 人研究采用这一设计,意味着其结论在方法透明度上具有较高可信度,而非事后挑选的演示性实验。
人设(Persona) 在这里指为代理设定的角色描述与行为指令,包括该代理代表的个体偏好、立场以及表达风格(如「更啰嗦」或「更不配合」)。代理在审议中的发言与立场由人设驱动,因此人设既是代表个体偏好的载体,也是可被操控的影响力杠杆。
实验发现:代理能推动政策,但影响力可被「提示词」左右
研究团队通过实验检验了多元代理的实际表现。核心结论是:代理能够可靠地把政策推向其所代表的人设(persona)偏好的方向。但每个代理的影响力大小,对来自人设的指令相当敏感——比如被指示「更啰嗦」或「更不配合」时,代理的影响力会更大。
这个细节值得警惕。它说明在 AI 辅助的审议中,影响力可能取决于参与者如何提示自己的代理,以及系统如何设计。换句话说,代议效果不完全是中性的:谁更会写提示词,谁的代理就可能更占上风。这是方法本身需要正视的风险面。
提示词敏感性(Prompt Sensitivity) 指模型输出会随提示的措辞、长度、语气和格式而变化的现象。在大语言模型中,这既可能表现为答案准确率波动,也可能表现为输出风格和说服力的差异。本文发现的「更啰嗦或更不配合的指令会放大代理影响力」,正是提示词敏感性在多方审议场景中的体现:同样的立场,用不同的表达策略包装,可能获得不同的说服效果。这提示评估 AI 代理在审议中的表现时,不能只测「说了什么」,还要测「怎么说」如何影响结果,并在系统设计中考虑对提示风格进行约束或均衡。
746 人预注册研究:有用、公平,但人们仍想亲自参与
研究团队还开展了一项预注册研究,共有 746 名人类参与者走完了多元代理流程。参与者普遍认为多元代理有用且公平,并且更偏好代理方案,而不是「向单一 AI 推理模型提供输入」这一基线做法。
不过,多数参与者仍然更愿意自己参与,而不是使用多元代理或基线方案。即便偏好如此,多元代理在满意度上回收了基线直达差距的 68%,在公平性上回收了 82%。这两个数字说明:代理不能完全替代亲身参与,但能显著缩小「无法亲自参加」带来的体验落差。
基线(Baseline) 在对照实验中指用于比较的参照条件。本文的基线是「向单一 AI 推理模型提供输入」,即不经过个体代理、直接把参与者意见喂给一个通用模型。多元代理的评估指标「回收差距」正是相对这一基线计算的:满意度上回收 68%,意为代理方案把参与者满意度从基线水平向「亲自参与」水平拉近了 68% 的距离;公平性同理为 82%。这种「差距回收率」的表述比单纯的绝对评分更能说明代理在多大程度上弥补了无法亲身参与的损失。
应用前景与需要保持的谨慎
多元代理可以用在许多现实场景中,而这些场景恰恰是直接讨论难以实现的。正因如此,研究团队认为它有望成为扩展 AI 安全政策制定的工具。
但论文的态度是「谨慎探索」,而非全面推广。作者明确建议,要把这种方法当作人类输入的放大器,而不是替代品。结合实验中对提示词敏感性的发现,这一提醒尤其重要:如果设计不当,放大输入的机制也可能放大少数人的声音。
对关注 AI 治理的人来说,多元代理提供了一个可操作的思路——在无法让所有人坐到桌前时,用代理把更多偏好带进讨论。但它的公平性、可操控性和代表性边界,仍需在真实场景中持续检验。
核心要点
- 多元代理让 AI 代表个体参与政策审议,可扩展公众对 AI 政策的输入规模。
- 实验显示代理能可靠推动政策朝向人设偏好,但影响力受提示词风格影响。
- 746 人预注册研究中,参与者认为代理有用且公平,偏好代理胜过单一模型基线。
- 多数人仍更愿意亲自参与;代理回收了 68% 的满意度差距和 82% 的公平性差距。
- 研究者建议谨慎探索,把代理定位为人类输入的放大器而非替代品。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。