多智能体AI如何重塑故障排查:从日志到根因

将AI故障排查拆解为解析、假设、验证三阶段,用证据追踪替代黑箱式诊断。
本文介绍了一套基于多智能体架构的根因分析(RCA)系统,由日志解析器、假设生成器、证据验证器三个职责明确的AI智能体串联组成。系统以一个"全绿直到最后一步"的HTTP 403部署事故为案例,展示了如何将"观察、推理、验证"三个认知环节彻底解耦:解析器只提取可观测事实、不下结论,以防止锚定偏差污染后续分析;假设生成器并行生成多个竞争性解释;验证器则通过独立复现、环境对比和变更关联来检验假设,并在证据不足时如实暴露不确定性,而非制造虚假置信度。作者强调,该架构的核心价值不在于堆叠更多智能体,而在于构建可追溯的证据轨迹,使诊断错误时可回溯到提取、推理或验证哪一环出了问题。
当AI不只是解释错误,而是开始调查问题
大多数AI调试演示都从一条干净的错误信息开始,再给出一个自信满满的答案。但真实世界的线上事故远没有这么简单。
设想这样一个部署流水线:身份认证通过、资源创建成功、配置关联完成、后端就绪检查全部绿灯——直到最后一步,获取安装包下载链接时突然失败。日志里躺着一个 HTTP 403,JSON 解析器抱怨遇到了意料之外的字符。几种可能的原因看起来都站得住脚:是认证问题?网关故障?制品缺失?还是环境特定的配置差异?
正如项目作者 Vikram Boddupalli 在其开源项目 AI-Incident-Root-Cause-Analyzer 中所强调的:真正的挑战不是找到一个解释,而是判断哪个解释才是证据真正支持的那个。 这正是多智能体根因分析(RCA)架构试图解决的核心命题。
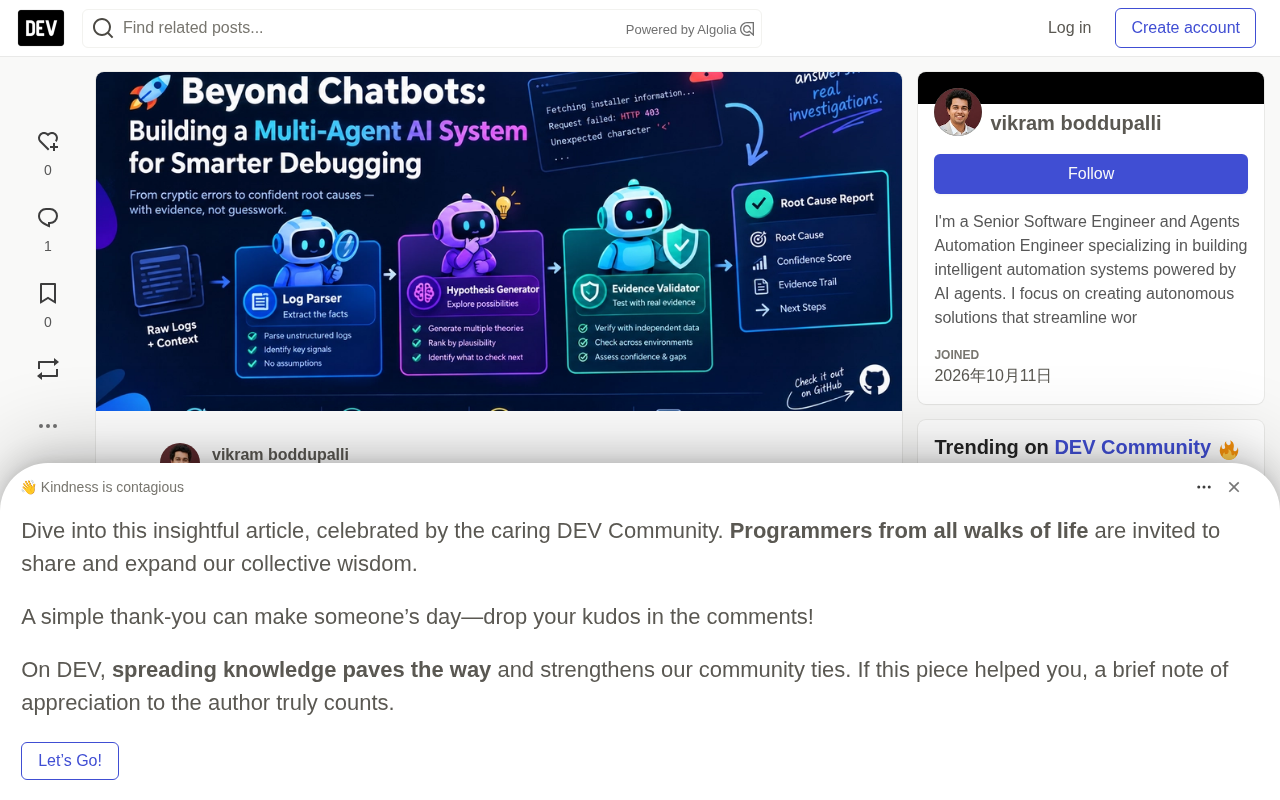
三个智能体,三种职责
与其让单个大语言模型(LLM)一口气完成整套诊断,不如把调查过程拆分为三个阶段,每个阶段只承担一项明确的责任。
- 🔍 日志解析器(Parser):我们知道什么事实?
- 🧠 假设生成器(Generator):有哪些可能的解释?
- 🛡️ 证据验证器(Validator):证据究竟支持哪一个?
这种划分的精妙之处在于,它把"观察""推理""验证"三个认知环节彻底解耦。流程从原始日志与事故上下文输入开始,依次经过解析、假设、验证,最终输出一份包含证据、置信度和后续步骤的根因报告。
多智能体系统(Multi-Agent System)是一种将复杂任务分解给多个相互协作的AI智能体的架构范式。每个智能体拥有独立的提示词(Prompt)、工具集和决策逻辑,只负责自身职责范围内的工作,最终由编排层(Orchestrator)将各阶段结果串联起来。这与"链式提示"(Prompt Chaining)的思路相近,但更强调职责边界的隔离——每个智能体的输出格式是下一个智能体的输入契约,任何一环的设计都可以独立迭代和测试,而不影响整条流水线。在RCA场景中,这种隔离尤为重要:如果让单个LLM同时承担"观察""推理""验证"三重角色,模型倾向于将早期推断作为后续推断的隐含前提,导致整个诊断在内部自洽却与实际证据脱节。
还原事故现场:全绿直到最后一步
回到那个典型案例。流程走到最后一步时抛出的错误被简化、脱敏后大致如下:
Fetching installer information...
Request failed: HTTP 403 Forbidden
Error: Unable to retrieve the download URL.
The response could not be parsed as valid JSON.
Unexpected character '<' at the beginning of the response.
第一眼看去,这像是个 JSON 解析问题。但有个线索藏在明处:响应以 < 开头,这通常意味着客户端期待拿到 JSON,实际收到的却是 HTML。那段 HTML 可能是访问拒绝页面、网关响应、代理错误或其他上游返回。
关键结论浮现:解析异常很可能只是故障的症状,而非根因本身。 如果只盯着 JSON 报错去修,很容易南辕北辙。
Agent 1:日志解析器——把噪声变成事实
第一个智能体不做诊断,只做提取。它的任务是把非结构化日志转化为结构化的事故摘要,且不引入任何假设。
对于上述案例,它提炼出的信号是:HTTP 状态码为 403 Forbidden;期望响应是 JSON;实际响应以 < 开头;失败操作是获取制品下载链接;失败点位于部署的最后阶段;初始范围锁定在特定环境和特定制品请求。
注意这里刻意"缺失"的东西——没有任何过早的结论。解析器不会说"认证坏了",它只记录日志实际显示的内容。
这一点至关重要。一旦早期阶段把问题贴上"认证失败"的标签,后续分析就会不自觉地偏向这个解释,形成锚定偏差。把提取与诊断分离,能让整个调查牢牢扎根于可观测的事实之上。
认知科学中的"锚定偏差"(Anchoring Bias)指人们在决策时过度依赖最先获得的信息,即使后续证据与之矛盾也难以修正判断。在故障排查中,这一偏差极为常见:工程师或AI系统一旦在早期将问题归类为"认证失败",就会优先寻找支持该结论的证据,而忽略指向其他方向的信号。将提取阶段与诊断阶段分离,在架构层面强制切断了这条偏差的传播路径——Parser只产出"发生了什么"的事实列表,不产出"为什么发生"的解释,从而确保后续智能体面对的是原始观察,而非已被染色的结论。
Agent 2:假设生成器——用可能性思考
第二个智能体接过结构化事实,生成多个相互竞争的解释,而不是锁死在第一个看似合理的答案上。
假设一:认证或授权失败
也许令牌过期、凭证失效,或请求缺少必要权限。403 状态码让这个假设成立。但状态码本身并不能告诉我们是哪个组件拒绝了请求、为什么拒绝。
假设二:网关、代理或中间层干扰
反向代理、网关、CDN 或安全层可能拦截了请求并返回了自己的 HTML 错误页。这能同时解释 403 和异常的响应格式,是个强力候选——但在拿到佐证前,它仍然只是假设。
假设三:制品可用性或配置问题
制品本身可能不可用、配置错误,或通过所选下载路径无法访问。即便失败发生在获取下载链接时,制品元数据和环境特定配置仍值得排查。
如何排序这些假设?
目标不是挑选最熟悉的解释,而是识别哪个假设最契合现有证据,以及还需要哪些额外检查来区分这些备选项。有用的证据包括响应头与 HTML 错误体、网关或代理日志、认证授权追踪,以及与其他环境成功请求的对比。
Agent 3:证据验证器——信证据,而非信心本身
调查到这里才真正有意思起来。一个合理的解释未必是正确的解释,第三个智能体要检验领先假设能否经受独立观察的考验。
检查一:在自动化流程之外复现故障。 用相同环境和等价授权上下文,通过独立路径重复同一请求。如果故障复现,说明问题不只存在于自动化代码路径中。
检查二:对比环境。 在其他环境中尝试获取同一制品、同一版本、同一平台。如果别处成功、唯独某个环境失败,就该深入排查环境特定权限、网关安全策略、路由代理配置、凭证与访问控制设置的差异。
检查三:关联近期变更。 审查故障开始前后的配置变更、凭证更新、路由修改和网关日志。有意思的是,"没有应用代码变更"是有用的上下文,但并不能证明应用及其依赖完全无关。
如果独立复现、环境对比和网关日志都指向同一解释,对该假设的置信度就随之上升。而如果关键证据缺失,报告就应如实说明。
没有证据,就不假装根因已确认。 这是一条重要的设计原则:AI 系统应当能够传达不确定性,而不是制造虚假的确定性。
为什么不用一次 LLM 调用搞定?
这是个公平的问题。对于总结日志或诊断简单错误,单次 LLM 调用完全够用。但面对复杂事故,分离职责能让整个过程更易检查、测试和改进。
| 单次 AI 调用 | 多阶段 RCA |
|---|---|
| 立即生成诊断 | 事实与假设分离 |
| 可能锚定在早期猜测上 | 对比竞争性解释 |
| 可能混淆观察与假设 | 显式追踪证据 |
| 可能在证据不足时显得笃定 | 暴露不确定性与缺失证据 |
| 往往返回扁平摘要 | 构建结构化调查轨迹 |
作者点出了一个容易被误解的关键:真正的创新不是堆更多的智能体,而是在观察、推理与验证之间划清边界。 他同时给出一条重要警示——多个智能体并不会自动提升系统准确性,它们可能共享同样的错误假设,而 LLM 生成的置信度分数也未必是经过校准的真实概率。价值来自把结论锚定在独立证据上,并让不确定性可见。
这套架构还能走向何方
这套方法并不局限于 HTTP 403 错误,同样适用于 CI/CD 流水线失败、Kubernetes 启动与就绪问题、API 认证授权故障、跨环境配置漂移、依赖失败与间歇性服务错误,以及自动化测试失败与回归。
更进一步,系统还能从历史事故中学习,识别反复出现的失败模式,并推荐有针对性的诊断检查。但原则始终不变:用历史模式生成线索,而不是用它替代验证。
对作者而言,多智能体 RCA 流水线最有价值的部分,从来不是那个最终答案,而是那条解释"为什么这个答案值得信任、以及还有什么需要核实"的证据轨迹。当一次根因分析出错时,工程师可以回溯整条调查链,判断问题究竟出在提取不完整、假设薄弱还是验证不足——可追溯性,正是这套架构相较于黑箱式单次诊断的最大红利。
根因分析(Root Cause Analysis,RCA)是软件工程与SRE(站点可靠性工程)领域的核心实践,目标是在事故发生后找到触发问题的根本原因,而非仅修复表面症状。传统RCA依赖"5个为什么"(5 Whys)、鱼骨图(Ishikawa Diagram)等结构化方法,引导工程师逐层追溯因果链。将AI引入RCA的挑战在于:LLM擅长模式匹配,却缺乏对因果关系的真正理解,容易将高度相关的现象误判为因果关系。因此,在AI辅助RCA系统中,让模型显式区分"相关证据"与"确认性证据",并在结论中标注置信度与待验证项,是防止误导性诊断的关键工程手段。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。