Dust项目探索:不用反向传播预训练Transformer

Dust项目探索无反向传播预训练Transformer,挑战深度学习核心训练范式,但仍处早期阶段。
Dust是一个试图在不使用反向传播的情况下预训练Transformer的早期研究项目,近期在Hacker News引发关注。反向传播虽是现代深度学习的基石,但其对中间激活值的大量缓存造成显著显存压力,且全局梯度传递带来的层间强耦合也使并行训练复杂化。Dust所代表的"无反向传播"或"局部学习"方向,与Hinton的前向-前向算法、目标传播等研究一脉相承,有望降低训练显存峰值、提升并行性并启发对学习机制的理论理解。然而该项目目前缺乏大规模基准验证与社区充分讨论,此类方法在真实预训练场景下能否与成熟反向传播方案竞争,仍是核心待解问题,需保持审慎态度。
一个挑战主流范式的尝试
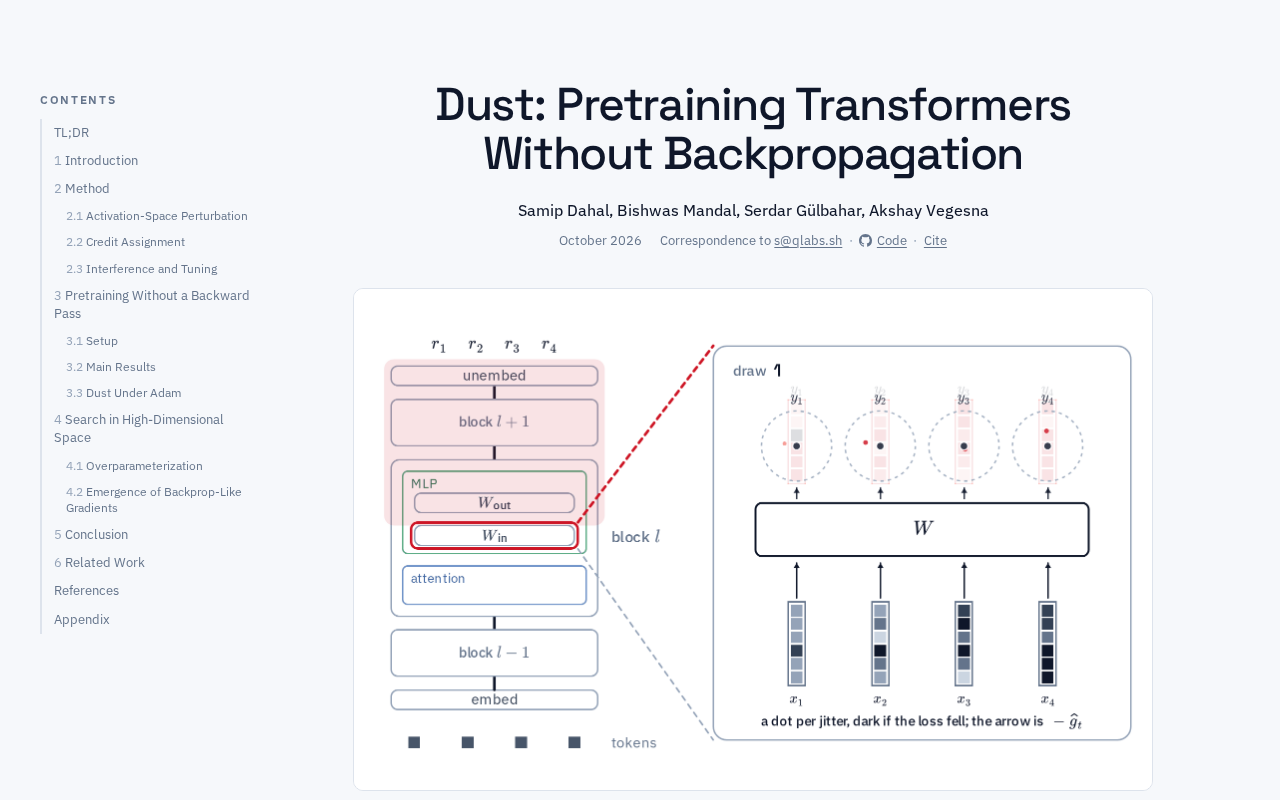
近日,一个名为 Dust 的项目在 Hacker News 上引发关注,其核心主张颇具颠覆性——尝试在**不使用反向传播(Backpropagation)**的情况下完成 Transformer 的预训练。对于长期依赖梯度下降与反向传播的深度学习领域来说,这是一个值得深究的方向。
反向传播自上世纪被引入神经网络训练以来,一直是现代深度学习的基石。无论是 GPT 系列大模型,还是各类视觉 Transformer,其参数更新几乎都离不开反向传播计算梯度这一环节。Dust 项目直接把矛头指向了这一默认设定,试图寻找替代路径。
为什么要绕开反向传播
反向传播虽然强大,但并非没有代价。它要求在前向计算时保存大量中间激活值,以便反向阶段计算梯度,这带来了显著的显存占用问题。在训练超大规模模型时,这往往成为硬件瓶颈之一。
此外,反向传播需要全局的梯度传递,层与层之间存在强耦合,这使得并行化与分布式训练在工程上更为复杂。学术界近年来也一直有人探索「无反向传播」或「局部学习(local learning)」的方法,例如前向-前向算法(Forward-Forward)、目标传播(Target Propagation)等,试图用更接近生物神经机制、或更节省资源的方式训练网络。
Dust 的出现,可以放在这一更大的研究脉络中理解:它代表了社区对训练范式多样化的持续探索,而非对现有方法的简单否定。
**前向-前向算法(Forward-Forward Algorithm)**由 Geoffrey Hinton 于 2022 年提出,核心思想是用两次前向传播替代一次前向加一次反向传播:第一次在"正样本"数据上运行,使每层的"goodness"度量增大;第二次在"负样本"数据上运行,使 goodness 减小。每层只依赖本层的局部信号更新权重,无需将梯度从输出层一路传回输入层。**目标传播(Target Propagation)**则是为每一层指定一个局部的"目标激活值",让各层分别最小化自身输出与目标之间的差距,同样避免了全局梯度链式求导。这两类方法都被认为在生物可信度(biological plausibility)上优于标准反向传播,因为大脑中并不存在精确的反向梯度信号传递机制,相关研究也因此吸引了神经科学与机器学习的交叉关注。
技术层面的潜在价值
如果一种无反向传播的预训练方法能够在 Transformer 上奏效,其意义可能体现在几个方面。
内存与算力效率
摆脱对完整计算图和中间激活的依赖,有望大幅降低训练时的显存峰值,让更大模型在有限硬件上成为可能,或让同等规模模型的训练成本下降。
反向传播之所以消耗大量显存,根本原因在于激活重计算(activation checkpointing)与中间张量缓存的权衡:标准训练需要在前向传播时将每一层的输出激活保存在显存中,供反向传播计算梯度时使用;对于一个百亿参数的模型,这些中间激活的显存占用往往与模型权重本身相当甚至更高。局部学习规则只需在当前层完成更新后即可丢弃其激活,理论上可将显存占用从 O(层数) 降至接近 O(1)(按层计),这对于在消费级 GPU 或边缘设备上训练大模型具有实际意义。
训练并行性
局部学习规则通常不需要等待全局梯度回传,各层可以更独立地更新参数,这为流水线并行和异步训练打开了新的空间。
理论与可解释性
探索非梯度的训练信号,也有助于研究者理解神经网络到底「学到了什么」,以及学习过程中真正起作用的机制。
需要保持的审慎态度
必须指出的是,截至目前这类项目仍处于早期探索阶段。Hacker News 上该帖子的讨论热度有限(15 个 points,暂无评论),尚缺乏社区的充分验证与同行讨论。
无反向传播方法长期以来面临的核心挑战在于:在大规模任务上,它们的最终性能往往难以匹敌成熟的反向传播训练。能否在真实的预训练场景下保持竞争力,是衡量此类方案价值的关键标尺。在看到严谨的基准测试与可复现结果之前,对其效果不宜过早下结论。
结语
Dust 项目之所以值得关注,不在于它是否能立刻取代反向传播,而在于它延续并推动了一个重要的开放性问题——深度学习是否存在更高效、更本质的训练方式。对于关注模型训练底层机制的开发者和研究者而言,这类项目提供了观察前沿探索的窗口。建议感兴趣的读者结合项目源码与相关论文进一步深入,以形成自己的判断。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。