俄语手写数学公式数据集:50题免费样本与4.5万美元商业版

Hugging Face上架俄语手写数学数据集,免费50题评估,完整版1740题售4.5万美元。
Hugging Face出现名为Tigran83/russian-university-math-handwriting的数据集,聚焦俄语手写数学文档识别与推理。免费样本含50道题,覆盖19个数学分支、49个主题、117页手写页面,提供手写图像、Word、PDF、Markdown、LaTeX等多格式配套。完整商业版含1740题、3450页手写解答、50603个公式和927个图形,定价4.5万美元,支持按分支选购。目标应用包括手写数学OCR、图像转LaTeX、LLM数学推理微调与多模态文档理解。数据仅限俄语,手写与打字版按题目对齐而非逐行对齐,题目原文来自第三方教育资料,商业使用需注意版权边界。
在AI模型争相攻克数学推理的当下,高质量的训练数据往往比模型架构更稀缺。Hugging Face上出现了一个名为Tigran83/russian-university-math-handwriting的数据集,专门瞄准俄语手写数学文档的识别与推理任务。它提供50道题的免费评估样本,同时出售包含1740道题的完整商业版本,标价4.5万美元。
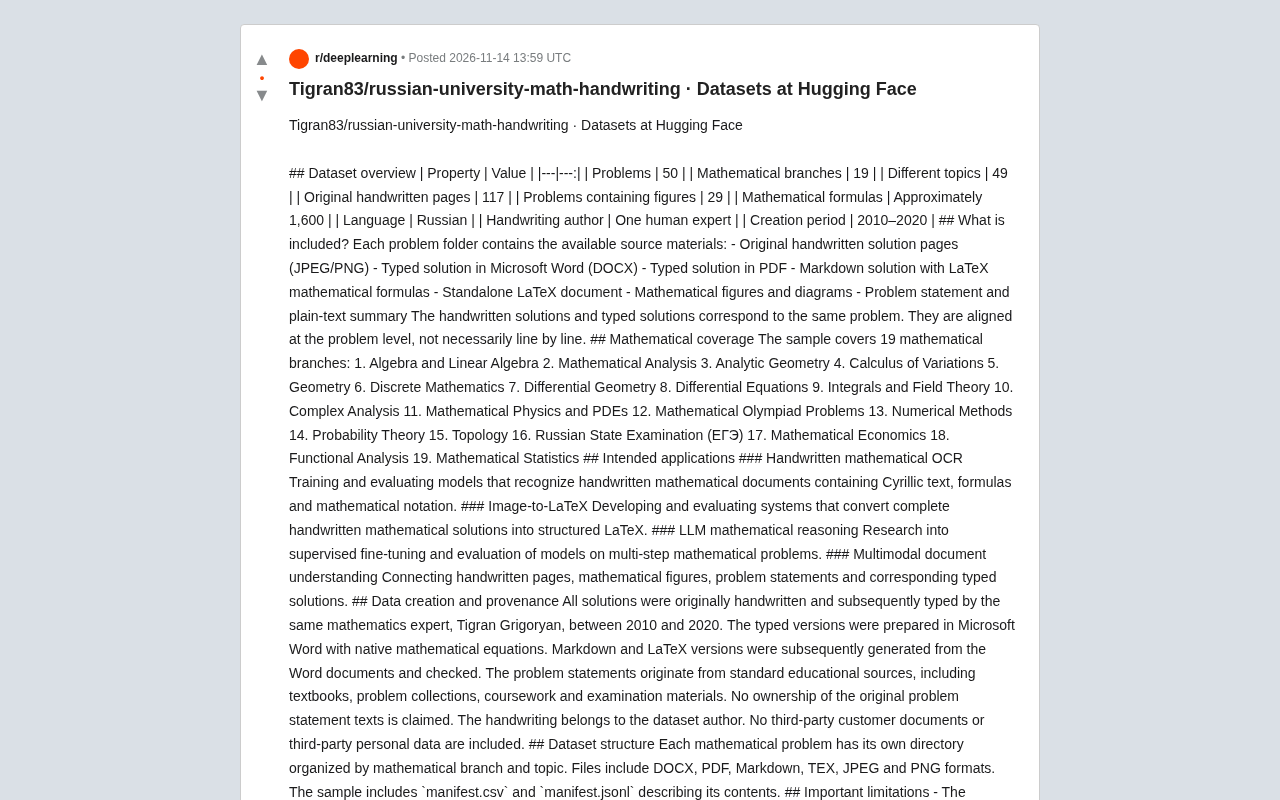
数据集概况:小而精的评估样本
根据数据集页面信息,免费样本包含50道数学问题,覆盖19个数学分支、49个不同主题,共117页原始手写页面,其中29道题配有图形,数学公式总量约1600个。所有手写内容出自同一位人类专家之手,创作时间跨度为2010至2020年,语言为俄语。
每道题的文件夹里存放了多种格式的配套材料:原始手写解答页(JPEG/PNG)、Microsoft Word打字版解答(DOCX)、PDF、带LaTeX公式的Markdown文档、独立的LaTeX文档,以及数学图形和题目陈述的纯文本摘要。手写版与打字版按题目对齐,不要求逐行对应,这种设计对训练图像到文本的映射足够友好,但也意味着细粒度的行级对齐任务需要额外处理。
图像到文本映射与行级对齐:图像到文本映射指模型学习将整幅手写页面的视觉内容转换为对应的文本序列,通常以整页或题目为单位进行监督,不要求像素级或行级的一一对应。行级对齐则要求手写图像中的每一行与转录文本中的每一行精确匹配,常用于版面分析、行分割和细粒度OCR评估。本文数据集按题目配对而非逐行配对,意味着它适合训练整页到文本的生成模型,但若用于行级检测或阅读顺序恢复任务,需要额外通过版面分析或强制对齐算法生成行级标注。
覆盖19个数学分支的广度
样本的数学覆盖面相当宽,从代数、线性代数、数学分析、解析几何,到变分法、微分几何、微分方程、复分析、数学物理与偏微分方程,再到拓扑学、泛函分析、数值方法、概率论与数理统计。此外还包含离散数学、积分与场论、数学奥林匹克题、俄罗斯国家统一考试(ЕГЭ)以及数学经济学的内容。
这种广度对于评估模型的泛化能力很有价值——模型不能只靠微积分或线性代数的常见符号模式蒙混过关,得真正处理拓扑学或泛函分析中不常见的记号与表达习惯。
四类目标应用场景
数据集页面明确列出了四个方向。手写数学OCR是首当其冲的用途:训练和评估能够识别含西里尔字母文本、公式和数学记号的手写文档的模型。其次是图像到LaTeX的转换,要求系统将完整的手写解答转换为结构化的LaTeX代码。第三是LLM数学推理,可用于对模型进行监督微调,并在多步数学问题上做评估。第四是多模态文档理解,把手写页面、数学图形、题目陈述与对应的打字解答连接起来。
这四个场景指向同一个痛点:现有OCR和多模态模型在处理非拉丁字符体系的手写数学内容时表现往往不够稳定。俄语手写体加上数学符号的混排,对识别管线是双重考验。
西里尔字母与数学符号混排的识别难点:西里尔字母与拉丁字母在字形上存在大量相似但码位不同的字符(如俄语中的“А”与拉丁“A”),OCR模型容易混淆。数学符号则包含大量结构化的二维布局(分式、上下标、根号、矩阵),其识别不仅依赖字符分类,还依赖版面结构和语法关系。两者混排时,模型需要同时处理字符集扩展、字体风格差异和公式结构解析,导致现有以拉丁字符为主的OCR管线在俄语手写数学文档上准确率下降。
数据来源与版权边界
所有解答最初均为手写,随后由同一位数学专家Tigran Grigoryan在2010至2020年间打字录入。打字版使用Microsoft Word原生公式编辑器制作,Markdown和LaTeX版本从Word文档生成并经过核对。题目陈述来自标准教育来源,包括教科书、习题集、课程作业和考试材料,数据集作者未主张对题目原文的所有权。手写内容归作者本人所有,且不含第三方客户文档或第三方个人数据。
Microsoft Word原生公式编辑器与LaTeX转换:Word原生公式编辑器(OMML)使用线性格式和结构化标记存储公式,与LaTeX的语法体系不同。从DOCX生成Markdown和LaTeX版本通常需要经过OMML到LaTeX的转换工具或手动核对,转换过程中可能出现符号映射错误、上下标丢失或分式结构变形。数据集作者声明转换后经过核对,但使用者仍应意识到不同格式版本之间可能存在细微差异,尤其在复杂公式或自定义记号上。
必须注意的限制
数据集页面坦诚列出了若干限制。数据仅限俄语;手写版与打字版按题目配对而非逐行配对;手写页面的分辨率和书写风格可能不一致;样本仅用于评估和研究,不可再分发;部分题目陈述源自第三方教育资料。这些限制意味着,直接拿它做商业产品的训练数据存在合规风险,尤其是题目原文的版权归属并不在数据集作者手中。
免费样本与商业版的差异
免费仓库只提供50题的评估样本,使用受SAMPLE_LICENSE.md条款约束,不允许无限制再分发或用于商业训练。完整商业数据集包含1740道数学问题、3450页手写解答、50603个数学公式、927个数学图形,覆盖19个分支127个主题,数据量约2.2GB,格式涵盖DOCX、PDF、Markdown、LaTeX、JPEG和PNG。
完整数据集定价4.5万美元,也支持按数学分支选购。商业许可为非独占的AI训练与评估授权,允许商业模型部署和发布训练后的模型权重,但不允许再分发原始数据。对于需要俄语手写数学数据的研究实验室或OCR开发团队,这是一个需要权衡成本的选择:样本足以做可行性验证,真正上量训练则要付费。
数据集作者Tigran Grigoryan来自亚美尼亚,以个人企业主身份提供该数据集,欢迎AI公司、OCR开发者、研究实验室和大学就商业授权、更大数据量或定制子集进行联系。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。