Earlybird:提前90ms预测单词的语音识别模型
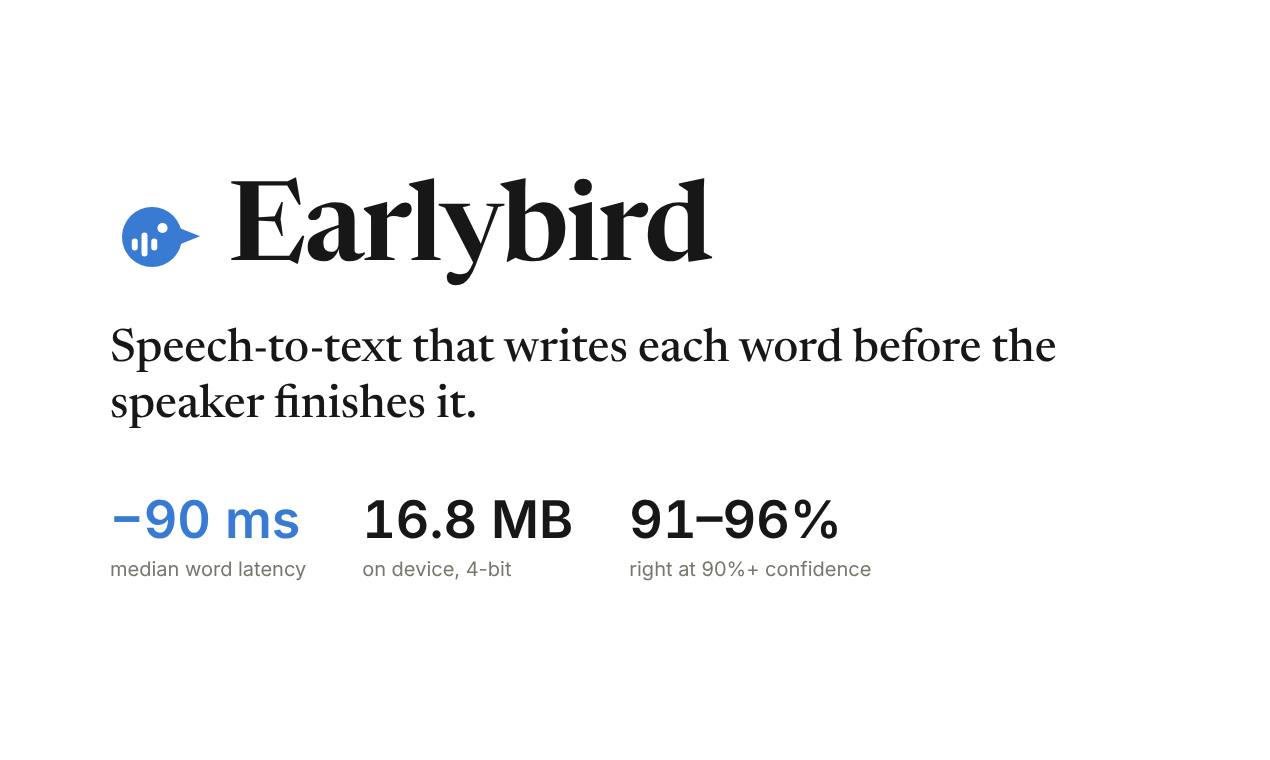
Earlybird 用 29M 参数端侧模型在词说完前 90 毫秒预测语音,压缩语音代理延迟。
Product Hunt 上的开源模型 Earlybird 提出一种反直觉的语音识别思路:不等单词说完,而是在说话者说完每个词之前约 90 毫秒就预测出该词,并为每个词附带置信度。模型仅 29M 参数、17 MB 体积,开放权重与代码,完全端侧运行,省去云端往返开销。提前预测配合置信度机制,让语音代理可以在高置信度时抢先启动下游意图理解与工具调用,从而压缩整体响应链条。文章也指出其边界:预测准确率受口音、语速、噪声影响,提前预测被推翻时需要回退容错设计,实际收益仍待集成方验证。
语音交互的体验瓶颈,往往卡在"等"这个字上。用户说完一句话,语音助手才开始处理,这中间的延迟感直接决定了对话是否自然。Product Hunt 上出现的一款开源模型 Earlybird,试图从源头改变这个节奏:它不等待单词说完,而是提前预测。
一个反直觉的设计:先说后听
Earlybird 的核心主张写在它的标语里——29M 参数的语音转文字模型,"在单词结束前输出单词"。具体来说,它能在说话者说完每个词之前约 90 毫秒就正确预测出该词,并且为每个词附带置信度。
这个时间窗口看似微小,但对语音代理(voice agent)的意义不同。传统流式语音识别是"边听边转",但本质上仍在等待音素完整落地;Earlybird 做的是"边听边猜",把预测行为提前到语音信号尚未完结的时刻。模型体积同样值得注意:17 MB,完全端侧运行,开放权重与代码。
流式语音识别(Streaming ASR) 是指模型在音频持续输入的过程中同步输出文字,而不是等整段录音结束后再转写。传统流式方案通常依赖 CTC(Connectionist Temporal Classification)或 RNN-T 等结构,按帧或按音素块逐步解码,但解码单元仍然要等到对应音素基本完整才输出。Earlybird 的区别在于把预测时机进一步前移:在词尚未说完时就给出候选词及其置信度,相当于在流式识别之上叠加了一层“前瞻预测”,因此它输出的文字可能早于声学证据完全落地,需要用置信度来管理这种不确定性。
为什么提前 90 毫秒很重要
人类对话的轮转间隙通常在几百毫秒量级。语音助手如果每次都要等用户彻底说完、再完成识别、再启动推理,累积延迟会让交互显得迟钝。把单词预测提前 90 毫秒,意味着下游的意图理解、工具调用可以更早启动,整体响应链条被压缩。
更关键的是"每个词都有置信度"这个设计。提前预测天然带有不确定性,置信度给了系统一个决策依据:高置信度时可以抢先行动,低置信度时继续等待。这让"提前"不等于"冒险",而是变成一种可控的权衡。
轮转间隙(turn-taking gap) 是对话分析中的概念,指一方说话结束到另一方开始发声之间的停顿,日常人类对话中通常在 200 毫秒上下。语音代理要显得自然,端到端响应延迟最好接近这一量级。但完整链路包含语音端点检测、ASR 解码、意图理解与工具调用,每一环都会累加延迟。Earlybird 把词级预测提前约 90 毫秒,等于为下游环节争取了额外预算;配合逐词置信度,系统可以在高置信度时提前触发意图解析,低置信度时继续监听,从而在不牺牲准确率的前提下压缩感知延迟。
29M 参数与 17 MB 的工程取舍
在动辄数十亿参数的语音模型时代,29M 参数是一个刻意的克制。17 MB 的体积意味着它可以跑在端侧设备上,不依赖云端往返。对于需要低延迟的语音代理场景,端侧推理省掉的网络开销,可能比模型本身的优化更直接。
开放权重和代码则降低了验证门槛。开发者可以直接在自己的语音管线上测试提前预测的实际收益,而不必先相信厂商的基准数字。
端侧推理(on-device inference) 指模型直接运行在手机、PC 或嵌入式设备上,而非调用云端 API。其优势是省去网络往返(通常几十到数百毫秒)并保护隐私,代价是受限于设备的算力、内存与功耗。17 MB 的模型体积对于端侧部署非常友好,可以常驻内存甚至嵌入浏览器或移动应用;但也意味着模型容量有限,在嘈杂环境、多口音或专业术语场景下的鲁棒性需要实测验证。开放权重让团队可以在自己的数据上微调或做蒸馏,以适配特定垂直场景。
适用边界与现实约束
需要冷静看待的是,提前预测的准确率与语种、口音、语速强相关。90 毫秒的提前量在受控条件下成立,真实场景中的嘈杂环境、非母语发音、连贯语流下的连读,都可能影响预测命中率。置信度机制能缓解部分问题,但它本质上是一个概率工具,不是确定性保证。
另一个现实问题是:提前预测出的词如果被后续音频推翻,系统如何处理回退?这对下游应用的容错设计提出了新要求。Earlybird 提供的是能力,如何用好仍取决于集成方。
谁应该关注它
最直接的受益者是构建实时语音代理的团队——客服机器人、语音助手、实时字幕、会议转录等场景,都对"更早拿到文字"有真实需求。端侧部署的特性也让隐私敏感型应用多了一个选项。
对于研究者,这个模型提供了一个有趣的样本:在参数规模与延迟之间,存在一条不同于"堆大模型"的路径。开放权重意味着可以拆开看它到底怎么做到的。
Earlybird 目前在 Product Hunt 上获得 71 票、排名第 18,讨论热度不算高,但它指向的方向值得留意:语音交互的下一轮竞争,可能不在于识别得多准,而在于识别得多早。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。