Eight Sleep 推出 Pod 6 智能床垫:更小尺寸、单人版本,售价 1999 美元起

Eight Sleep Pod 6 新增单人版及更小尺寸,起售 1999 美元,温控速度提升 20%。
Eight Sleep 发布新一代智能床垫 Pod 6,最大亮点是引入更小规格与专为单人设计的版本,起售价降至 1999 美元,试图扩大智能睡眠产品的受众群体。在性能层面,官方宣称水循环温控系统的响应速度较上一代提升 20%,可更快达到用户设定的目标温度,提升入睡舒适度。产品线的细分化覆盖了小户型、单人居住等更多使用场景,也在一定程度上回应了市场对更具性价比方案的需求。尽管 1999 美元的定价仍属高端区间,但相比此前动辄两三千美元起的整套方案,Pod 6 已明显拉低了入门门槛。
Eight Sleep Pod 6 发布:更多尺寸选择
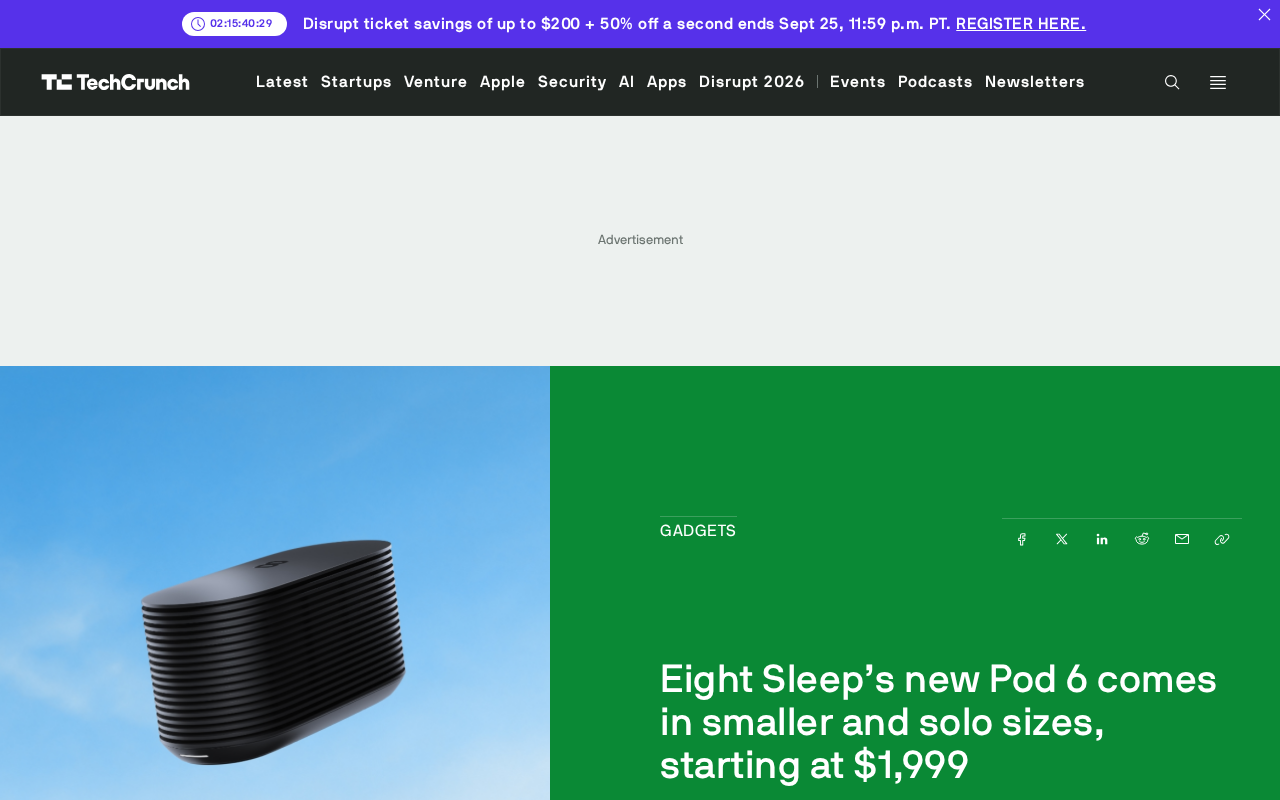
智能睡眠品牌 Eight Sleep 近日推出了新一代产品 Pod 6。相比前几代产品,Pod 6 最显著的变化在于提供了更加丰富的尺寸选择,包括更小的规格以及专为单人使用设计的版本,起售价格为 1999 美元。
这一定价策略意味着 Eight Sleep 试图降低智能睡眠产品的入门门槛。此前该品牌的产品往往因为高昂的价格而让不少潜在用户望而却步,此次通过引入单人版本,能够覆盖更多独居用户或希望个人化睡眠体验的消费者。
性能提升:温控速度提高 20%
根据 Eight Sleep 官方说法,新款 Pod 6 的运行速度比上一代快了 20%。对于智能床垫这类以温控为核心功能的产品而言,速度的提升通常意味着床垫能够更快地达到用户设定的目标温度,从而带来更即时、更精准的睡眠体验。
Eight Sleep 的核心技术在于通过水循环系统实现床垫的加热与制冷,并结合传感器监测用户的睡眠状态、体温变化等数据,动态调整床面温度。温控响应速度的加快,直接关系到用户入睡与睡眠过程中的舒适度体验。
Eight Sleep 的水循环温控技术(称为"Pod System")工作原理是:床垫内部铺设微细水管网络,通过床旁的"Hub"主机对水进行加热或制冷,再将特定温度的水泵入床垫循环流动,使床面温度维持在用户设定的区间内(通常可在 55°F–110°F / 13°C–43°C 之间调节)。这与传统电热毯依靠电阻丝发热的方式不同——水的比热容更高、温度分布更均匀,且安全性更好。配合内置传感器采集的心率、呼吸频率、体动等生理数据,系统可以在夜间自动调整温度曲线,例如在深睡期间适当降温以延长慢波睡眠时长。20% 的速度提升意味着 Hub 的水泵功率或热交换效率得到优化,能够在更短时间内将床面温度从室温拉升或拉降至目标值。
产品定位与市场意义
Eight Sleep 一直定位于高端智能睡眠市场,其产品将睡眠科技与健康监测结合,吸引了注重睡眠质量的科技爱好者与健康人群。此次 Pod 6 引入更小尺寸和单人版本,是产品线细分化的重要一步。
更小的尺寸和单人版本不仅拓宽了适用场景(如小户型、单人卧室、客卧等),也在一定程度上回应了市场对更灵活、更具性价比选择的需求。1999 美元的起售价虽然仍属高端定位,但相比过去的整套方案已经更具亲和力。
Eight Sleep 在智能床垫赛道并非没有竞争者,Sleep Number 的 Climate360 系列以及多款国内外主动温控床垫产品均瞄准类似人群。Eight Sleep 的差异化在于其软件订阅体系("Autopilot"服务,提供 AI 驱动的睡眠评分与温度自动调节),该订阅费用约为每年 199 美元,意味着使用 Pod 系列产品的总拥有成本需要将硬件与持续订阅一并计算。此次推出单人版本与更小尺寸,也可能是为了应对竞品在价格维度的压力,同时抢占单人家庭这一增量市场。
小结
Eight Sleep Pod 6 通过尺寸细分和性能升级,进一步完善了其智能睡眠产品矩阵。20% 的速度提升和更灵活的尺寸选择,是这一代产品的两大亮点。对于关注睡眠健康与智能家居的用户来说,Pod 6 提供了一个门槛更低的切入点。
(注:本文基于目前公开的有限信息整理,更多具体规格与实测表现有待进一步披露。)
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。