EI算法三大设计选择首次有理论支撑:收敛率指导仿真优化

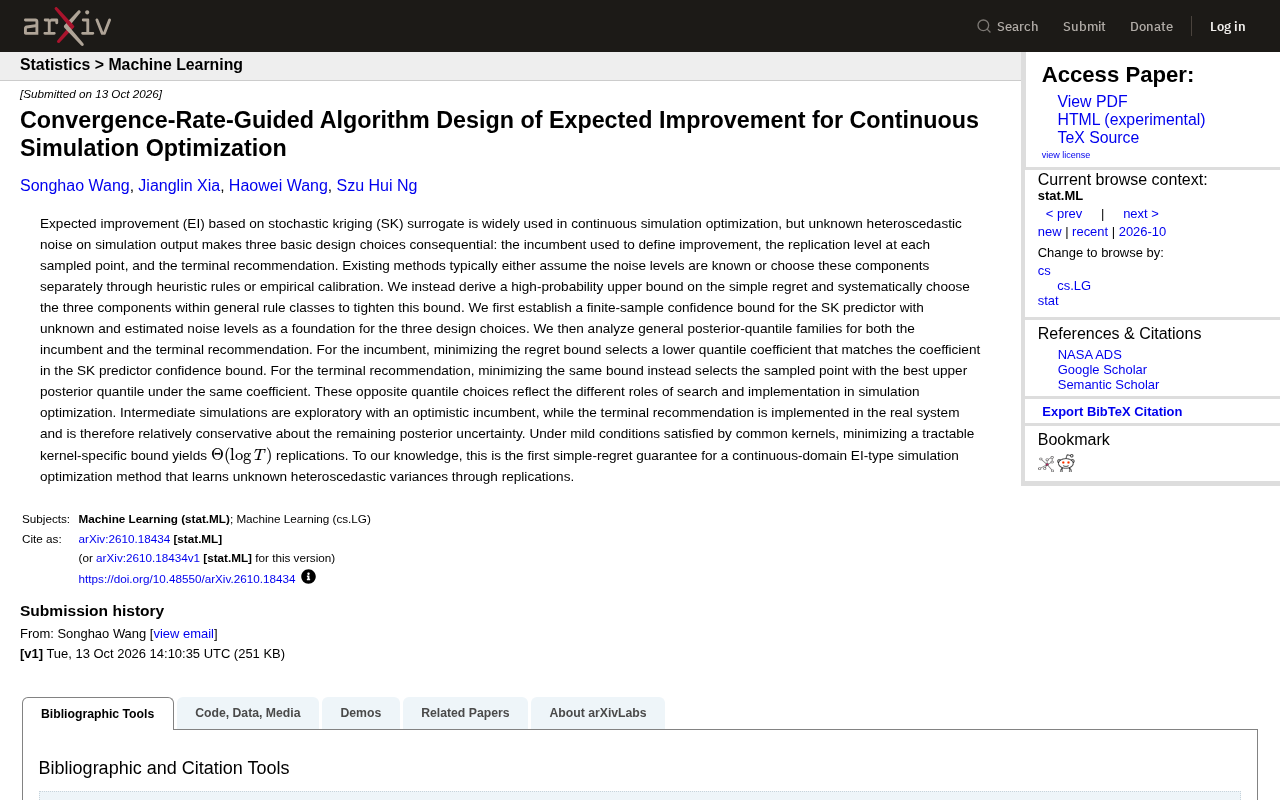
论文首次为连续域EI型仿真优化给出简单遗憾保证,统一确定incumbent、重复次数与终端推荐。
该研究针对连续仿真优化中基于随机克里金代理模型的期望改进(EI)方法,解决了长期存在的理论空白:仿真噪声未知且异方差,而EI的三个核心设计选择——incumbent、重复仿真次数与终端推荐——都依赖这些未知噪声。研究者通过推导SK预测器在噪声需估计时的有限样本置信界,进而分析incumbent与终端推荐的一般后验分位数族,发现最小化遗憾上界时incumbent应取较低分位数(乐观搜索),终端推荐应取上分位数(保守交付),二者方向相反。在常见核函数条件下,重复仿真次数的最优增长率为Θ(log T)。这是首个针对连续域EI型仿真优化方法的简单遗憾保证,将原本割裂处理的三个设计选择纳入统一收敛率分析框架,且能通过重复仿真学习未知的异方差方差。
在连续仿真优化(continuous simulation optimization)中,基于随机克里金(Stochastic Kriging, SK)代理模型的期望改进(Expected Improvement, EI)方法被广泛使用。但这套方法长期面临一个尴尬的现实:仿真输出的噪声水平通常是未知且异方差的,而EI算法的三个核心设计选择——用来定义"改进"的当前最优值(incumbent)、每个采样点的重复仿真次数(replication level)、以及最终推荐点(terminal recommendation)——都严重依赖这些未知噪声。
现有做法要么假设噪声水平已知,要么通过启发式规则或经验校准分别选取这三个组件。一篇最新研究论文打破了这一局面:研究者推导出简单遗憾(simple regret)的高概率上界,并在一般规则类中系统性地选择这三个组件来收紧该上界。据称,这是首个针对连续域EI型仿真优化方法的简单遗憾保证,且能通过重复仿真学习未知的异方差方差。
三个设计选择为何如此关键
EI方法的核心逻辑并不复杂:用代理模型拟合仿真输出,然后选择预期改进最大的点进行下一次仿真。但在噪声未知的仿真场景中,每一步都变得棘手。
incumbent决定了"改进"的基准线。选得太乐观,算法会过度探索;选得太保守,则可能过早收敛到次优解。重复仿真次数同样是个两难——次数太少,噪声淹没信号;次数太多,计算预算被浪费。终端推荐则是最终交付给决策者的答案,它的质量直接决定了整个优化过程的实际价值。
论文指出,这三个选择在现有方法中通常被割裂处理,缺乏统一的理论框架来指导。
随机克里金(Stochastic Kriging, SK) 是普通克里金(Kriging)代理模型在噪声场景下的推广。普通克里金假设观测值无噪声,插值曲面严格穿过所有样本点;而随机克里金把每个观测建模为「真实函数值 + 随机噪声」,因此预测器输出的不仅是均值估计,还有后验方差。这一区别在仿真优化中至关重要:仿真输出天然带噪,若强行用无噪声克里金拟合,会过拟合到噪声上。随机克里金通常假设噪声服从高斯分布,并区分「同方差」(各点噪声方差相同)与「异方差」(各点噪声方差不同)。本文所面对的正是后者——噪声方差未知且随输入位置变化,这也是EI三个设计选择难以统一处理的根源。
期望改进(Expected Improvement, EI) 是贝叶斯优化中的经典采集函数。给定代理模型的后验分布和当前最优值 incumbent,EI 计算的是「在某个候选点采样后,相对于 incumbent 可能取得的改进量的期望」。其直觉是:后验均值高(该点可能更优)或后验方差大(该点信息量大)的点都会获得较高的 EI 值,从而自然平衡探索与利用。EI 通常有解析表达式,计算高效,因此在连续仿真优化中被广泛采用。但当噪声方差未知时,EI 中涉及 incumbent 的比较本身带噪,就需要额外的重复仿真与估计机制来支撑,这正是文章讨论的难点所在。
从遗憾上界反推算法设计
研究者的思路是"以终为始":先建立SK预测器在噪声水平未知且需要估计时的有限样本置信界,以此作为三个设计选择的理论基础。
随后,他们分析了incumbent和终端推荐的一般后验分位数族。关键发现是:最小化遗憾上界时,incumbent应选择较低的分位数系数,且该系数恰好与SK预测器置信界中的系数匹配;而终端推荐则应选择同一系数下后验上分位数最优的采样点。
这两个看似矛盾的分位数选择,实际上反映了仿真优化中"搜索"与"实现"的不同角色。中间仿真步骤是探索性的,采用乐观的incumbent有助于充分搜索;终端推荐则要在真实系统中实施,因此对剩余的后验不确定性保持相对保守。
简单遗憾(simple regret) 是衡量优化算法最终推荐解质量的指标,定义为最优解的真实函数值与算法推荐解的真实函数值之差。与之相对的是累积遗憾(cumulative regret),后者度量的是整个搜索过程中每一步决策的累计损失。简单遗憾关心「最后交出的答案有多好」,而仿真优化面向的往往正是一次性决策——找到一组最优参数后交付实施,因此简单遗憾是更贴切的评价标准。本文推导的是简单遗憾的高概率上界,即「以至少 1−δ 的概率,遗憾不超过某个关于轮数 T 的表达式」,这类保证比期望意义下的界更强,也更能指导具体设计。
后验分位数(posterior quantile) 指的是在代理模型的后验分布中取某分位点对应的函数值。选取上分位数意味着采用较乐观的估计(认为真实值可能偏高),选取下分位数则偏保守。文章的核心洞见正是通过分位数系数来统一刻画 incumbent 与终端推荐:incumbent 取较低分位数以保持搜索的乐观性,而终端推荐取上分位数以对剩余不确定性保持保守。分位数系数与 SK 置信界中的系数相匹配,使得三个设计选择在同一理论框架下自洽。
重复仿真次数的理论解
在常见核函数满足的温和条件下,最小化一个可处理的核特定上界,可以得到重复仿真次数为 Θ(log T)。
这个结果的意义在于,它给出了重复仿真次数的理论增长速率,而不是依赖经验调参。对数增长意味着随着仿真轮次增加,每个点的重复次数增长缓慢,计算资源的分配有了理论依据。
论文强调,这一保证的取得依赖于通过重复仿真来学习未知的异方差方差,而非假设方差已知或预先估计。
Θ(log T) 这一记号 来自渐进复杂度分析:Θ 表示同阶上下界,即重复仿真次数既不增长得比 log T 快,也不比它慢,二者同阶。放到仿真优化的语境中,它意味着当总仿真轮次 T 不断增大时,分配给每个采样点的重复次数只需按对数速率缓慢增加即可。对数增长极慢,例如 T 从一千增到一百万(约一千倍),log T 仅增加约一倍。这解释了为什么该结论具有实践价值:它表明无需为每个新点投入成比例增长的仿真预算,资源的边际投入可以非常克制,从而为算法设计者提供了明确的预算分配依据。
温和条件(mild conditions) 通常指核函数具有足够光滑性、特征值按多项式速率衰减等标准假设。这些条件是核方法收敛率分析的常规前提,能保证 SK 预测器的置信界可控。在此之下得到的 Θ(log T) 结论虽非对任意核都成立,但覆盖了常用的高斯核、Matérn 核等,因此具有较广的适用面。
理论贡献与实际意义
这项工作最直接的贡献是填补了连续域EI型仿真优化方法在理论保证上的空白。此前,类似的遗憾保证多存在于离散域或噪声已知的设定中。
从实践角度看,该框架为算法设计者提供了明确指导:incumbent和终端推荐应采用不同方向的分位数,而非使用同一套启发式规则。这种"搜索乐观、交付保守"的设计哲学,可能会影响未来仿真优化工具的实现方式。
当然,论文的理论结果建立在常见核函数满足的温和条件之上,在更复杂的噪声结构或非平稳场景中的表现仍需进一步验证。但无论如何,将三个割裂的设计选择纳入统一的收敛率分析框架,本身就是方法论上的一次推进。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。