Ekko Studio + Jev:从判断环节给 Agent 减少等待

Jev 将 Agent 的"判断"环节独立为轻量评分组件,让主模型专注执行,但需用真实工作流验证其实际价值。
文章介绍了 Ekko Studio 与 Jev 的组合方案:Ekko Studio 负责构建 Agent 系统框架,Jev 则专门承担"判断"角色,输出选择、评分与概率,而非自然语言内容。这种设计将传统 Agent 流程中混在一起的"判断"与"执行"解耦,用更轻量的决策层减少主模型的算力消耗。在上下文压缩与内容总结场景中,Jev 负责相关性筛选,语言模型负责实际生成,目的是降低无效输入的干扰。三个具体探索方向包括:智能体分流、工作流条件判断、工具执行前的辅助检查。文章尤其值得关注的是其对局限的坦诚:类型正确不等于判断正确,高置信度不是准确率保证,该方案也无法替代权限校验和人工审批,实际价值须经真实工作流测试才能确认。
AI Agent 在实际运行中,很多时间并非花在真正的执行上,而是耗在一连串的判断与筛选环节:该调用哪个工具、如何压缩过长的上下文、怎样从海量材料里提炼总结。Ekko Studio 与 Jev 的组合,正是把优化重点放在了这个常被忽视的"选择环节",试图让 Agent 少一点无谓的等待。
Ekko Studio 与 Jev 的分工
Ekko Studio 负责组织智能体与工作流,是搭建 Agent 系统的框架层。Jev 则扮演一个特别的角色——它不聊天、不写代码,而是返回选择、评分和概率,供程序做决策。
换句话说,Jev 不生成内容,只做判断。在工具调用之前,它先从候选工具中挑出合适的一项,再交给程序执行。这里需要厘清一个关键点:它加速的是"选择"这个环节,并不代表工具本身运行得更快。
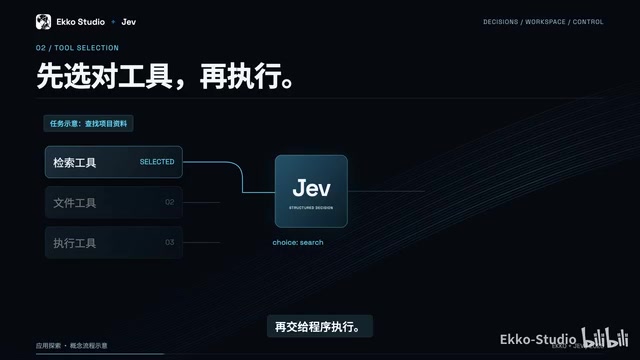
这种设计思路把"判断"与"执行"解耦。传统流程中,模型往往要一边思考调用什么、一边组织语言输出,判断和生成混在一起。而 Jev 把判断抽离出来,用更轻量的评分与概率输出承担决策角色,让主模型专注在真正需要生成能力的任务上。
这种"判断与执行解耦"的架构思想,在工程领域有其渊源。传统大语言模型(LLM)在 Agent 流程中往往承担"全栈"角色——既要理解意图、又要规划步骤、还要生成输出,导致每一步都消耗完整的推理算力。近年来,业界逐渐兴起将"路由模型"(Router Model)单独抽离的做法:用参数量更小、延迟更低的专用模型负责分类与调度,把重型生成模型的算力留给真正需要创作或推理的环节。Jev 的定位与此高度吻合——它本质上是一个轻量化的决策/评分模型,输出的不是自然语言,而是结构化的概率与评分信号,供下游程序直接消费。这类设计的潜在收益包括:减少主模型的 token 消耗、降低平均响应延迟、以及让决策逻辑更易于审计和调试。代价则是增加了系统组件数量,以及引入了路由层自身的错误风险。
上下文压缩与内容总结的新做法
面对很长的上下文,Jev 的做法是先评估信息的相关性,保留关键约束,再交给原有模型去压缩。它的角色是辅助筛选,而非直接生成压缩文本。
内容总结同样遵循这个逻辑:先挑出相关材料,再由语言模型组织成文,最后核对关键事实。整个链条中,Jev 干的是"选材"和"核对"的活,语言模型干的是"写作"的活。
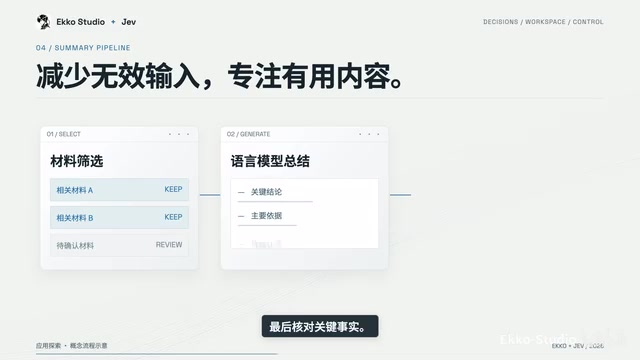
这样设计的目标很明确:减少无效输入。上下文里塞进大量无关信息,不仅拖慢速度,也可能干扰模型判断。先做一轮相关性筛选,理论上能提升效率。不过创作者也坦诚,实际能否提速仍需要测试验证,而非纸面上的必然结论。
三个探索方向
Ekko Studio + Jev 目前给出了三个具体的应用探索方向,覆盖了 Agent 系统的不同环节。
智能体分流
第一个方向是根据任务类型,从候选 Agent 中做出选择。开发、分析、执行各走合适的路径,而不是让所有 Agent 一起运行。这种分流机制避免了资源的重复消耗,也让每类任务由更专精的角色处理。
工作流条件判断
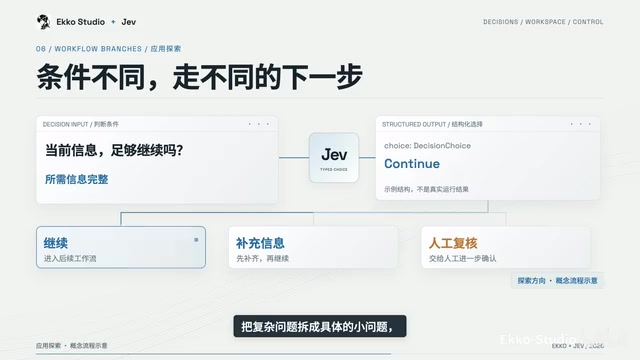
第二个方向是把复杂问题拆成具体的小问题,再由代码组合结果。当信息不足时补充上下文,当不确定时转交复核。这种"拆解—判断—组合"的模式,让复杂工作流具备了分支和回退的能力。
工具执行前的辅助检查
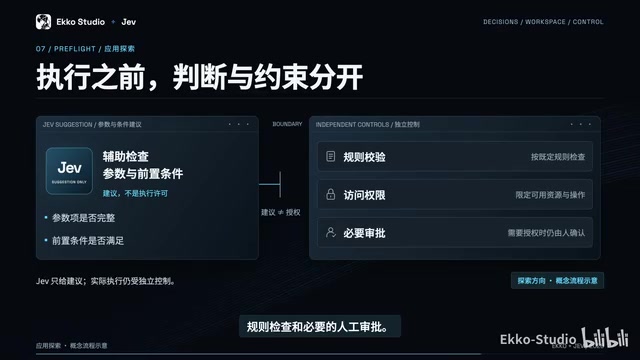
第三个方向是在工具执行前提供辅助检查,比对参数与任务条件,给出判断建议。但这里有一条明确的红线:它不能替代权限校验、规则检查和必要的人工审批。
需要清醒认识的边界
这套方案最值得称道的地方,恰恰在于它对自身局限的坦率。创作者反复强调几个边界条件。
"类型正确不代表判断正确"——即便返回的数据格式无误,也不意味着判断本身是对的。自信度(confidence)同样不是保证,高置信度的结果依然可能出错。
因此实际落地时,需要结合真实任务测试,设置合适的阈值,并为错误和不确定的情况保留回退路径。这是任何把"概率化判断"引入生产流程的系统都必须面对的工程课题——决策组件越是深入关键路径,越需要兜底机制。
文中反复提及的"自信度"(confidence)概念,在机器学习中有特定含义,值得进一步说明。模型输出的置信度(confidence score)通常来源于 softmax 层的概率分布,反映的是模型对自身预测的"主观把握",而非客观正确率的保证。校准良好(well-calibrated)的模型,其置信度与实际准确率应趋于一致;但现实中许多模型存在过度自信(overconfident)或不足自信的问题。尤其在分布外(out-of-distribution)的输入上,高置信度的错误判断相当常见。因此,在把置信度阈值作为生产级分流依据时,必须先在真实业务数据上做校准测试,而不能直接沿用开发阶段的经验值。常见的工程实践包括:设置"低置信度触发人工审核"的中间地带,而非简单地用单一阈值做二元判断;以及定期用新数据重新评估阈值的有效性。
写在最后
Ekko Studio + Jev 的核心价值可以概括为一句话:让判断更轻,让执行更专注。它没有承诺工具本身变快,而是通过在选择、压缩、总结等判断环节做减法,减少无效输入和无谓等待。
对于正在构建复杂 Agent 系统的开发者来说,这种把"决策"独立成组件的思路值得关注。但正如创作者所言,它的真实价值需要用真实工作流去验证,而不是停留在概念层面。在把它接入生产环境前,务必想清楚回退路径和人工审批环节该放在哪里。
相关推荐
人类能离太阳多近?帕克探测器穿越日冕的科学原理
人类能离太阳多近?NASA帕克太阳探测器曾飞至光球层上方380万英里,深入数百万度的日冕。本文解析为何探测器不会被汽化——温度与热量的区别、阳光强度及隔热罩设计的科学原理。
从空气中制造汽油:合成燃料为何尚未普及?
合成燃料能用空气中的二氧化碳、水和电力制造汽油、甲烷和火箭推进剂。本文解析萨巴蒂埃反应与费托合成的化学原理、热力学税、碳中和账本,以及合成燃料为何尚未普及、又将如何重塑能源地缘格局。
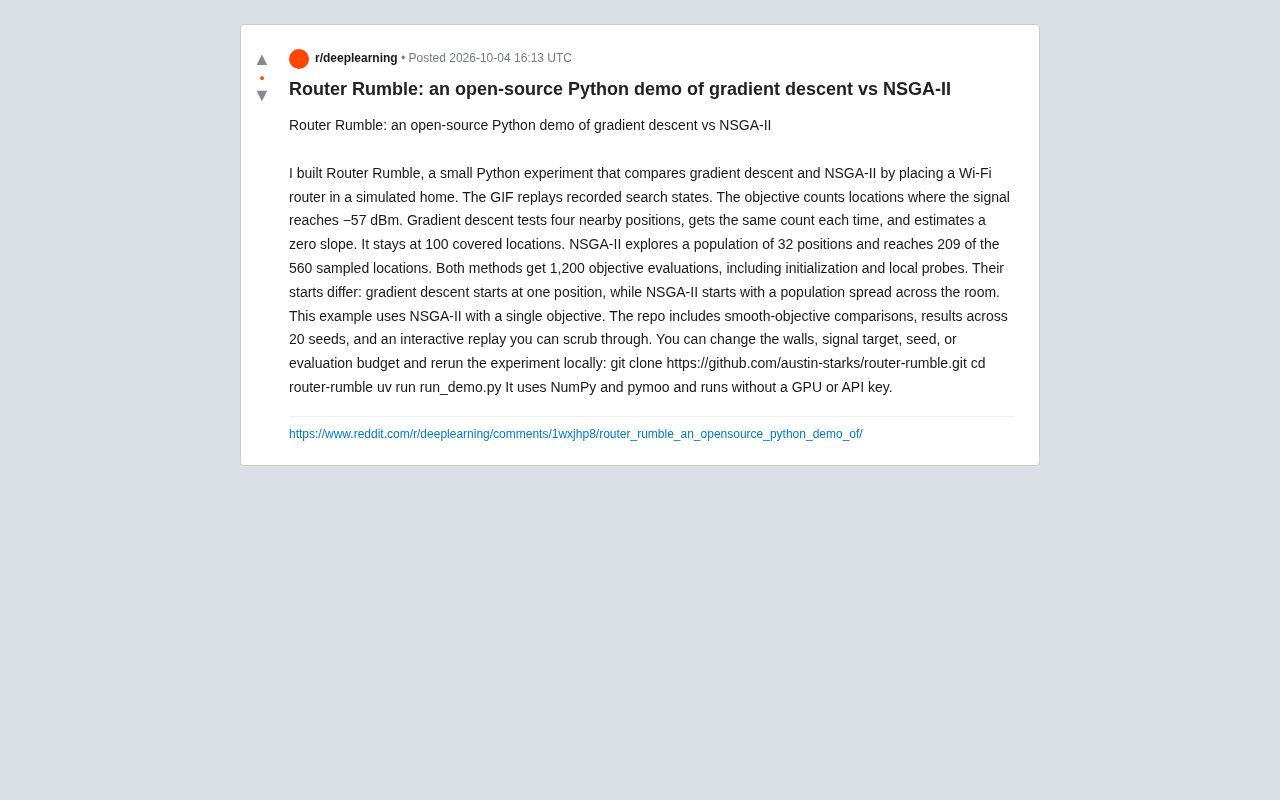
Router Rumble:用WiFi路由器演示梯度下降为何败给NSGA-II
Router Rumble 是一个开源 Python 项目,通过在模拟房间摆放 WiFi 路由器,直观对比梯度下降与 NSGA-II 进化算法在离散目标函数上的表现,揭示无梯度优化方法的优势。