ElevenLabs登陆Vercel AI Gateway:14款语音模型一站式接入

Vercel将14款ElevenLabs音频模型接入AI Gateway,单一密钥统一调用六类语音能力。
Vercel 与 ElevenLabs 合作,把 14 款音频模型接入 AI Gateway,覆盖语音转文字、流式语音合成、实时语音代理、音乐生成、音效生成和多声音对话六大类。开发者用同一个网关 API Key 即可调用全部能力,所有请求统一进入用量、成本和追踪视图。文章梳理了各类模型 ID 与选型思路,并对比两条实时语音路径:流水线式由转写、推理、合成三步拼接,灵活但需自行串联;一体化实时代理则在单条 WebSocket 会话内完成对话,浏览器侧可用 useRealtime hook。音乐与音效同样走 generateSpeech 接口,仅 text 含义不同。网关层按提供商价格原样透传、不加价,并提供重试、故障转移与零数据保留等能力。
Vercel与ElevenLabs达成合作,将14款ElevenLabs音频模型接入AI Gateway。开发者现在可以用同一个网关API Key,调用从语音转文字、流式语音合成,到实时语音代理、音乐生成、音效制作和多声音对话的全套音频能力——这对需要搭建语音交互应用的团队来说,意味着不必再分别对接多家音频服务商。
一个网关,六类音频能力
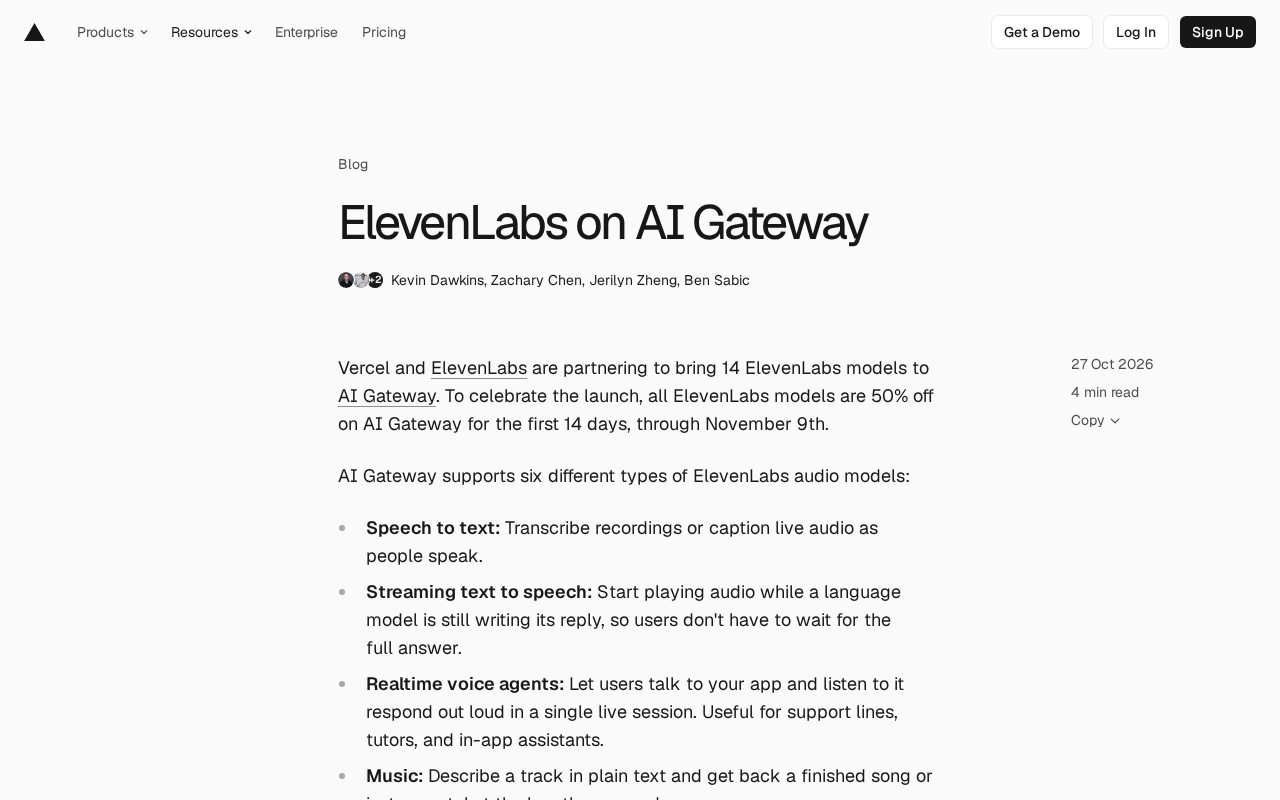
AI Gateway此次支持的ElevenLabs模型覆盖六大类:语音转文字(transcribe录音或实时为说话内容加字幕)、流式语音合成(语言模型还在生成回复时就开始播放音频,用户无需等待完整答案)、实时语音代理(用户与应用在一场直播会话中对话并听到语音回应,适用于客服热线、辅导工具和应用内助手)、音乐生成(用文字描述得到成品歌曲或纯音乐)、音效生成(从简短描述生成游戏与界面音效,或可无缝循环的环境音),以及多声音对话(一次调用为整段对话配音,每个说话人使用不同声音)。
这些模型通过单一网关API Key即可访问。应用或代理可以先转写用户所说内容,用任意数百种模型进行推理,再用ElevenLabs的声音作答,还可以搭配生成的音乐与音效制作配乐。所有请求都会和其他AI Gateway流量一样,进入统一的用量、成本和追踪视图。
模型清单与选型思路
具体模型ID按类型划分如下:
- 语音转文字:
elevenlabs/scribe-v2、elevenlabs/scribe-v2-realtime - 流式语音合成:
elevenlabs/eleven-flash-v2.5、elevenlabs/eleven-flash-v2、elevenlabs/eleven-multilingual-v2、elevenlabs/eleven-v3-conversational - 实时语音代理:
elevenlabs/eleven-realtime-v1-max、elevenlabs/eleven-realtime-v1-mini - 音乐:
elevenlabs/music-v2.5、elevenlabs/music-v2 - 音效:
elevenlabs/sound-effects-v2 - 多声音对话:
elevenlabs/eleven-v4、elevenlabs/eleven-v4-turbo、elevenlabs/eleven-v3
这种按类型拆分模型的设计,是整套方案里比较实用的部分。由于每个环节都是独立模型,开发者可以在不改动流程其余部分的情况下,替换转写、语言或语音模型。比如先用Scribe v2 Realtime在用户说话的同时转写文本,再交给语言模型生成回答,最后由Eleven Flash v2.5这种低延迟模型在回答流式生成过程中朗读出来,用户能在模型写完之前就听到回应开头。
两种实时语音的实现路径
实时语音交互有两条技术路线,适用场景不同。
第一条是流水线式:转写、推理、合成三步各自独立。官方示例中,代码把16kHz麦克风流交给Scribe v2 Realtime转写,将完成的转写文本发给语言模型(示例选用anthropic/claude-haiku-5.5),再把模型输出的文本直接送入语音合成。这种方式灵活度高,但需要开发者自行串联各环节。
第二条是一体化实时代理:Eleven Realtime v1 Max和v1 Mini把整场语音对话放在一个模型里,用户音频输入、语音回复输出都在单条WebSocket会话中完成,无需单独接线转写或语音步骤。它适合用户期待自然来回对话的场景,比如客服电话或应用内助手。服务端的职责只是为选定模型签发短期令牌,浏览器自行打开WebSocket会话,从而让API Key不暴露在客户端;浏览器侧可使用@ai-sdk/react中的useRealtime hook处理连接、麦克风采集和音频播放。需要注意的是,这两个模型支持语义VAD(semantic-vad)判断用户何时说完,但不支持server-vad。
语义 VAD 与服务器 VAD(server-vad)的区别
VAD(Voice Activity Detection,语音活动检测)用于判断用户何时开始说话、何时说完。传统 VAD 依赖音量、静音时长等声学特征做判断,容易在用户思考停顿或环境噪音时误触发。语义 VAD 则在此基础上结合上下文语义理解,能更准确地识别一句话是否真正说完,从而减少抢话和误截断,让对话轮转更自然。
server-vad 指的是把 VAD 判断放在服务端执行:客户端持续上传音频,由服务器决定何时切分语音段并触发后续处理。这种方式对客户端要求低,但会增加端到端延迟并消耗额外带宽。Eleven Realtime 模型不支持 server-vad,意味着开发者不能把断句决策完全交给服务端,而需要在客户端或模型内部处理语音边界,这也是使用 useRealtime 这类客户端 hook 管理麦克风流的原因之一。
音乐、音效与多声音对话
音乐与音效模型的用法与语音合成类似,同样调用generateSpeech,只是text字段中描述的是想要的声音而非要朗读的文字。Music v2.5和Music v2可以按文字描述创作原创音乐,指定流派、情绪或乐器,返回指定长度的成品曲目,可带人声也可纯音乐;需要更精细控制时,还能逐段编排歌曲,为每个段落设定风格和长度。Sound Effects v2则面向更短的声音,例如脚步声、关门声,或在游戏关卡下循环播放的雨声。
多声音对话由Eleven v4、Eleven v4 Turbo和Eleven v3支持,可在单次请求中演绎多说话人脚本。为每行文本分配一个声音,每次声音切换即开始新一轮对话。双人播客或完整演员阵容的场景会返回一段连续录音,无需再拼接独立片段。每个声音都是ElevenLabs的声音ID,脚本片段也可以由语言模型流式写入。
generateSpeech 的复用设计
generateSpeech 原本是文本转语音的调用接口,其语义是“给定文本,返回音频”。在音乐与音效场景中,这个接口被复用为“给定描述,返回音频”:文本不再是待朗读的内容,而是对目标声音的自然语言描述(例如“一段轻快的钢琴前奏”或“雨声,可无缝循环”)。
这种设计的好处是调用方无需学习新的请求格式,鉴权、计费、重试和追踪逻辑完全一致,只需替换模型 ID 和提示文本。代价是不同模型对描述的理解能力不同,提示词的写法会显著影响输出质量,因此在实际使用中通常需要针对音乐和音效分别调试提示模板。
网关层的工程价值
AI Gateway提供统一的模型调用API、用量与成本追踪,以及重试、故障转移和性能优化配置,目标是提供高于单一提供商的上线可用性。它还包含自定义报表、零数据保留(Zero Data Retention)支持、按API Key设置预算、路由规则等功能。定价方面,AI Gateway按提供商价格原样透传、不加价,也不对推理收取平台费用,自带密钥(BYOK)请求同样适用。
对正在构建语音应用的团队来说,这次合作的实际意义在于:语音链路的每一个环节都可以在同一套计费、追踪和容错体系下管理,模型选型也可以随时替换而不必重写对接逻辑。
目前所有ElevenLabs模型在AI Gateway上前14天享受五折优惠,活动持续到11月9日;AI Gateway音频文档中有各模型的完整示例。
相关推荐
Discord公开服务器将可被搜索引擎收录,用户隐私引担忧
Discord宣布从12月起将公开可发现服务器的消息纳入搜索引擎结果,引发用户对隐私和语境坍塌的担忧。本文分析这一变化对用户、社区运营者和平台信任的影响。
Anthropic IPO后谁掌权?复杂治理结构解析
Anthropic IPO后谁真正掌权?本文解析其被形容为极其复杂的治理结构,探讨控制权与股权的关系、上市后权力再分配,以及安全承诺与商业压力之间的张力。
美国银行警告:别把你的银行密码交给AI助手
美国银行提醒客户不要将银行密码分享给AI助手,并强调用户需对AI代理产生的账户活动负责。本文分析这一提醒背后的责任归属问题、AI代理与金融风控的结构性矛盾,以及用户可采取的务实防护措施。