Emo-Jev:用概率推理重构情感分类的免训练新范式

Jev接口以概率决策替代自由文本生成,在低延迟低成本前提下实现文本情感分类。
这篇来自arXiv的研究提出了一种名为Jev的新型LLM接口,将文本分类从"生成回答"转变为"概率判断"。基于Jev,研究者构建了无需训练的Emo-Jev框架,包含分解式判断(Emo-Jev-D)和多视角共识(Emo-Jev-SC)两种实现。在覆盖情感分析、情绪识别、讽刺检测和幽默检测的八个数据集上,标准Jev取得62.93%的平均macro-F1,略低于最强LLM基线的67.28%,但以更低延迟和成本实现。研究指出,概率决策接口在高频大规模分类场景中提供了准确率与资源消耗的差异化权衡,为文本分类系统设计提供了新的思路。
从自由文本到概率决策:Jev接口的另类思路
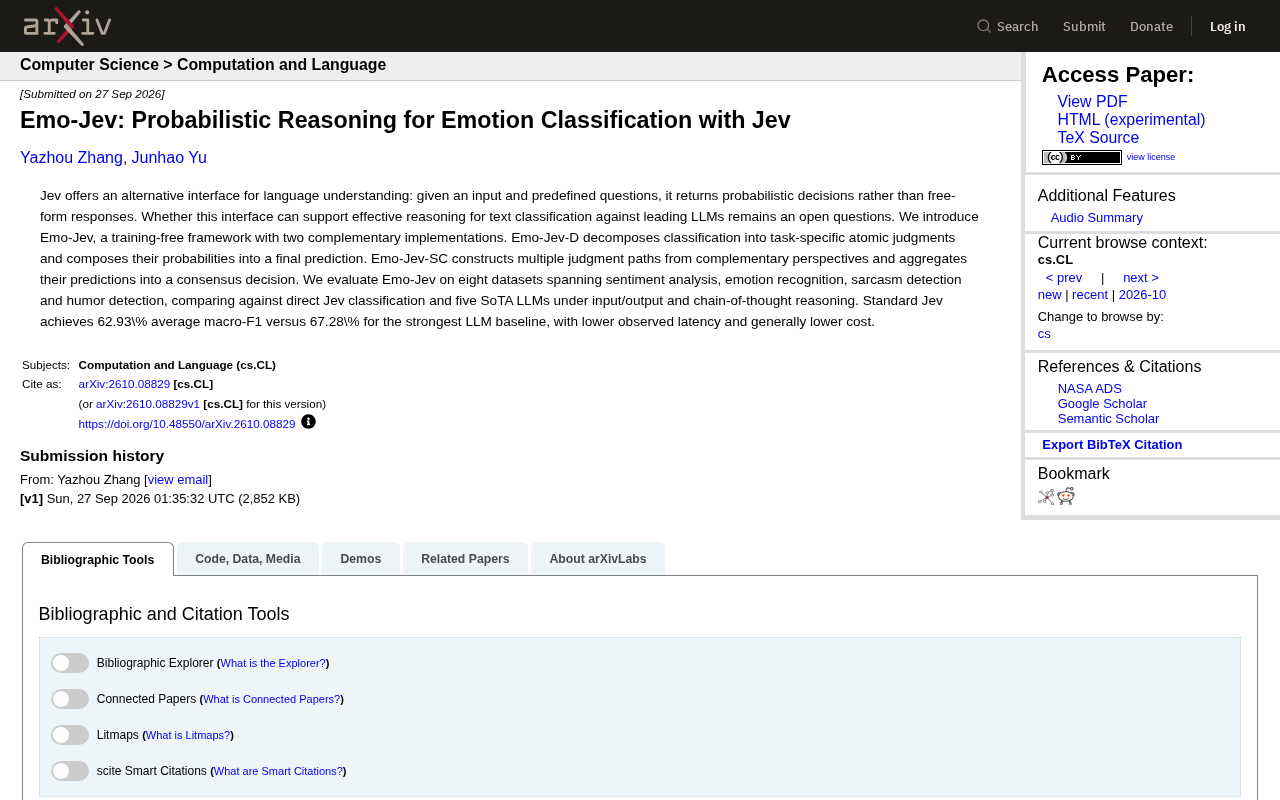
当下主流的大语言模型(LLM)在处理文本理解任务时,往往以生成自由形式的文本作为输出。而一项发表于arXiv的新研究(arXiv:2610.08829v1)提出了一种名为 Jev 的替代性接口:给定一段输入和若干预定义问题,Jev 返回的不是开放式回答,而是概率化的决策结果。
这种设计的意义在于,它把语言理解从"生成"转向了"判断"。对于文本分类这类有明确标签空间的任务来说,概率决策接口天然契合——我们真正需要的,往往不是一段解释文字,而是一个带置信度的类别判断。研究者由此提出了核心问题:这样的接口能否在文本分类任务上,与顶尖 LLM 一较高下?
Emo-Jev:两种互补的免训练框架
研究团队在 Jev 接口基础上构建了 Emo-Jev,这是一个**无需训练(training-free)**的框架,包含两套互补的实现方案。
Emo-Jev-D:分解式判断
第一种实现 Emo-Jev-D 采用了"分而治之"的策略。它将一个完整的分类任务拆解为若干任务相关的原子判断(atomic judgments),分别计算每个原子判断的概率,再把这些概率组合成最终的分类预测。
这种做法的优势在于,复杂的情感判断被拆成了更小、更可控的子问题。相比让模型一次性给出结论,逐步累积的概率组合在逻辑上更透明,也更利于定位判断偏差来自哪个环节。
原子判断(Atomic Judgment)的概念借鉴了逻辑分解与神经符号推理的思路:将一个复杂命题拆解为不可再分的基础布尔判断,每个判断只回答一个具体的是/否问题,例如"文本中是否含有负面情绪词汇""句子语气是否具有讽刺特征"等。这些子判断的概率可以通过条件独立假设或贝叶斯网络进行组合。这种分解策略的额外好处是可解释性:当最终分类出错时,可以逐级回溯到具体哪个原子判断的概率估计出现了偏差,从而为错误分析和模型改进提供清晰的着力点。
Emo-Jev-SC:多视角共识
第二种实现 Emo-Jev-SC 则走的是"集思广益"的路线。它从多个互补视角构建出多条判断路径,然后将这些路径的预测结果聚合,形成一个共识决策(consensus decision)。
这一思路与 LLM 领域广为人知的自洽性(self-consistency)方法有异曲同工之处——通过多路径采样降低单一推理链的随机偏差,从而提升结果的稳健性。两种实现各有侧重:Emo-Jev-D 强调结构化分解,Emo-Jev-SC 强调视角多样性。
自洽性(Self-Consistency)方法由Wang等人于2022年提出,其核心思想是:对同一问题生成多条独立的推理链,然后通过多数投票或概率聚合得出最终答案。实验表明,相比单次贪婪解码,自洽性能在算术推理、常识推理等任务上显著提升准确率。Emo-Jev-SC 借鉴了这一思路,但将"多条推理链"替换为"多个互补视角"——例如从语义、语气、上下文等不同角度各自生成一条判断路径,再加以聚合。这种做法在保留多路径稳健性优势的同时,通过视角的多样性而非随机采样来引入差异,理论上能更有针对性地覆盖情感理解中的歧义情形。
跨八大数据集的实证评估
为了检验框架的实际表现,研究在八个数据集上展开评估,覆盖了四类任务:
- 情感分析(sentiment analysis)
- 情绪识别(emotion recognition)
- 讽刺检测(sarcasm detection)
- 幽默检测(humor detection)
对比对象包括直接使用 Jev 做分类的基线,以及五个当前最先进(SoTA)的 LLM,评测设置涵盖输入/输出直接推理和思维链(chain-of-thought)推理两种模式。
从结果看,标准 Jev 取得了 62.93% 的平均 macro-F1,而最强的 LLM 基线为 67.28%。单纯从准确率指标上,Jev 接口尚未超越顶尖大模型,存在约 4.35 个百分点的差距。
Macro-F1(宏平均F1)是多分类任务中常用的评估指标,它对每个类别分别计算F1分数后取算术平均,不考虑各类别的样本数量差异。这与加权平均F1(weighted-F1)不同——后者会让样本量大的类别主导整体得分。在情感分析等现实场景中,类别往往不均衡(如"中性"样本远多于"愤怒"),因此 macro-F1 更能反映模型在少数类别上的真实表现,也是评估是否存在类别偏见的重要指标。文中 Jev 的 62.93% 与最强 LLM 的 67.28% 均以 macro-F1 计量,这意味着差距并非来自对高频类别的偏好,而是在较难识别的细粒度情感类别上存在实质性不足。
速度与成本:被低估的另一面
值得关注的是,论文强调 Jev 方案在延迟更低、整体成本更低的前提下取得了上述成绩。这意味着在准确率与资源消耗之间,Jev 提供了一个不同的权衡点。
在真实的工业场景中,分类任务往往是高频、大规模的,响应速度和单位推理成本直接决定了系统能否规模化落地。如果一个方案能以略低的准确率换取显著更低的延迟和成本,它在很多对实时性和预算敏感的场景中反而更具吸引力。换句话说,评价一个方法的价值,不能只盯着 macro-F1 这一个数字。
这项研究的意义与局限
Emo-Jev 的探索揭示了一个有价值的方向:概率决策接口可能是文本分类的一条高性价比路径。它不依赖训练、结构清晰、推理成本可控,这些特性在工程实践中都极具现实价值。
当然,当前结果也坦诚地暴露了短板——在纯准确率上仍落后于最强 LLM。两种实现 Emo-Jev-D 与 Emo-Jev-SC 相比标准 Jev 能带来多大提升,论文摘要中尚未给出完整对比数据,这是后续值得深入关注的部分。
对于关注情感计算、文本分类系统设计的研究者和工程师而言,这项工作提供了一个重新思考"推理接口"的切入点:也许我们并不总是需要一个会说话的模型,有时候,一个精准、快速、便宜的概率判断器才是更优解。
注:本文基于 arXiv 预印本摘要(arXiv:2610.08829v1)撰写,完整实验细节请参阅原始论文。
相关推荐

OpenAI办公室发现录音设备:安全与隐私再引关注
OpenAI在一处办公室发现录音设备,事件细节有限但引发对AI公司物理安全与隐私保护的广泛讨论。本文分析事件背景、行业影响及对AI从业者的安全启示。

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。