EMODE:为语音大模型注入情感感知的动态专家架构

EMODE通过动态副语义专家将语义与情感特征显式解耦,改善语音大模型的情感理解能力。
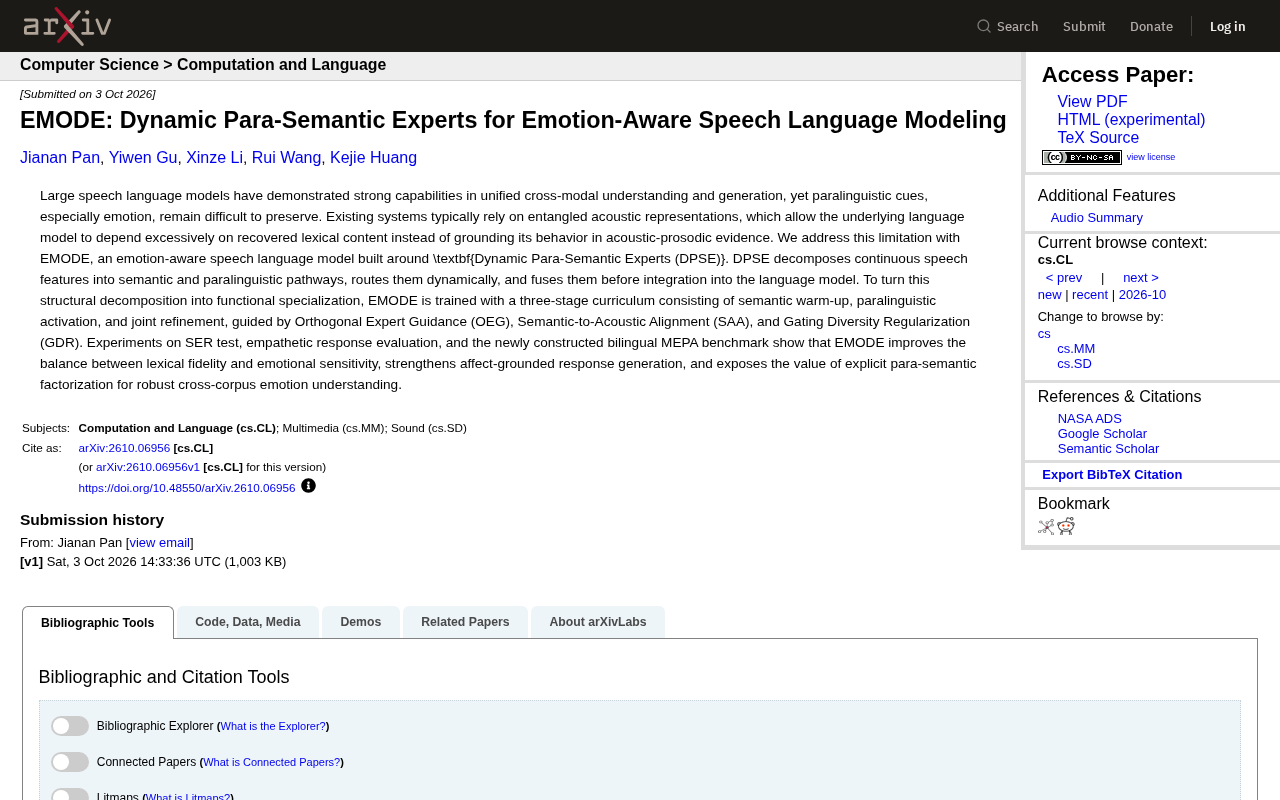
现有语音大模型因依赖纠缠式声学表征,普遍存在「听懂内容却听不出情绪」的问题。研究提出的EMODE通过动态副语义专家(DPSE)架构,将连续语音特征显式拆解为语义通路与副语言通路,再经动态路由融合进语言模型。为确保两条通路真正各司其职,EMODE设计了语义预热、副语言激活、联合精炼三阶段课程训练,并辅以正交专家引导(OEG)、语义-声学对齐(SAA)和门控多样性正则化(GDR)三项机制。实验在语音情感识别、共情回应生成及新建双语MEPA基准上验证,结果显示EMODE更好地平衡了词汇保真度与情感敏感度,并揭示了显式副语义因子分解对跨语料库泛化的价值。该工作的核心设计原则是:情感信息应被显式建模,而非作为语义副产品被动恢复。
语音大模型的情感短板
大型语音语言模型(Speech LLM)近年来在跨模态理解与生成上展现出强大能力,能够统一处理语音到文本、文本到语音等多种任务。但在一个关键维度上,这些系统始终难以令人满意——副语言线索(paralinguistic cues),尤其是情感信息的保留。
问题的根源在于现有系统普遍依赖「纠缠式」声学表征(entangled acoustic representations)。这种表征把语义内容和声学-韵律特征混在一起,导致底层语言模型倾向于过度依赖恢复出来的词汇内容,而不是真正立足于声学-韵律证据来做判断。换句话说,模型「听懂了说什么」,却没能「听出怎么说的」。对于需要共情、情感理解的交互场景,这是一个硬伤。
副语言线索(paralinguistic cues)是指语言内容之外、通过声音传递的所有非语义信息,包括语调(intonation)、音高(pitch)、语速(speech rate)、音量变化、停顿节奏以及声音质感(如颤抖、沙哑)等。这些线索在人类交流中承担着至关重要的角色——同一句话用不同的语气说出,传递的情感可能截然相反。传统的语音识别(ASR)系统主要目标是准确转录词汇内容,因此副语言信息往往在处理流水线中被丢弃或忽略。当语音大模型在 ASR 输出的文本上运作时,这些情感线索已经无法被恢复。即便是端到端的语音模型,如果编码器的训练目标以语义重建为主,也会在表征层面系统性地压制副语言信号,形成所谓的「纠缠式」表征问题。
EMODE 的核心设计:动态副语义专家
这篇来自 arXiv 的研究提出了 EMODE,一个围绕**动态副语义专家(Dynamic Para-Semantic Experts, DPSE)**构建的情感感知语音语言模型。
DPSE 的思路是把连续语音特征显式拆解成两条通路:
- 语义通路(semantic pathway):负责承载词汇、语言内容;
- 副语言通路(paralinguistic pathway):负责捕捉情感、韵律等声学线索。
这两条通路经过**动态路由(dynamic routing)**后再进行融合,最终整合进语言模型。这种结构性解耦的意义在于,它不再让语义内容「挤占」情感信息的表达空间,而是给副语言特征一条独立的、受保护的处理路径。
从结构解耦到功能专精
仅有结构上的拆分还不够,关键是要让这两条通路真正各司其职。EMODE 为此设计了一套三阶段课程式训练(three-stage curriculum):
- 语义预热(semantic warm-up):先打好语言理解的基础;
- 副语言激活(paralinguistic activation):唤醒并强化情感通路的表达能力;
- 联合精炼(joint refinement):两条通路协同优化。
这套课程由三项正则化与引导机制支撑:正交专家引导(Orthogonal Expert Guidance, OEG)确保两类专家学到互不重叠的特征;语义-声学对齐(Semantic-to-Acoustic Alignment, SAA)维持跨模态的一致性;门控多样性正则化(Gating Diversity Regularization, GDR)则防止动态路由退化为单一路径。这三者共同把「结构解耦」转化为「功能专精」。
正交专家引导(OEG)的核心思想来自线性代数中的正交性概念——两个向量正交意味着它们在特征空间中完全不相关。将这一约束施加到语义专家与副语言专家的表征上,可以从数学层面保证两类专家学到的特征彼此互补、不产生冗余。这类正交性约束在多任务学习和混合专家(Mixture of Experts, MoE)模型中有广泛应用,本质上是通过正则化损失项惩罚两组特征向量之间的余弦相似度或内积。门控多样性正则化(GDR)则解决了 MoE 架构中常见的「专家坍塌」问题——在没有额外约束时,动态路由机制往往会收敛到始终激活同一条路径,导致多专家设计形同虚设。GDR 通过鼓励门控权重的分布熵最大化,迫使不同输入样本激活不同的专家组合,从而维持架构的多样性优势。
实验验证与新基准
研究团队在多个任务上评估了 EMODE,包括语音情感识别(SER)测试、共情回应评估,以及新构建的双语 MEPA 基准。
结果显示 EMODE 在几个方面带来改进:
- 更好地平衡了词汇保真度(lexical fidelity)与情感敏感度(emotional sensitivity),不再是顾此失彼;
- 增强了基于情感的回应生成能力,让模型的输出更贴合说话者的情绪状态;
- 揭示了显式副语义因子分解对跨语料库情感理解鲁棒性的价值。
值得关注的是 MEPA 这一双语基准的引入。跨语料库、跨语言的情感理解一直是该领域的难点,情感表达的声学模式在不同语言间存在差异,一个专门的双语评测集有助于更公允地检验模型的泛化能力。
跨语料库情感识别(cross-corpus SER)是语音情感领域长期存在的挑战:在一个数据集上训练的模型,换到另一个数据集往往性能大幅下滑。原因在于不同语言、文化背景乃至录音环境下,情感的声学表达模式存在显著差异——例如普通话与英语在表达愤怒时的音高曲线形态便不尽相同。现有英语中心化的基准难以全面考察模型在多语言场景下的泛化能力。MEPA 双语基准的构建填补了这一空白,使研究者能够区分模型是真正学到了跨语言通用的情感声学特征,还是仅仅过拟合了单一语言的语料分布。这对于评估情感 AI 系统在实际多语言部署环境中的可靠性具有直接意义。
对语音交互的意义
EMODE 的价值不只在于指标提升,更在于它提出了一个有启发性的设计原则:情感信息值得被显式建模,而不是作为语义的副产品被动恢复。
随着语音助手、情感陪伴、客服等交互场景对「情商」要求越来越高,如何让模型真正听出语气、情绪、态度,正成为语音大模型下一阶段的竞争点。DPSE 这种将语义与副语言显式解耦、再动态融合的架构,为后续研究提供了一条可借鉴的技术路线。
需要说明的是,本文基于单篇 arXiv 预印本(arXiv:2610.06956v1)的摘要内容整理,具体的网络规模、实验数据细节以及与其他基线模型的对比指标,仍需参考完整论文。该方法在真实部署环境中的表现,也有待进一步验证。
相关推荐

Gemini 4 Argon 实测:百万token输出与自主Agent能力
Gemini 4 Argon 深度实测:百万token连续输出、自主GPU科研实验、前端像素级重建等能力全面验证,同时揭示前沿Agent的目标函数博弈风险与推理等级选择策略。
Gemini 4 解读500页化学专利:药物发现效率提升
Isomorphic Labs 研究者使用 Gemini 4 处理500页化学专利和学术论文,10-15分钟生成高质量报告,原本需要一个月的工作量缩短至一个下午。
Gemini 4 Argon 演示:用 AI 将 2D 安卓地图应用变成 3D 星象馆
Gemini 4 Argon 实战演示:用 AI 将普通 2D Android 地图应用升级为 3D 格里菲斯天文台交互世界,自动修复 API 密钥缺失,支持 120Hz 渲染与音频响应着色器,设备端 Gemini Nano 同步旁白。