EmoHarness:元框架进化提升小模型多模态情感理解

EmoHarness 以冻结模型加外挂框架组织多模态证据,显著提升小模型情感识别率。
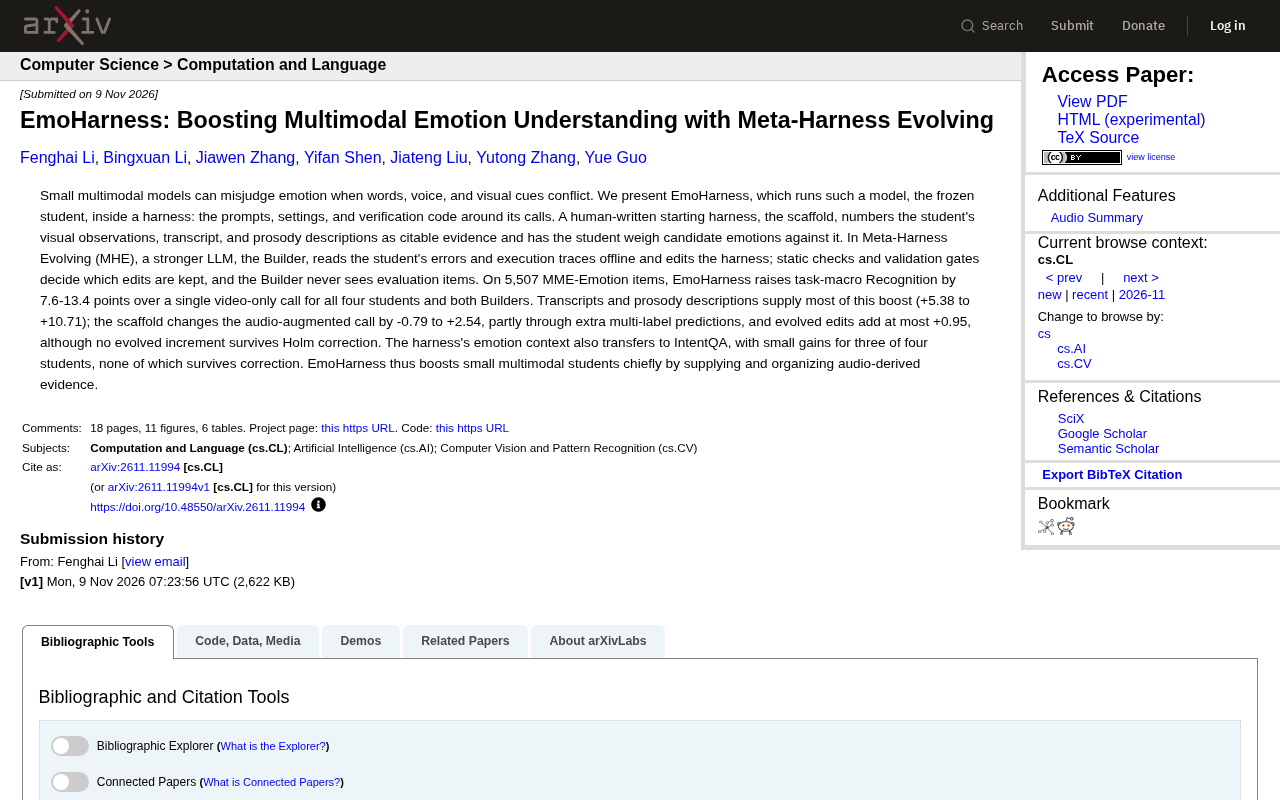
EmoHarness 针对小模型在多模态情感识别中易受单一模态主导的问题,提出一种外挂式框架方案:保持学生模型权重完全冻结,通过人工编写的初始脚手架将视觉观察、转录文本和韵律描述编号为可引用证据,强制模型在判断前比对多种模态;再由能力更强的 Builder LLM 在离线状态下根据错误轨迹进化框架。在 5,507 条 MME-Emotion 数据上,该方法使四个学生模型的宏平均识别率相比视频单次调用提升 7.6 至 13.4 个百分点。分析表明增益主要来自转录与韵律描述所提供音频衍生证据(+5.38 至 +10.71),而框架自动进化的增量最多仅 +0.95 且不显著,迁移到 IntentQA 的提升也未通过校正检验。
小模型在多模态情感识别中常因文字、语音和视觉线索冲突而判断失误。最新的研究提出 EmoHarness,通过外挂式框架组织证据,显著提升了多个小模型的识别准确率。
核心问题:小模型的情感判断困境
多模态情感理解要求模型同时处理语言内容、语音语调与视觉表情。当三者传递矛盾信号时,参数量有限的小模型容易受单一模态主导,导致误判。传统微调方法需要更新模型权重,成本高且可能损害泛化能力。
EmoHarness 的思路截然不同:保持学生模型完全冻结,通过设计其调用外围的提示词、设置与验证代码——即“框架”(harness)——来引导模型更好地利用多模态证据。
多模态情感识别(Multimodal Emotion Recognition)是情感计算的一个核心任务,旨在综合文本、语音、视觉等多种模态的信息来判断说话者的情绪状态。与单模态任务相比,多模态输入既提供了互补线索,也带来了模态间冲突的挑战——例如一个人可能面带微笑却用低沉的语调说出消极的话语。解决这类冲突需要模型具备跨模态的语义对齐与证据权衡能力,而参数量较小的模型往往缺乏这种能力,容易退化为依赖单一模态(通常是文本)进行判断。
方法:脚手架与元框架进化
EmoHarness 的核心由两部分构成。
初始脚手架:结构化证据
研究者首先人工编写了一个起始框架,称为“脚手架”(scaffold)。它将学生模型的视觉观察、转录文本和韵律描述编号为可引用的证据,并要求学生模型将这些候选情感与证据逐一比对。这种设计强制模型在做出判断前参考多种模态信息,而非依赖单一信号。
韵律(prosody)指语音中超越音段音位的超音段特征,主要包括音高(基频)、音长、音强及其变化模式。在情感识别中,韵律是传达情绪的关键声学线索:例如愤怒通常表现为高音高、快语速和强重音,而悲伤则表现为低音高、慢语速和弱重音。文章中的“韵律描述”即是由工具或模型对语音的这类声学特征进行文本化转述,使冻结的小模型能够在纯文本层面获取原本需要音频编码器才能捕捉的信息,从而弥补其声学感知能力的不足。
Meta-Harness Evolving:离线进化
在 Meta-Harness Evolving(MHE)阶段,一个能力更强的 LLM(称为 Builder)在离线状态下读取学生模型的错误和执行轨迹,并据此编辑框架。静态检查与验证门控决定哪些修改被保留,且 Builder 从不接触评估项目,确保评估的公正性。
Holm 校正(Holm-Bonferroni correction)是一种用于多重假设检验的统计校正方法。当研究同时检验多个假设时,犯第一类错误(假阳性)的概率会累积膨胀,Holm 校正通过按 p 值从小到大排序并逐步收紧显著性阈值来控制总体错误率。本文中,进化编辑产生了多个增量假设,因此在判断这些增量是否显著时必须进行校正;校正后没有一项进化增量通过显著性检验,意味着观察到的提升可能只是随机波动,不能断言进化机制真正有效。
实验结果:识别率显著提升
在 5,507 条 MME-Emotion 数据上,EmoHarness 使四个学生模型和两个 Builder 的任务宏平均识别率(task-macro Recognition)相比仅使用视频的单次调用提升了 7.6 至 13.4 个百分点。
说个细节,转录文本和韵律描述贡献了大部分增益(+5.38 至 +10.71)。脚手架对音频增强调用的影响在 -0.79 到 +2.54 之间,部分源于额外的多标签预测。而进化编辑带来的增量最多为 +0.95,且在 Holm 校正后没有一项进化增量能通过显著性检验。
此外,框架提供的情感上下文还迁移到了 IntentQA 任务,四个学生模型中有三个获得小幅提升,但同样未通过校正检验。
宏平均(macro-averaging)是一种在多类别或多任务评估中常用的聚合方式:先分别计算每个类别(或任务)的指标,再对这些指标取算术平均,而不考虑各类别样本量的差异。与之相对的微平均(micro-averaging)则按样本量加权。本文使用“任务宏平均识别率”意味着每个情感识别子任务的准确率被同等对待,避免样本量大的类别主导整体得分,从而更公平地反映模型在不同情感类别上的均衡表现。
分析:音频证据是关键,进化机制待挖掘
实验结果指向一个清晰的结论:EmoHarness 的增益主要来自提供并组织音频衍生证据,而非框架的自动进化。转录和韵律描述的加入让模型获得了文字之外的声学线索,这恰恰是小模型容易忽略的部分。
MHE 的进化贡献有限,可能因为初始脚手架已经覆盖了关键证据组织方式,自动编辑难以在有限步数内找到更有价值的修改。这也提示未来工作可以探索更高效的搜索策略或更丰富的编辑空间。
启示与局限
EmoHarness 展示了一种低成本提升小模型多模态能力的路径:不更新权重,而是通过外部框架优化输入组织和验证逻辑。对于资源受限的部署场景,这种方案具有吸引力。
局限同样明显:进化机制的实际效果未达统计显著,框架的迁移能力也仅在部分模型上得到验证。后续研究需要更大规模的评估和更稳健的进化设计。
总体而言,这项工作强调了音频证据在多模态情感理解中的核心地位,并为小模型的能力增强提供了新视角。
相关推荐
Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。
AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。