epistemic-guard:10ms拦截AI幻觉工具调用,为Agent记忆签名
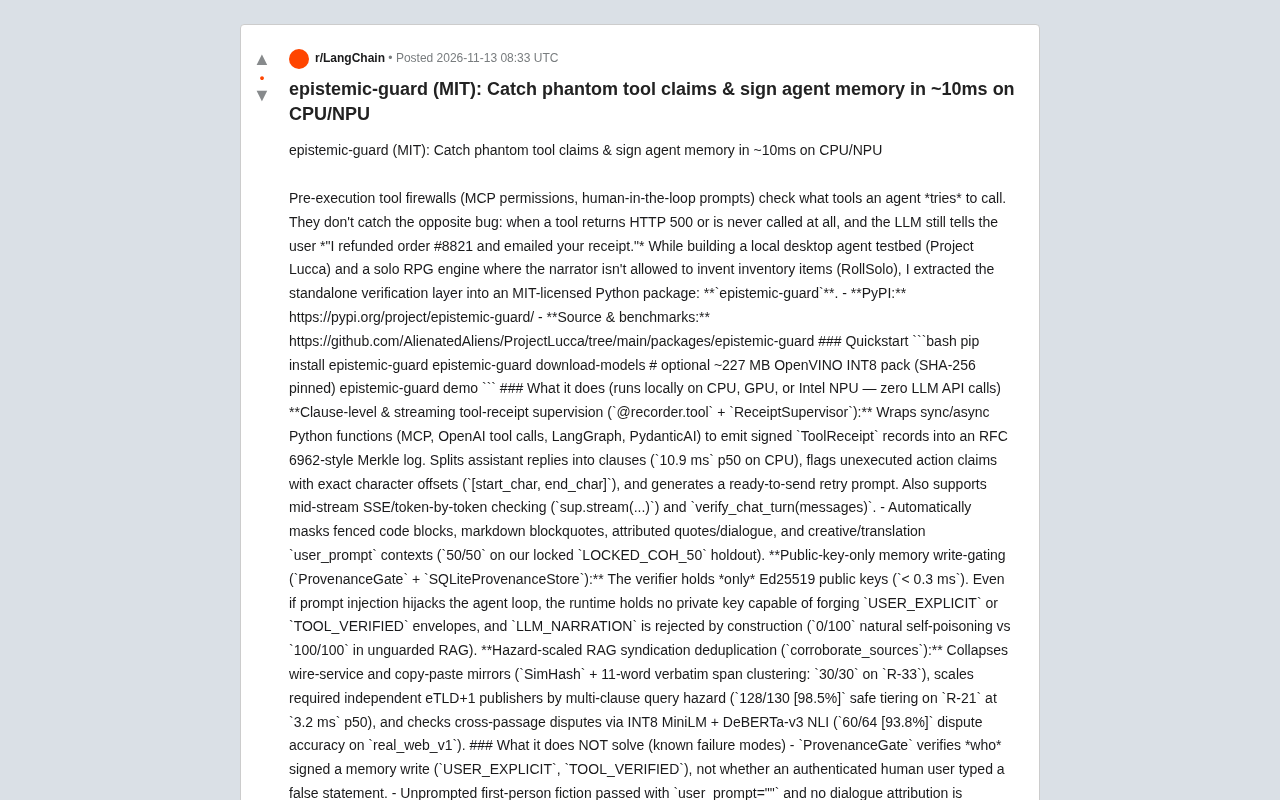
epistemic-guard用签名收据与子句级比对,本地捕获Agent的幽灵工具声明。
epistemic-guard 是一个 MIT 许可的开源 Python 包,针对现有工具防火墙的盲区:Agent 在工具失败或未被调用时仍声称「已退款」「已发送邮件」。它不检查 Agent 打算做什么,而是检查它声称做了什么。通过 `@recorder.tool` 生成签名 `ToolReceipt` 并写入 RFC 6962 风格 Merkle 日志,再用子句级比对(CPU 上 p50 约 10.9ms)定位未执行的动作声明,支持流式检查。`ProvenanceGate` 仅持 Ed25519 公钥即可门控记忆写入,阻断提示注入导致的自我投毒;`corroborate_sources` 按危害度扩展来源去重。项目提供约 227MB 本地 OpenVINO INT8 模型包,零 LLM API 调用,作者亦公开了已知失败模式。
AI Agent在调用工具失败或根本没有调用时,却告诉用户「已退款」「已发送邮件」——这类「幽灵工具声明」是现有工具防火墙的盲区。开源项目epistemic-guard通过子句级监督和签名收据,在CPU/NPU上以约10ms延迟捕获不实声明,并为Agent记忆写入加上密码学门控。
工具防火墙只管「调用前」,管不了「没调用却说做了」
现有的预执行工具防火墙(如MCP权限检查、人工介入提示)关注的是Agent试图调用哪些工具。它们无法捕获相反的bug:工具返回HTTP 500,或者根本没有被调用,但LLM仍然告诉用户「我已退款订单#8821并发送了收据」。
epistemic-guard的作者在开发本地桌面Agent测试床(Project Lucca)和单人RPG引擎(RollSolo,旁白不允许凭空编造物品栏)时,将这一验证层提取为独立的MIT许可Python包。其核心思路是:不检查Agent打算做什么,而是检查Agent声称做了什么,并与实际工具执行记录做比对。
三块核心机制:收据监督、记忆门控、来源去重
1. 子句级与流式工具收据监督
通过@recorder.tool装饰器和ReceiptSupervisor,项目为同步/异步Python函数(覆盖MCP、OpenAI工具调用、LangGraph、PydanticAI)生成签名的ToolReceipt记录,写入RFC 6962风格的Merkle日志。
助手回复被切分为子句(CPU上p50为10.9ms),未执行的动作声明会被标记出精确的字符偏移量([start_char, end_char]),并生成可直接发送的重试提示。它还支持流式SSE/逐token检查(sup.stream(...))和verify_chat_turn(messages)。
项目自动屏蔽围栏代码块、Markdown引用块、有归属的引语/对话,以及创意/翻译类user_prompt上下文——在锁定的LOCKED_COH_50留出集上达到50/50。
2. 仅公钥的记忆写入门控
ProvenanceGate配合SQLiteProvenanceStore,验证器只持有Ed25519公钥(耗时<0.3ms)。即使提示注入劫持了Agent循环,运行时也不持有能伪造USER_EXPLICIT或TOOL_VERIFIED信封的私钥,而LLM_NARRATION按构造直接被拒绝:自然自我投毒为0/100,未加防护的RAG则为100/100。
3. 按危害程度扩展的来源去重
corroborate_sources使用SimHash加11词逐字片段聚类,合并通稿和复制粘贴镜像(在R-33上30/30),并按多子句查询的危害度缩放所需的独立eTLD+1发布者数量(在R-21上3.2ms p50下达到128/130,即98.5%的安全分层)。它还用INT8 MiniLM加DeBERTa-v3 NLI检查跨段落争议(在real_web_v1上争议准确率为60/64,即93.8%)。
能做什么,不能做什么
作者明确列出了已知失败模式,态度诚实:
ProvenanceGate验证的是谁签署了记忆写入(USER_EXPLICIT、TOOL_VERIFIED),而非被认证的人类用户是否输入了虚假陈述。- 当
user_prompt=""且没有对话归属时,无提示的第一人称虚构与未收据的动作声明无法区分,除非传入user_prompt上下文或[ACTION: verb target]标签。 - 在噪声较大的单次实时抓取网页(
real_web_v2,N=64)上,端到端负担准确率为47/64(73.4%),争议准确率为56/64(87.5%)——研究之间隐式的跨文章分歧,若没有词面或单句NLI对立,仍占开放网络错误案例中剩余约26.6%(17/64)。
本地运行,零LLM API调用
项目提供可选的约227MB OpenVINO INT8模型包(SHA-256固定),在CPU、GPU或Intel NPU上本地运行,不产生任何LLM API调用。快速上手只需三条命令:
pip install epistemic-guard
epistemic-guard download-models  # 可选 ~227 MB OpenVINO INT8 pack (SHA-256 pinned)
epistemic-guard demo
为什么值得关注
Agent可靠性正从「能不能调用工具」转向「说的和做的是否一致」。epistemic-guard把可验证性下沉到运行时:用签名收据固化工具执行事实,用子句级比对捕获不实声明,用公钥门控阻断记忆投毒。MIT许可、纯本地推理、对主流Agent框架的包装支持,使其适合作为Agent测试与生产环境的验证中间层。作者也公开欢迎对抗性测试用例——对于这类安全工具而言,可被攻击和检验本身就是可信度的一部分。
背景补充
RFC 6962 风格的 Merkle 日志:RFC 6962 是 Certificate Transparency(证书透明日志)的技术标准,其核心是一棵只追加的 Merkle 哈希树——每个新条目都通过哈希链与之前所有条目绑定,任何对历史记录的篡改都会导致根哈希不匹配,从而可被检测。epistemic-guard 借用这一结构记录 ToolReceipt,意味着每条工具执行凭证不仅有签名,还具备可验证的追加顺序和防篡改属性。验证方无需信任运行时,只需持有日志根哈希即可确认某条收据确实在特定时刻被写入且未被事后修改,这比单纯的签名收据更适合审计与事后追溯场景。
Ed25519 与「仅公钥验证」的安全含义:Ed25519 是一种基于椭圆曲线的数字签名算法,签名与验证都极快,公钥仅 32 字节。其关键性质是签名只能由私钥持有者生成,而验证只需公钥。ProvenanceGate 的设计正是利用这一点:Agent 运行时进程内只装载公钥,因此即便攻击者通过提示注入完全控制了 Agent 循环,也无法伪造一条 USER_EXPLICIT 或 TOOL_VERIFIED 信封——因为生成这些信封所需的私钥根本不在该进程内。与之相对,LLM_NARRATION 类型被直接拒绝,等价于在架构层面规定「模型自述不能作为记忆的可信来源」,而非依赖提示词约束模型自觉。
SimHash、eTLD+1 与 NLI:SimHash 是一种局部敏感哈希,内容相近的文档会得到汉明距离很小的指纹,因此适合快速识别通稿与镜像转载;配合逐字片段聚类可提高精确度。eTLD+1 指有效顶级域加一级标签(如 news.example.com 归一为 example.com),用它计数「独立发布者」可以避免同一站点多个子域被误算为多个独立来源。NLI(自然语言推理)模型则用于判断两段文字之间是蕴含、中立还是矛盾,从而发现跨段落的实质性争议,而不只是词面重复。三者结合,使「按危害度要求更多独立来源」这一策略在工程上可行。
相关推荐

Daybreak Red部署指南:监督式安全调查参考架构
Daybreak Red参考架构解析:介绍监督式安全调查的安全控制设计、部署配置流程与运行监控机制,为团队落地受控安全调查提供工程参考。

Gemini 4 Neon 登顶 Models Engineering Index 榜首
Gemini 4 Neon 在 Models Engineering Index 上成为新晋第一,Hacker News 社区热议其排名含金量与评测方法。本文梳理榜单变动、社区反应及对开发者选型的实际影响。

苹果自研AI智能体:能替你操作Mac的Agent要来了
苹果据报正在开发可操控Mac的AI智能体,对标Meta Muse、Claude、OpenAI Dots等产品。本文分析苹果在agent赛道的系统级优势、竞争格局与可能的落地路径。