儿童语音识别适配难题:如何在提升童声识别的同时不遗忘成人语音

系统对比三种方法如何在儿童语音适配与成人语音保留之间取得最优权衡
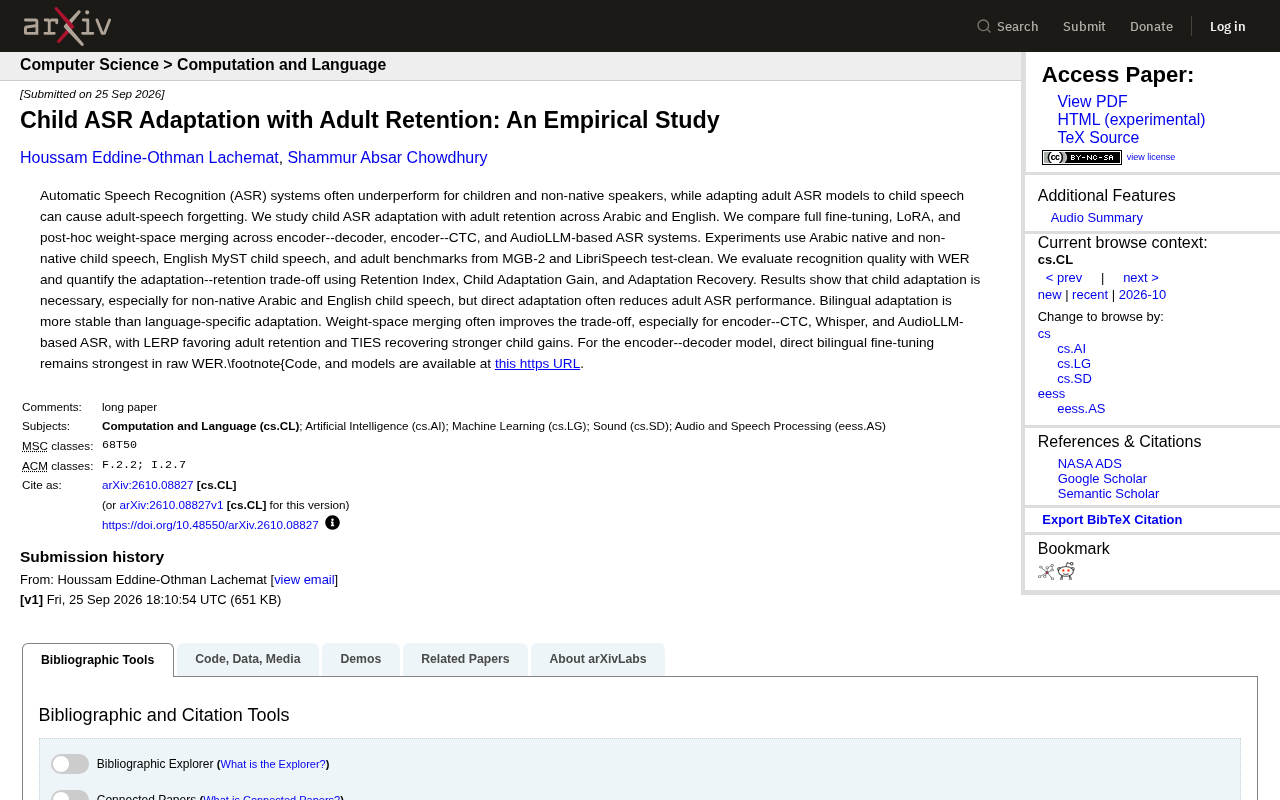
儿童语音识别是ASR领域长期未解的难题:将成人模型直接微调到童声数据会触发"灾难性遗忘",导致成人识别能力退化。来自QCRI的这项研究在阿拉伯语和英语两个语种上,系统对比了全量微调、LoRA和权重空间融合三种适配策略,覆盖编码器-解码器、编码器-CTC和AudioLLM三类架构,并引入保留指数、儿童适配增益、适配恢复度三个专项指标量化权衡效果。核心结论是:儿童适配不可省略,但方法选择至关重要——双语适配比单语更稳定,权重空间融合能有效缓解适配与保留的冲突,其中LERP偏重成人能力保留、TIES更能恢复童声增益;唯编码器-解码器架构例外,直接双语微调在原始WER上仍最优。代码与模型已开源。
儿童语音识别为何是块难啃的骨头
自动语音识别(ASR)技术在成人场景下已经相当成熟,但面对儿童和非母语说话者时表现却明显下滑。孩子的声道结构、发音方式、语速与成人差异巨大,直接套用成人训练出来的模型,识别准确率往往不尽如人意。
一个看似直接的解决思路是:拿成人模型在童声数据上做微调(fine-tuning)。但这里存在一个经典的机器学习陷阱——灾难性遗忘。当模型被重新训练去适应儿童语音时,它原本在成人语音上积累的能力会出现退化,也就是所谓的"成人语音遗忘"。
来自卡塔尔计算研究所(QCRI)团队的这项实证研究,正是围绕这一核心矛盾展开:如何在让模型学会识别童声的同时,尽可能保留它对成人语音的识别能力。研究覆盖阿拉伯语和英语两个语种,具有跨语言的参考价值。
灾难性遗忘(Catastrophic Forgetting)是深度学习中的经典难题,最早由McCloskey和Cohen于1989年描述。当神经网络在新任务上持续训练时,更新参数的梯度下降过程会覆盖此前学到的权重分布,导致旧任务性能骤降。这一问题在迁移学习场景中尤为突出:模型的参数空间是有限的,新知识的写入往往以旧知识的抹除为代价。持续学习(Continual Learning)领域已发展出多种应对策略,包括弹性权重巩固(EWC)、渐进式网络(Progressive Networks)以及本文重点探讨的权重空间融合等。在语音识别场景中,成人与儿童的声学特征差距极大——儿童基频(F0)更高、共振峰频率更高、发音变异性更大——这使得模型在两类数据间的参数冲突尤为剧烈,灾难性遗忘问题比一般领域适配更为严重。
三种适配方法与三类模型架构的全面对比
这项研究的扎实之处在于其系统性的实验设计。团队对比了三种不同的适配策略:
- 全量微调(Full Fine-tuning):对模型所有参数进行更新,适配能力最强,但遗忘风险也最高。
- LoRA(低秩适配):只训练少量新增参数,以较低成本实现适配。
- 事后权重空间融合(Post-hoc Weight-space Merging):训练完成后,在参数空间层面将适配模型与原始模型进行融合。
这三种方法又分别在三类主流 ASR 架构上进行了测试:编码器-解码器(encoder-decoder)、编码器-CTC(encoder-CTC),以及基于音频大语言模型(AudioLLM)的 ASR 系统。
实验数据来源相当丰富:阿拉伯语母语和非母语儿童语音、英语 MyST 儿童语音数据集,以及来自 MGB-2 和 LibriSpeech test-clean 的成人基准数据。这种多语种、多数据源的组合,让结论更具普适性。
LoRA(Low-Rank Adaptation)是2021年由微软研究院提出的参数高效微调方法。其核心思想是:预训练模型的权重矩阵在适配过程中发生的变化具有低秩特性,因此可以用两个小矩阵的乘积来近似这一变化量(ΔW = A×B),而冻结原始权重不动。训练时只更新A和B两个低秩矩阵,参数量通常仅为全量微调的0.1%–1%,显著降低了计算成本和存储开销,同时因为原始权重未被直接修改,理论上对灾难性遗忘也有一定抑制作用。LoRA最初在大语言模型上广泛应用,近年已延伸至语音领域,是当前参数高效适配的主流方案之一。
权重空间融合则是一种事后处理思路:分别训练出专门适配童声的模型和保留成人能力的原始模型,再在参数空间直接对两组权重进行数学合并。LERP(线性插值)是最简单的融合方式,即 θ_merged = (1-α)×θ_adult + α×θ_child;TIES(Trim, Elect, Disjoint Merge)则在融合前先对参数进行剪枝和冲突解决,保留更重要的权重更新,通常能恢复更多任务特异性能力。
用三个指标量化"适配-保留"的权衡
评估这类问题不能只看一个数字。除了传统的词错误率(WER),研究团队还引入了三个专门指标来刻画适配与保留之间的平衡:
- 保留指数(Retention Index):衡量适配后模型对成人语音的能力保留程度。
- 儿童适配增益(Child Adaptation Gain):衡量模型在童声识别上的提升幅度。
- 适配恢复度(Adaptation Recovery):衡量在权衡过程中性能的恢复能力。
这套指标体系的意义在于,它把一个模糊的"好不好"问题,转化为可量化、可比较的多维度评估,让不同方法的优劣一目了然。
核心结论:童声适配必要,但方法大有讲究
研究得出了几个关键发现:
儿童适配确实必要。 尤其是针对非母语的阿拉伯语和英语儿童语音,不做适配的模型表现明显不足。换句话说,直接拿成人模型应付儿童场景是行不通的。
直接适配会损害成人识别能力。 这印证了灾难性遗忘的担忧——简单粗暴的微调往往以牺牲原有能力为代价。
双语适配比单语适配更稳定。 这是一个颇有意思的发现:同时在两种语言上做适配,反而比只针对单一语言更能维持性能的稳定性。这可能与多语言训练带来的正则化效应有关。
权重空间融合是改善权衡的有效手段。 对于编码器-CTC、Whisper 以及基于 AudioLLM 的系统,事后权重融合往往能改善适配与保留之间的平衡。其中两种融合方式各有侧重:LERP(线性插值)更偏向保留成人识别能力,而 TIES 则能恢复更强的儿童识别增益。
不过也有例外——对于编码器-解码器模型,直接的双语微调在原始 WER 指标上仍然表现最强。这说明没有放之四海而皆准的最优方法,架构特性决定了最佳策略的选择。
双语适配带来稳定性这一发现与多语言预训练研究中的"正迁移"(Positive Transfer)效应一脉相承。在多任务或多语言框架下训练时,不同任务/语言之间的梯度更新形成相互制约,客观上起到了类似正则化的作用,防止模型过度拟合单一数据分布。这与Whisper等多语言模型天然具备跨语言泛化能力的观察相吻合。对于儿童语音适配而言,同时引入阿拉伯语和英语儿童数据,可能使模型学到更通用的"儿童声学特征表示",而非仅仅记忆某一语种的发音特点,从而在保留成人能力方面表现出更好的鲁棒性。
对实际应用的启示
对于需要部署儿童语音识别的开发者和产品团队来说,这项研究提供了实用的决策参考:如果主要关注原始识别准确率且使用编码器-解码器架构,双语全量微调是可靠选择;如果希望在不牺牲成人识别能力的前提下提升童声表现,权重空间融合则更值得尝试,并可根据偏好(保留 vs 增益)在 LERP 和 TIES 之间做取舍。
研究团队也公开了代码和模型(托管于 GitHub 的 qcri/Child-ASR-Adaptation 仓库),这为后续研究和工程落地提供了可复现的基础。随着语音交互在教育、儿童陪伴等场景的普及,如何让 ASR 系统真正"听懂孩子",将是一个持续受关注的方向。
相关推荐

LangChain的商业模式还能走多远?LangSmith面临的生存挑战
LangChain的核心营收依赖LangSmith,但AWS Omni等云厂商原生可观测性工具的崛起正在挤压其增长空间。本文分析独立AI开发工具与云原生方案的护城河之争,以及LangChain面临的商业化挑战。

用强化学习在UE5中训练AI钢铁侠:PPO算法救援13名乘客实验
一位开发者在虚幻引擎5中用PPO强化学习算法训练AI钢铁侠,让其学会飞行救援13名下坠乘客。本文解析该体素风格项目的技术思路、PPO选型逻辑与UE5仿真训练的价值与局限。

传奇设计师Richard Garriott重掌《创世纪》系列版权
游戏传奇设计师Richard Garriott正式重新获得经典RPG系列《创世纪》(Ultima)的控制权。本文解读这一版权回归对玩家与游戏行业的潜在意义。